
Коротко (TL;DR)
- Самый маленький файл Mistral Large 4 GGUF весит 233 ГБ (1-битный квант Unsloth), нормальные 4 бита — 605 ГБ, официальный FP8 — 1,06 ТБ (сумма файлов по API Hugging Face на 1 ноября 2026). «52B активных параметров» память не экономит: загружать приходится все ~1T.
- Из готовых компьютеров модель помещается только в Mac Studio M5 Ultra с 512 ГБ — от $22 299 в американском Apple Store (опция открыта 28 октября 2026), и то лишь в 2–3 битах. Остальное — самосборные станции и серверы: четыре RTX PRO 6000 стоят $53–68 тыс. только за карты.
- Единственные замеры скорости сделали соавторы релиза (Hugging Face и llama.cpp): 15 ток/с на Mac Studio M3 Ultra, 30 ток/с на четырёх RTX PRO 6000 на коротком контексте и 3 ток/с на длинном. Независимых замеров на 2 ноября 2026 нет.
- Видеокарта на 24–32 ГБ плюс 64–128 ГБ RAM модель не тянет ни в каком кванте — остаётся чтение весов с SSD со скоростью 1–2 ток/с.
- API дешевле: $0,70 за миллион входных и $2,10 за миллион выходных токенов. По нашему расчёту аренда ноды выходит примерно в 12 раз дороже, а Mac за $22 299 окупался бы больше 15 лет. Локальный запуск — ради данных и контроля, а не ради экономии.
- Обычному ПК подойдёт Qwen 3.8 или меньшие модели Mistral, которые компания пообещала «в течение месяца».
Словарик: MoE, квант, GGUF, KV-кэш и prefill
Без этих пяти слов дальше будет тяжело — по строке на каждое.
- Коротко (TL;DR)
- Словарик: MoE, квант, GGUF, KV-кэш и prefill
- Сколько памяти нужно Mistral Large 4: от 233 ГБ до 1,06 ТБ
- Память Mistral Large 4: файл весов, KV-кэш 35 КиБ на токен и запас
- Mac Studio для Mistral Large 4: 512 ГБ, лимит 384 ГБ и цена $22 299
- Связка GPU и RAM-офлоад: что даёт 4× RTX PRO 6000 и сервер на 768 ГБ
- Сколько ток/с у Mistral Large 4 дома: замеры и потолок по памяти
- Аренда вместо покупки: 4× B200 за $27 в час против API по $2,10
- Mistral Large 4 против Qwen 3.8: 233–605 ГБ против 17,6–397 ГБ
- Лицензия Mistral Large 4 и качество низких квантов: что проверено
- Как запустить Mistral Large 4: llama.cpp, MLX, vLLM и Ollama
- Риски локального запуска Mistral Large 4: что может пойти не так
- Кому Mistral Large 4 нужен локально — и когда лучше подождать
- FAQ
- MoE (смесь экспертов) — модель из множества «подсетей-экспертов», из которых на каждом слове работает только несколько. Считает она быстро, как маленькая, а места занимает как большая: все эксперты должны лежать в памяти.
- Квант — сжатая копия весов: вместо 8 или 16 бит на число — 1–4 бита. Файл меньше в разы, качество немного падает.
- GGUF — формат файлов для llama.cpp и программ на его основе (LM Studio, Llama App). Квант с пометкой UD — «динамический» от Unsloth: важные слои он оставляет точнее, остальные сжимает сильнее.
- KV-кэш — память модели о текущем разговоре. Растёт с длиной контекста.
- Prefill — чтение вашего запроса до первого слова ответа. Генерация — сам ответ. Это две разные скорости, и у больших моделей на слабом железе страдает именно prefill.
Сколько памяти нужно Mistral Large 4: от 233 ГБ до 1,06 ТБ
Mistral Large 4 нужно от 233 ГБ памяти в самом сжатом 1-битном кванте до 1,06 ТБ в официальном FP8, плюс несколько гигабайт на контекст и служебные буферы. Практичная середина — 2-битный квант на 300–380 ГБ. Это ёмкость памяти, которую видит процессор или видеокарта: оперативная, видеопамять или единая память Mac. Диск в счёт не идёт.
Сама модель — MoE на 1,05 трлн параметров, из которых на каждом токене работают 49 млрд (52 млрд вместе со слоями эмбеддингов и выхода). Mistral выложила веса 29 октября 2026 года, оригинал лежит в карточке Mistral-Large-4-1T-A52B на Hugging Face. В сообществе модель прозвали Le Chonk — так назывался и PR с её поддержкой в llama.cpp. Бенчмарки и сравнение с Kimi K3 и GLM-5.3 — в нашем обзоре Mistral Large 4 (он написан до выхода весов: цена и индекс там на 21 октября); здесь только железо.
Размеры ниже — не формулы из статей до релиза, а сумма реальных файлов в репозиториях на 1 ноября 2026 (1 ГБ = 10⁹ байт).

| Формат / квант | Чей | Размер, ГБ | Что это на практике |
|---|---|---|---|
| FP8 (оригинал) | Mistral | 1060,6 | 54 файла; BF16 официально нет |
| NVFP4 | Mistral | 610,0 | только видеокарты Blackwell (B200, B300, RTX PRO 6000) |
| UD-IQ1_S (1 бит) | Unsloth | 233,0 | самый маленький файл |
| UD-IQ1_M | Unsloth | 259,6 | 1 бит чуть точнее |
| IQ2_XXS | ggml-org | 297,7 | 2 бита от команды llama.cpp |
| UD-IQ2_XXS | Unsloth | 302,5 | 2 бита, влезает в Mac без настройки |
| Q2_K | ggml-org | 380,7 | на нём сделан замер на Mac |
| UD-Q2_K_XL | Unsloth | 378,3 | пример в инструкции Unsloth |
| UD-IQ3_XXS | Unsloth | 423,5 | 3 бита |
| UD-Q3_K_XL | Unsloth | 492,7 | 3 бита, на Mac — впритык с поднятым лимитом |
| UD-Q4_K_XL | Unsloth | 604,8 | 4 бита |
| Q4_K_M | ggml-org | 634,8 | другой 4-битный рецепт |
| UD-Q5_K_XL / UD-Q6_K_XL / Q8_0 | Unsloth | 783,8 / 890,5 / 1115,2 | серверный класс |
| MLX Text 2 / 3 / 4 бита | mlx-community | 338,2 / 459,3 / 590,4 | для Mac, только текст |
| mmproj (зрение) | ggml-org | 3,4 | отдельный файл, если нужны картинки |
Две ловушки чтения таких таблиц:
- Таблица требований Unsloth («1 бит — 256–270 ГБ, 4 бита — 630 ГБ, 8 бит — 1,2 ТБ») показывает память с запасом под контекст, а не вес файла. С таблицей выше она не спорит.
- Q4_K_M и UD-Q4_K_XL — разные кванты с разницей в 30 ГБ. В статьях, написанных до выхода весов, «Q4 ≈ 635 ГБ» — это оценка, а не файл.
Память Mistral Large 4: файл весов, KV-кэш 35 КиБ на токен и запас
Полная потребность в памяти считается так: файл весов + KV-кэш под выбранный контекст + mmproj (3,4 ГБ, если нужны картинки) + служебные буферы движка (обычно 5–10 ГБ). Если система ещё работает на этой же машине, как на Mac, ей тоже нужен свой кусок.
KV-кэш у Mistral Large 4 маленький, и это не случайность. Модель использует MLA (сжатое внимание): вместо полного набора ключей и значений каждый слой хранит латентный вектор на 512 чисел плюс 64 числа позиционной части. К тому же часть слоёв делит кэш с соседями: свой хранят 63 из 72.
Наш расчёт по config.json: 63 слоя × (512 + 64) × 1 байт в FP8 = 36 288 байт на токен, около 35 КиБ. Тот же порядок независимо получил японский разработчик oflight (36 КБ на токен). В f16 — вдвое больше.Контекст KV в FP8 (как в vLLM) KV в f16 (те же 63 слоя) 8 тыс. токенов 0,28 ГиБ 0,55 ГиБ 32 тыс. 1,11 ГиБ 2,21 ГиБ 128 тыс. 4,43 ГиБ 8,86 ГиБ 256 тыс. 8,86 ГиБ 17,7 ГиБ 1 млн 35,4 ГиБ 70,9 ГиБ
Как именно llama.cpp хранит общий для слоёв кэш, в документации не сказано. Если общий кэш не используется вовсе, 128 тыс. токенов в f16 займут около 10 ГиБ. Это худший вариант, и даже он в 20 раз меньше самого маленького файла. Общий принцип расчёта мы разбирали в материале сколько видеопамяти нужно модели.
Вывод: у этой модели всё решает файл весов. Окно в 1 млн токенов по памяти доступно почти бесплатно, но скорость на длинном контексте падает в разы — об этом ниже.
Какой квант Mistral Large 4 влезает в Mac, GPU и сервер
Наш расчёт, правило: файл + KV на 32 тыс. токенов в f16 (2,4 ГБ) + 10 ГБ буфера не больше доступной памяти. Всё приведено к десятичным ГБ, как у файлов.
| Конфигурация | Доступно, дес. ГБ | Самый крупный квант, который влезает |
|---|---|---|
| Mac Studio M5 Ultra 512 ГБ, лимит GPU по умолчанию | ~412 | Q2_K (380,7) — впритык |
| То же, лимит поднят командой sysctl | ~507 | UD-IQ3_XXS (423,5) с запасом, UD-Q3_K_XL (492,7) впритык |
| 4× DGX Spark | ~550 | UD-Q3_K_XL на бумаге; узлам нужна память под систему |
| 4× RTX PRO 6000 | ~412 VRAM | Q2_K впритык, IQ2_XXS с запасом |
| 1 видеокарта на 32 ГБ + 256 ГБ RAM | ~309 | только 1 бит (233 / 260) |
| 1 видеокарта на 32 ГБ + 512 ГБ RAM | ~584 | UD-Q3_K_XL (492,7) |
| 1 видеокарта на 32 ГБ + 768 ГБ RAM | ~859 | UD-Q5_K_XL (783,8); 4 бита и NVFP4 с запасом |
| 4× B200 | от 720 | NVFP4 — конфигурация, которую называет Mistral |
| 8× H200 | от 1128 | FP8 с запасом |
| RTX 4090/5090 + 64–128 ГБ RAM | ~95–172 | ничего: остаётся чтение с SSD |
Память Mac и видеокарт двоичная: 384 ГБ в macOS ≈ 412 ГБ в единицах таблицы.
Mac Studio для Mistral Large 4: 512 ГБ, лимит 384 ГБ и цена $22 299
Mac Studio с 512 ГБ — единственный готовый компьютер из магазина, на котором Mistral Large 4 запускается без сборки станции или сервера. Но у него три оговорки, которые в пересказах теряются.
Первая: замер сделан на машине, которую уже не продают. Команда Hugging Face и llama.cpp запустила Q2_K на Mac Studio M3 Ultra с 512 ГБ и получила около 90 ток/с на prefill и 15 ток/с на генерации (блог Hugging Face, 29 октября 2026). Опцию 512 ГБ для M3 Ultra Apple убрала ещё в марте 2026 года. Что эта машина умела с другими гигантами, мы разбирали в статье о Mac Studio M3 Ultra.
Вторая: 512 ГБ вернулись на M5 Ultra и стоят дорого. С 28 октября 2026 года Mac Studio M5 Ultra можно собрать с 512 ГБ единой памяти: $6 799 за базовую конфигурацию с 36-ядерным CPU и 80-ядерным GPU плюс $15 500 за память, итого от $22 299 в США без налогов (MacRumors). Пропускная способность памяти — 1,2 ТБ/с. Сроки поставки на 2 ноября не подтверждены: одни издания пишут о декабре, другие — что машины уже отгружаются.
Третья: macOS не отдаёт видеоядру всю память. По умолчанию GPU получает лишь часть ОЗУ. Apple эту долю не публикует; по наблюдениям сообщества, это от двух третей до трёх четвертей. На 512 ГБ это около 384 ГБ в единицах macOS. Они двоичные, поэтому в десятичных единицах, в которых указаны файлы, это около 412 ГБ. Q2_K (380,7 ГБ) с контекстом 32 тыс. и буферами занимает ~393 ГБ и помещается впритык, а для 3 бит лимит придётся поднимать.
Лимит поднимается командой. Порядок такой:
- Проверить текущее значение:
sysctl iogpu.wired_limit_mb(0 означает «по умолчанию»). - Поднять до 472 ГБ в единицах macOS (~507 ГБ десятичных):
sudo sysctl iogpu.wired_limit_mb=483328. Это значение предлагает Pinggy в гайде по M5 Ultra; системе остаётся около 40 ГБ. - Закрыть всё лишнее: браузер с десятком вкладок съест запас, и машина начнёт подвисать.
- Вернуть как было:
sudo sysctl iogpu.wired_limit_mb=0или просто перезагрузка — настройка не сохраняется.
| Mac Studio | Память | Цена | Что запустится | Скорость генерации |
|---|---|---|---|---|
| M3 Ultra 512 ГБ | 819 ГБ/с | с марта 2026 новым не купить | Q2_K | 15 ток/с (замер HF) |
| M5 Ultra 512 ГБ | 1,2 ТБ/с | от $22 299 (28.10.2026) | до Q2_K сразу, до UD-Q3_K_XL с sysctl (впритык) | ~20–24 ток/с (наша оценка) |
| M5 Ultra 256 ГБ и меньше | — | дешевле | ничего, кроме чтения с SSD | 1–2 ток/с (по Pinggy) |
Оценка для M5 Ultra — не замер: мы умножили 15 ток/с на 1,3–1,6. Нижняя граница — прирост M5 Ultra над M3 Ultra в генерации по оценке BGR (30–40%). В нашем разборе Mac Studio M5 Ultra прирост на других моделях составил 1,5–1,9 раза, поэтому реальная цифра может оказаться и выше. Замера Large 4 на M5 Ultra на 2 ноября нет ни у кого.
Связка GPU и RAM-офлоад: что даёт 4× RTX PRO 6000 и сервер на 768 ГБ
Без Mac остаётся два пути: собрать много видеопамяти из нескольких карт или держать экспертов в оперативной памяти сервера, а на видеокарте — только внимание. Первый путь быстрее, второй дешевле за гигабайт и медленнее.
Четыре RTX PRO 6000 (по 96 ГБ, всего 384 ГБ — около 412 ГБ в десятичных единицах). Это конфигурация из того же блога Hugging Face. IQ2_XXS (297,7 ГБ) помещается в видеопамять целиком: на коротком контексте вышло 500 ток/с prefill и 30 ток/с генерации. Когда контекст длинный (сервер запускали с окном 800 тыс. токенов), скорость падает до 129 и 3 ток/с. NVFP4 (610 ГБ) в эту видеопамять не помещается — часть весов пришлось держать вне видеопамяти, отсюда около 10 ток/с генерации при контексте 32 тыс. Это наш вывод по арифметике: способ размещения источник не описывает. Q2_K (380,7 ГБ) с контекстом 32 тыс. по нашему расчёту помещается впритык; замера на нём у HF для этой связки нет.
Цена связки на 1 ноября 2026: RTX PRO 6000 в американской рознице — от $17 063 (GPUPrix), на витрине Nvidia — $13 250, но не в наличии. Четыре карты — $53–68 тыс. без сервера, блоков питания и охлаждения.
Сервер с большим объёмом RAM. llama.cpp умеет держать редко используемые веса экспертов в оперативной памяти, а внимание — на видеокарте (флаги --n-cpu-moe N или --override-tensor "\.ffn_.*_exps\.weight=CPU"). Ёмкость тогда задаёт RAM, а скорость — её пропускная способность. На Mac этот трюк не нужен: там процессор и графика читают одну и ту же память.
Замеров Large 4 на CPU нет. Ближайший прокси — Kimi-K2.5, тоже MoE на ~1T параметров, но с 32 млрд активных против 52 млрд у Mistral. На сервере с EPYC 9175F и 768 ГБ DDR5-6400 она в Q4_K_S выдала 11,7–12,9 ток/с генерации и 22–24 ток/с prefill (замер одной частной лаборатории, октябрь 2026). Наша оценка для Large 4 в 4 битах — 7–8 ток/с (12 × 32/52). Prefill той же пропорцией — около 13–15 ток/с (у Kimi 22–24), то есть запрос на 20 тыс. токенов модель будет читать около 25 минут.
Память для такого сервера дорожает: по розничному индексу DatacenterDisk серверная DDR5 стоит около $44 за ГБ, то есть 768 ГБ — порядка $34 тыс. Индекс собран из розничных объявлений, это ориентир, а не прайс.
Четыре DGX Spark. У каждого 128 ГБ и 273 ГБ/с, четыре в связке — максимум, который поддерживает Nvidia, — дают 512 ГБ, или около 550 ГБ в десятичных единицах. На бумаге это вмещает UD-Q3_K_XL, но каждому узлу ещё нужна память под систему. Замеров Large 4 на такой связке нет; наше сравнение DGX Spark, Mac Studio и Strix Halo показывает, где Spark упирается в память на моделях поменьше.Вариант Память Цена (дата) Квант Генерация Mac Studio M5 Ultra 512 ГБ 384–472 ГБ для GPU (~412–507 дес.) от $22 299 (28.10.2026) 2–3 бита ~20–24 ток/с (оценка) 4× RTX PRO 6000 384 ГБ VRAM (~412 дес.) $53–68 тыс. за карты (01.11.2026) IQ2_XXS, Q2_K впритык 30 → 3 ток/с (замер HF) EPYC + 768 ГБ DDR5 + 1 GPU ~859 ГБ дес. только память ~$34 тыс. (индекс) 4–5 бит ~7–8 ток/с (оценка по прокси) 4× DGX Spark 512 ГБ (~550 дес.) н/д до 3 бит замеров нет ПК: RTX 5090 + 128 ГБ RAM ~172 ГБ дес. — не влезает 1–2 ток/с с SSD
Сколько ток/с у Mistral Large 4 дома: замеры и потолок по памяти
Дома Mistral Large 4 генерирует от 3 до 30 ток/с, и единственные цифры на 2 ноября 2026 года — от соавторов релиза. На Mac Studio M3 Ultra это 15 ток/с, на четырёх RTX PRO 6000 — 30 ток/с на коротком контексте и 3 на длинном. Независимых замеров ни на Mac, ни на DGX Spark, ни на CPU пока нет.Конфигурация Квант Prefill, ток/с Генерация, ток/с Откуда цифра Mac Studio M3 Ultra 512 ГБ Q2_K ~90 15 замер HF и llama.cpp Mac Studio M5 Ultra 512 ГБ Q2_K н/д ~20–24 наша оценка 4× RTX PRO 6000 IQ2_XXS, короткий контекст 500 30 замер HF 4× RTX PRO 6000 IQ2_XXS, длинный контекст 129 3 замер HF 4× RTX PRO 6000 NVFP4, 32 тыс. 130–590 ~10 замер HF 8× H200, vLLM, FP8 один запрос 1 тыс. токенов за ~0,6 с ~65; 120–138 только на чат-запросах с принятыми черновиками DSpark замер HF 8× H200, vLLM, FP8 1000 диалогов разом — ~480 суммарно замер HF EPYC 9175F + 768 ГБ Q4 (прокси Kimi-K2.5) ~13–15 для Large 4 (у Kimi 22–24) ~7–8 для Large 4 (у Kimi 11,7–12,9) наша оценка по прокси
DSpark — встроенная в модель «черновая» голова: она угадывает несколько следующих токенов, основная модель их проверяет, и при удачном угадывании генерация ускоряется. В vLLM её включают флагом --speculative-config в специальном образе vLLM — команда есть в разделе о запуске.
Потолок скорости можно посчитать. На каждом токене модель читает из памяти только активные веса — примерно файл × 52/1050. Для UD-Q2_K_XL (378,3 ГБ) это около 18,7 ГБ на токен, у Q2_K почти столько же. Делим пропускную способность памяти на это число:
- M3 Ultra (819 ГБ/с) — не больше 44 ток/с; замер 15 ток/с — это около 35% потолка;
- M5 Ultra (1,2 ТБ/с) — не больше 64 ток/с;
- EPYC с 12 каналами DDR5-6400 (~614 ГБ/с) — не больше 33;
- один DGX Spark (273 ГБ/с) — не больше 15;
- обычный ПК с двухканальной DDR5 (~90 ГБ/с) — не больше 5.
Это грубая верхняя граница: кванты разных слоёв весят по-разному, а реальные движки теряют часть скорости на вычислениях и синхронизации. Но порядок она показывает верно: ёмкость памяти решает, загрузится ли модель, а пропускная способность — насколько быстро она будет отвечать.
Рассуждение отключить нельзя. У модели три уровня reasoning_effort — low, medium и high (по умолчанию). Значение none всё равно работает как high. При 15 ток/с короткий ответ с цепочкой рассуждений на тысячу-другую токенов занимает минуты, поэтому начинать стоит с low.
Цифра, которой в таблице нет. В статье Context Studios, вышедшей до релиза весов, стоит «23 ток/с на кластере из четырёх DGX Spark». Но сервер там запущен с моделью qwen3.8-flash-next — это замер другой модели, к Mistral Large 4 он не относится.
Аренда вместо покупки: 4× B200 за $27 в час против API по $2,10
Арендовать ноду под Mistral Large 4 можно за $10–42 в час, но по деньгам это всё равно дороже API — в разы. Аренда имеет смысл в двух случаях: проверить свою задачу перед покупкой железа или держать данные на собственном сервере, а не у Mistral.Нода Цена GPU·час За час Что держит 4× RTX PRO 6000 (Runpod) $2,49 ~$9,96 IQ2_XXS, Q2_K впритык 4× B200 (Lambda) $6,79 ~$27,16 NVFP4 — официальная конфигурация 4× B200 (Runpod) $7,99 ~$31,96 NVFP4 8× H200 (Runpod) $5,29 ~$42,32 FP8 целиком
Цены Runpod — со страницы, обновлённой 28 октября 2026 года, Lambda — на 1 ноября 2026 (даты на странице нет). API Mistral Large 4 после выхода весов стоит $0,70 за миллион входных токенов, $2,10 за миллион выходных и $0,07 за кэшированный вход (Artificial Analysis, 1 ноября 2026). До открытия весов тариф был $1,36 / $4,18.
Наш расчёт безубыточности. Нода из четырёх B200 за $27,16 в час сравняется с API по выходным токенам, только если выдаёт 12,9 млн токенов в час — около 3 600 ток/с без перерыва. На замере Hugging Face восемь H200 под нагрузкой в 1000 диалогов выдали ~480 ток/с суммарно. За $42,32 в час это около $24,5 за миллион выходных токенов — примерно в 12 раз дороже API. Входные токены, простой и электричество в расчёт не входят, и все они делают аренду ещё дороже.
Покупка Mac тоже не окупается деньгами. $22 299 — это 10,6 млрд выходных токенов по цене API. При 20 ток/с без остановки Mac выдаёт 1,7 млн токенов в сутки, и столько токенов он нагенерирует лет за 17 (наш расчёт; электричество и входные токены не учтены).
Вывод: Mistral Large 4 у себя запускают ради того, чтобы запросы не уходили за периметр компании, ради работы без интернета и фиксированной версии модели. Если ничего из этого не нужно, API выигрывает. Сравнение площадок и скрытых платежей — в гайде по аренде GPU для нейросетей. Разумный порядок — сначала арендовать ноду на выходные и прогнать свою задачу, потом решать с покупкой.
Mistral Large 4 против Qwen 3.8: 233–605 ГБ против 17,6–397 ГБ
Главный соперник среди открытых моделей — семейство Qwen 3.8. Разница по железу — на порядок: у Qwen есть модели, которые запускаются на одной видеокарте, а у Mistral в этом поколении есть пока только Large 4.Модель Параметров всего / активных Файл в 1 бите Файл в 4 битах Лицензия Qwen 3.8 27B 27B, плотная 6,2 ГБ 17,6 ГБ Apache 2.0 Qwen 3.8 Flash-Next ~125–180B (считают по-разному) / н/д 72,5 ГБ 111,3 ГБ собственная Mistral Large 4 1,05T / 52B 233 ГБ 605 ГБ Mistral Ecosystem Open-Weight Qwen 3.8 2.4T-A95B 2,45T / 95B 397 ГБ 1,31 ТБ (IQ4_XS) собственная
Файлы — GGUF от Unsloth по API Hugging Face, 4 бита — UD-Q4_K_XL, если не указано иное.
По качеству Mistral Large 4 (режим high) набирает 26 баллов в Intelligence Index v5 от Artificial Analysis, Qwen 3.8 27B (xhigh) — 20 (на 1 ноября 2026). У Flash-Next индекса на этой шкале пока нет. Сравнивать можно только числа одной версии шкалы: превью Large 4 получало 38 по прежней методике, и это не значит, что модель «стала хуже».
Как это читать:
- Одна видеокарта на 24–32 ГБ — Qwen 3.8 27B, без вариантов.
- 128 ГБ единой памяти или ПК со 128 ГБ RAM — Qwen 3.8 Flash-Next локально; её запускают у себя несколько участников обсуждения релиза на Hacker News.
- 512 ГБ и больше — Large 4 в 2–3 битах или Qwen 3.8 2.4T в 1 бите. Второй вариант требует в 1,7 раза больше памяти при той же «битности».
Шесть баллов разницы с 27B стоят 200–600 ГБ памяти против 17,6 ГБ. Для чата и простого кода это переплата. Для сложных агентных задач и анализа длинных документов внутри компании — уже нет.
Лицензия Mistral Large 4 и качество низких квантов: что проверено
Лицензия. Large 4 вышла под собственной Mistral Ecosystem Open-Weight License, а не под Apache 2.0, как Large 3. Главное в ней:
- Коммерческое использование разрешено.
- Пункт 2: если вы или аффилированная компания продаёте модель как сервис (Model as a Service — даёте третьим лицам доступ к модели через API или хостинг с контролем над запросами, параметрами или обучением), для коммерческого использования нужна отдельная лицензия от Mistral.
- Встроенный продукт — не MaaS: функция внутри своего приложения или простая пересылка запросов к чужой модели под это определение не подпадают.
- Пункт 3: условия пункта 2 не касаются внутреннего использования (модель не открыта третьим лицам) и доступа через официальные продукты Mistral. Текст лицензии лежит в репозитории модели.
На локальный запуск дома или внутри компании оговорка про MaaS не распространяется. Хостинг-провайдерам и сервисам «модель по API» придётся договариваться с Mistral. Из-за этой оговорки на Hacker News спорят, можно ли называть релиз open source: формально это open weights, но не открытая лицензия в смысле OSI.
Качество низких квантов. Данные есть только у Unsloth — то есть у компании, которая эти кванты делает. Это заявления вендора, а не независимый тест.Квант Размер Совпадение top-1 с оригиналом KLD (меньше — ближе к оригиналу) UD-IQ1_S 233,0 ГБ 90,6% 0,1263 UD-Q2_K_XL 378,3 ГБ 95,6% 0,0298 UD-IQ3_XXS 423,5 ГБ 96,2% 0,0217 UD-Q4_K_XL 604,8 ГБ 97,8% 0,0071
«Совпадение top-1» — доля токенов, где сжатая модель выбирает то же слово, что и оригинал. Это не оценка качества кода или рассуждений: 9% расхождений в 1-битном кванте на длинном ответе накапливаются. Независимых тестов 1- и 2-битных квантов на задачах программирования на 1 ноября 2026 нет. Поэтому 1 бит — это способ запустить модель, а не «почти без потерь».
Как запустить Mistral Large 4: llama.cpp, MLX, vLLM и Ollama
Поддержку Mistral Large 4 влили в llama.cpp в день релиза — PR #31376, 29 октября 2026 года. Сборки старше этой даты модель не откроют. Ниже — команды из инструкций Unsloth и Hugging Face; адаптированы под Linux с видеокартой NVIDIA, на Mac отличается только сборка.
Шаг 1. Выбрать квант Mistral Large 4 под свою память
Сверьтесь с таблицей «что влезает». На Mac Studio 512 ГБ без настройки — до Q2_K впритык (контекст лучше держать скромным), с поднятым лимитом — UD-IQ3_XXS с запасом или UD-Q3_K_XL впритык. На машине с одной видеокартой и 768 ГБ RAM — UD-Q4_K_XL с запасом, максимум UD-Q5_K_XL. Учтите диск: 300–600 ГБ на один квант.
Шаг 2. Собрать свежий llama.cpp
sudo apt-get update
sudo apt-get install -y build-essential cmake curl libcurl4-openssl-dev
git clone https://github.com/ggml-org/llama.cpp
cmake llama.cpp -B llama.cpp/build -DBUILD_SHARED_LIBS=OFF -DGGML_CUDA=ON
cmake --build llama.cpp/build --config Release -j --target llama-cli llama-server
Для Mac или запуска только на процессоре — -DGGML_CUDA=OFF, Metal на macOS включается сам.
Шаг 3. Скачать квант и запустить сервер
./llama.cpp/build/bin/llama-server \
    -hf unsloth/Mistral-Large-4-1T-A52B-GGUF:UD-Q2_K_XL \
    --ctx-size 32768 \
    --temp 1.0 --top-p 0.95 --top-k 0 --min-p 0.0 \
    --chat-template-kwargs '{"reasoning_effort":"low"}' \
    --host 127.0.0.1 --port 8080
Чат откроется по адресу 127.0.0.1:8080, OpenAI-совместимый API — там же, по пути /v1. Контекст 32 тыс. ограничивает KV-кэш. Unsloth в примере ставит reasoning_effort в high; мы ставим low, потому что на домашнем железе high растягивает ответ на минуты. Не хватает памяти — уменьшите --ctx-size или возьмите квант меньше.
Скачать квант заранее (9 файлов, держать в одной папке):
pip install -U huggingface_hub
hf download unsloth/Mistral-Large-4-1T-A52B-GGUF \
    --local-dir unsloth/Mistral-Large-4-1T-A52B-GGUF \
    --include "UD-Q2_K_XL/*"
Тот же запуск через Llama App с квантом команды llama.cpp — одна строка: llama serve -hf ggml-org/Mistral-Large-4-1T-A52B-GGUF:Q2_K.
Шаг 4. Mac: GGUF или MLX
На Mac работают оба пути. GGUF через llama.cpp — тот, на котором сделан замер Hugging Face. MLX-конверсии от mlx-community (2, 3 и 4 бита: 338,2 / 459,3 / 590,4 ГБ) появились в день релиза, но они только текстовые, и качество их никто не мерил. Конверсии сделаны веткой mlx-lm с PR #2018 и проверены на dev-сборке 0.32.3; если релиз из pip модель не открывает — ставьте mlx-lm из GitHub.
Шаг 5. Серверы на Blackwell: vLLM
vLLM обслуживает NVFP4 и FP8, а на 1 ноября 2026 года работает только из специального образа vllm/vllm-openai:mistral-large-4 — ни релиз, ни ночная сборка поддержки ещё не содержат. Базовая конфигурация рецепта vLLM — четыре GB300:
export VLLM_ENGINE_READY_TIMEOUT_S=6000
vllm serve mistralai/Mistral-Large-4-1T-A52B-NVFP4 \
  --tokenizer-mode mistral --config-format mistral --load-format mistral \
  --max-model-len 262144 --tensor-parallel-size 4 \
  --gpu-memory-utilization 0.85 \
  --reasoning-parser mistral --tool-call-parser mistral --enable-auto-tool-choice \
  --speculative-config '{"method":"dspark","num_speculative_tokens":3}'
Ollama и Mistral Large 4: пока только облачный тег
На странице Mistral Large 4 в библиотеке Ollama на 1 ноября 2026 виден только тег mistral-large-4:cloud — это запуск в облаке Ollama, а не на вашем железе. Локально пока используйте llama.cpp или программы на его основе.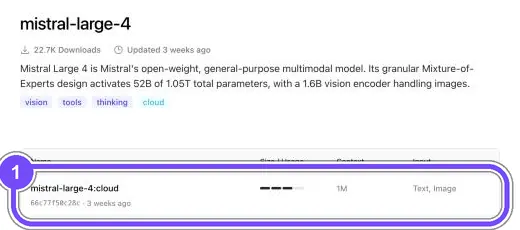
Ollama, страница тегов mistral-large-4, 2 ноября 2026: 1 — единственный тег — облачный :cloud, локальной версии пока нет.
Риски локального запуска Mistral Large 4: что может пойти не так
- Подвисания Mac после поднятия лимита. Если GPU забрал 472 из 512 ГБ, системе остаётся ~40 ГБ. Тяжёлый браузер или IDE — и macOS начинает выгружать память на диск.
- Обвал скорости на длинном контексте. Замер HF: 30 ток/с на коротком запросе и 3 ток/с на длинном. Окно в 1 млн токенов по памяти доступно, но работать с ним на домашнем железе мучительно.
- Prefill на CPU. При ~13–15 ток/с (наша оценка) чтение большого документа или кодовой базы занимает десятки минут. Для агентов, которые постоянно отправляют длинный контекст, это неприемлемо.
- Качество 1–2 бит подтверждает только вендор квантов. Сравните ответы с API на своих задачах до того, как строить на этом процессы.
- Чтение с SSD вместо памяти. Если модель не помещается, llama.cpp подгружает веса с диска через mmap. По опыту Pinggy, это 1–2 ток/с — для чата бесполезно, а SSD постоянно нагружается чтением.
- Скачивание и диск. 300–600 ГБ на квант, плюс место на эксперименты с двумя-тремя вариантами. Берите файлы только из официальных репозиториев (mistralai, unsloth, ggml-org, mlx-community).
- Цифры из статей до релиза. Оценки «Q4 ≈ 635 ГБ», «NVFP4 = 525 ГБ», «23 ток/с на DGX Spark» не совпадают с реальными файлами или относятся к другой модели.
Кому Mistral Large 4 нужен локально — и когда лучше подождать
Mistral Large 4 нужен локально тем, кому нельзя отправлять данные во внешний API и у кого уже есть или будет сервер от 400 ГБ памяти. Энтузиасту дешевле всего — через Mac Studio за $22 299, в 2–3 битах. Обычному ПК он не нужен вовсе: там работает Qwen 3.8.Профиль Что делать Компания с чувствительными данными и бюджетом на сервер Арендовать 4× B200 на тест, затем своя нода на NVFP4 или FP8 через vLLM Энтузиаст с бюджетом от $22 тыс. Mac Studio M5 Ultra 512 ГБ, Q2_K, с поднятым лимитом — 3 бита, ~20 ток/с (оценка) Есть сервер с 512–768 ГБ RAM Офлоад экспертов в RAM, 3–5 бит, 7–8 ток/с (оценка), короткие запросы Обычный ПК, одна видеокарта Qwen 3.8 27B или Flash-Next; Large 4 — через API
Пять вопросов перед покупкой железа:
- Нельзя ли данным уходить в облако? Если можно — API за $0,70/$2,10 дешевле любого варианта.
- Нужен ли длинный контекст? На локальном железе он медленный: 3 ток/с на замере HF.
- Будут ли агенты с длинными промптами? Тогда решает prefill, и CPU-сервер отпадает.
- Какой бюджет? Порог входа — $22 299 за Mac или $50 тыс.+ за связку видеокарт.
- Можно ли подождать месяц? На брифинге 28 октября 2026 года вице-президент Mistral по науке Пьер Сток пообещал «в течение месяца» семейство моделей поменьше, и одна из них, по его словам, точно запустится на ноутбуке (Frandroid). Размера, даты и лицензии пока нет, в официальном анонсе этого обещания тоже нет.
Быстрее всего устареют цены Mac, видеокарт и памяти, тарифы аренды и сами файлы квантов: Unsloth и ggml-org обновляют репозитории. Свежие размеры смотрите в карточке модели на Hugging Face, свежие цены — на страницах Apple и облаков.
FAQ
Можно ли запустить Mistral Large 4 на одной RTX 5090 или 4090?
Нет, в нормальном режиме — нет. Даже самый маленький квант весит 233 ГБ, а у RTX 5090 32 ГБ видеопамяти. С 64–128 ГБ оперативной памяти вместе всё равно не хватает, и llama.cpp будет читать веса с SSD — это 1–2 ток/с. Для одной такой видеокарты лучше подходит Qwen 3.8 27B: в 4 битах она весит 17,6 ГБ.
Хватит ли Mac Studio на 512 ГБ для Mistral Large 4?
Хватит, но только в 1–3 битах. По умолчанию macOS отдаёт видеоядру около 384 ГБ (≈412 ГБ в десятичных единицах файлов) — этого хватает на Q2_K (380,7 ГБ) впритык. Если поднять лимит командой sysctl до 472 ГБ, влезут UD-IQ3_XXS и впритык UD-Q3_K_XL. Замер на M3 Ultra в Q2_K — 15 ток/с; новые M5 Ultra с 512 ГБ стоят от $22 299 в США.
Сколько оперативной памяти нужно, чтобы запустить Mistral Large 4 без видеокарты?
Для 1 бита — не меньше 256 ГБ, для 2 бит — около 384 ГБ, для 4 бит — 768 ГБ. Скорость задаёт пропускная способность памяти: на обычном ПК с двухканальной DDR5 потолок около 5 ток/с. На серверном EPYC с 12 каналами DDR5 наша оценка — 7–8 ток/с в 4 битах, а prefill — около 13–15 ток/с.
Где скачать Mistral Large 4 и какой формат выбрать — FP8, NVFP4 или GGUF?
Все официальные файлы лежат на Hugging Face в репозитории mistralai/Mistral-Large-4-1T-A52B. FP8 (1,06 ТБ) — для серверов на 8 GPU, NVFP4 (610 ГБ) — для видеокарт Blackwell через vLLM. Для Mac и домашних систем нужен GGUF: от unsloth (233–1115 ГБ) или ggml-org (297,7–634,8 ГБ), он запускается в llama.cpp.
Чем Mistral Large 4 отличается от Qwen 3.8 по требованиям к железу?
На порядок. Qwen 3.8 27B в 4 битах весит 17,6 ГБ и работает на одной видеокарте, Flash-Next — 111 ГБ, это машина со 128 ГБ памяти. Mistral Large 4 начинается с 233 ГБ в 1 бите. В индексе Artificial Analysis v5 Large 4 набирает 26 баллов, Qwen 3.8 27B — 20 (1 ноября 2026).
Можно ли использовать Mistral Large 4 в коммерческом проекте?
Да, лицензия Mistral Ecosystem Open-Weight это разрешает, в том числе внутри компании: оговорка про MaaS на это не распространяется. Отдельная лицензия от Mistral нужна, только если вы продаёте доступ к самой модели как сервис — через API или хостинг, где клиенты управляют запросами и параметрами. Функция внутри своего приложения сервисом не считается.