Коротко (TL;DR)
Запустить LLM на Raspberry Pi 5 можно без всяких ускорителей: процессор платы сам выдаёт 8–11 токенов в секунду на моделях 1–1,5 млрд параметров. Дополнительная плата AI HAT+ 2 с нейропроцессором Hailo-10H эту скорость не поднимает, а на тех же моделях даже снижает. Её польза в другом: она экономит ватты, освобождает процессор и берёт на себя камеру и голос.
- Коротко (TL;DR)
- Raspberry Pi 5 без ускорителя: какие LLM тянет и с какой скоростью
- AI HAT+ 2 на Hailo-10H: что внутри, сколько стоит и какие модели есть
- AI HAT+ 2 против процессора Pi 5: почему ускоритель медленнее
- Где AI HAT+ 2 оправдан: зрение, VLM, голос и экономия ватт
- Старые AI HAT+ и AI Kit на Hailo-8: только зрение, без LLM
- Сборка Raspberry Pi 5 под LLM: комплектующие и итоговая цена
- Pi 5, Jetson Orin Nano Super и мини-ПК на N150: цена и скорость
- Риски AI HAT+ 2 и Pi 5: контекст, качество моделей, цены
- Когда Raspberry Pi 5 для LLM мало и куда переходить дальше
- FAQ
- Голый Pi 5 на 8 ГБ — рабочий вариант для моделей 1–2B: около 10 tok/s у Qwen2.5 1.5B, 4,6 tok/s у Llama 3.2 3B и меньше 2 tok/s у моделей на 7–8B (замеры 2026 года, подробности ниже).
- AI HAT+ 2 (Hailo-10H, 8 ГБ своей памяти) в трёх независимых тестах генерирует текст медленнее процессора Pi 5. Причина — одинаковая по скорости память у платы и у ускорителя.
- Где HAT оправдан: камера с распознаванием, модели «картинка + текст» (VLM), голосовые команды, питание от аккумулятора. Сборка с ним потребляет 7–7,6 Вт против 10–12 Вт у процессора.
- Деньги на 15 ноября 2026 года: Pi 5 8 ГБ стоит $175, AI HAT+ 2 — $200, вместе с блоком питания, кулером и картой памяти выходит около $440. Медианная цена мини-ПК на Intel N150 с 16 ГБ — $349, и он генерирует примерно вдвое быстрее.
- Когда Pi мало: нужны модели 7B и выше или длинные документы — смотрите мини-ПК, Jetson или Mac.
Raspberry Pi 5 без ускорителя: какие LLM тянет и с какой скоростью
Raspberry Pi 5 — одноплатный компьютер на процессоре Broadcom BCM2712 с оперативной памятью LPDDR4X-4267 объёмом от 1 до 16 ГБ. Для локальной нейросети ему не нужно ничего, кроме Ollama или llama.cpp: это программы, которые скачивают модель в формате GGUF и запускают её на процессоре.
Скорость генерации меряют в токенах в секунду (tok/s). Токен — кусок слова, в русском тексте он короче слова. По оценке японского блога замеров ai-local-lab, 7–10 tok/s уже успевают за чтением про себя. Модели почти всегда запускают в квантованном виде: Q4_K_M означает, что веса сжаты примерно до 4 бит, и модель занимает около 0,6–0,7 ГБ на миллиард параметров.Модель (квантование) Pi 5, процессор, tok/s Кто мерил, на чём, когда Gemma 3 1B (Q4_K_M) 10,84 ai-local-lab, Pi 5 8 ГБ, Ollama 0.24.0, 16.06.2026 Qwen2.5 1.5B (Q4_K_M) 10,62 ai-local-lab, Pi 5 8 ГБ, Ollama 0.24.0, 16.06.2026 Gemma 4 E2B 9 (LiteRT-LM) / 4 (llama.cpp, Q4_0) Google в блоге Raspberry Pi, Pi 5 8 ГБ, август 2026 Llama 3.2 1B (Q8_0) 7,77 ai-local-lab, Pi 5 8 ГБ, 23.06.2026 Qwen3 1.7B (Q4_K_M) 7,67 ai-local-lab, Pi 5 8 ГБ, 16.06.2026 Llama 3.2 3B 4,61 (8 ГБ) / 4,88 (16 ГБ) Джефф Гирлинг, ai-benchmarks, Ollama Gemma 3 4B (Q4_K_M) 3,59 ai-local-lab, Pi 5 8 ГБ, 23.06.2026 Ministral 3 8B (Q4_K_M) 1,96 ai-local-lab, Pi 5 8 ГБ, Ollama 0.31.1, 02.07.2026 DeepSeek R1 14B 1,20 (только 16 ГБ) Джефф Гирлинг, ai-benchmarks Qwen3-30B-A3B (MoE, Q3_K_S-2.70bpw) 8,03 (только 16 ГБ) заявка ByteShape, 05.01.2026; запуск подтвердил Гирлинг
Из таблицы видно главное правило: скорость падает почти пропорционально размеру модели. Отсюда практический выбор — какую LLM-модель ставить на Raspberry Pi под задачу:
- 0,2–1,5B — команды умного дома, короткие ответы, классификация текста. Скорость 8–11 tok/s, у сверхмалой LFM2.5 на 230 млн параметров — до 44 tok/s. Ответ приходит быстрее, чем вы его прочтёте.
- 3–4B — заметно умнее, но 2–5 tok/s. Подходит, когда ответ короткий или его не ждут в реальном времени.
- 7–8B — меньше 2 tok/s. Модель запускается, но абзац текста пишется минуту. Продавцы готовых комплектов иногда обещают «7B на Pi 5 8 ГБ» — это правда только в смысле «запускается».
Какую модель выбрать по качеству, а не только по скорости, мы разбирали в гиде какую локальную LLM выбрать. Для Pi из него подходят самые младшие модели семейств — например, у Qwen3 есть версии от 0,6B.
Первый запуск LLM на Raspberry Pi 5: три шага
- Запишите на карту памяти 64-битную Raspberry Pi OS и обновите систему.
- Установите Ollama официальным скриптом:
curl -fsSL https://ollama.com/install.sh | sh. - Скачайте и запустите модель одной командой:
ollama run qwen2.5:1.5b. Это та же модель, что дала 10,62 tok/s в таблице выше.
8 или 16 ГБ: что даёт лишняя память
Объём памяти почти не влияет на скорость: 4,61 tok/s на 8 ГБ против 4,88 tok/s на 16 ГБ у Llama 3.2 3B в замерах Гирлинга. Скорость решает пропускная способность памяти, а она у всех версий Pi 5 одна. Зато 16 ГБ открывают модели, которые на 8 ГБ просто не помещаются.
Самый интересный случай — MoE-модели («смесь экспертов»): у них много параметров, но на каждый токен работает только малая часть. ByteShape сжал Qwen3-30B-A3B примерно до 10 ГБ и заявляет 8,03 tok/s на Pi 5 16 ГБ при 94,18% качества исходной модели. Гирлинг подтвердил запуск, но свою цифру скорости не привёл. Если заявка верна, это модель 30B-класса быстрее, чем 3B на том же Pi.
Рантайм и охлаждение: бесплатный прирост скорости
Программа запуска влияет на скорость не меньше железа. Google показал Gemma 4 E2B на Pi 5 8 ГБ: через собственный LiteRT-LM — 9 tok/s и 1,4 ГБ памяти, через llama.cpp — 4 tok/s и 4,4 ГБ. У ai-local-lab простое обновление Ollama с 0.24.0 до 0.31.1 ускорило маленькую модель LFM2.5 230M в 1,64 раза (с 26,73 до 43,84 tok/s). Поэтому перед покупкой ускорителя сначала попробуйте другой рантайм и свежую версию. Насколько расходятся Ollama, LM Studio и llama.cpp на одной модели, мы разбирали отдельно.
Под нагрузкой процессор Pi 5 греется до 71–73 °C даже с официальным кулером Active Cooler (ai-local-lab, июнь 2026). Без активного охлаждения плата начнёт сбрасывать частоту, и все цифры из таблицы окажутся завышенными.
AI HAT+ 2 на Hailo-10H: что внутри, сколько стоит и какие модели есть
AI HAT+ 2 — официальная плата расширения от Raspberry Pi для генеративного ИИ. Она вышла 15 января 2026 года и ставится сверху на Pi 5. Внутри два главных чипа:
- Hailo-10H — нейропроцессор (NPU), то есть чип, заточенный под вычисления нейросетей. Производитель заявляет 40 TOPS (триллионов операций в секунду) в формате INT4. Джефф Гирлинг в обзоре пишет о «40 TOPS INT8», но официальные страницы Raspberry Pi и Hailo указывают именно INT4.
- 8 ГБ памяти LPDDR4X прямо на плате. Модель живёт в ней, а не в памяти Raspberry Pi. Поэтому хостом может быть даже Pi 5 на 2 ГБ: CNX Software провёл все тесты именно на такой плате, и процессор при генерации почти простаивал.
AI HAT+ 2 для Raspberry Pi 5 и только для него: у Pi 4, Pi 500 и Pi 500+ нет выведенного разъёма PCIe. А на самом Pi 5 плата занимает единственную линию PCIe, поэтому NVMe-диск рядом с ней без разветвителя не поставить.
С ценой есть путаница. На старте AI HAT+ 2 стоил $130. В апреле 2026 года The Register сообщил о подорожании на $50, что дало бы $180. На 15 ноября 2026 года официальная страница показывает $200, и откуда взялись ещё $20, ни один найденный источник не объясняет. Итого плата подорожала на 54% за десять месяцев.
Какие LLM-модели есть для Hailo-10H
Hailo-10H не запускает произвольные модели из интернета. Ему нужен формат HEF — модель, заранее скомпилированная под этот чип инструментом Hailo Dataflow Compiler. Готовые модели лежат в официальном каталоге Hailo Model Zoo GenAI. Ниже — список LLM-моделей для Hailo-10H из версии v5.5.0 от 1 ноября 2026 года. Цифры скорости — заявка Hailo, на какой плате их сняли, каталог не указывает.Модель Размер Контекст, токенов До первого токена, с Генерация, tok/s Llama3.2-1B-Instruct 1,79 ГБ 2048 0,35 9,82 Qwen2.5-Coder-1.5B 1,64 ГБ 2048 0,32 8,13 Qwen2-1.5B 1,56 ГБ 2048 0,32 8,02 DeepSeek-R1-Distill-Qwen-1.5B 2,37 ГБ 2048 1,45 7,59 Qwen2.5-1.5B 1,64 ГБ 2048 0,37 7,32 Gemma4-E2B 3,11 ГБ 2048 0,55 5,47 Qwen3-1.7B 1,79 ГБ 2048 0,62 4,72 Qwen3-4B-Instruct-2507 4,2 ГБ 2048 1,53 2,07 Qwen2-VL-2B / Qwen3-VL-2B (картинка + текст) 2,18 ГБ 2048 1,01 / 1,47 7,13 / 4,89 Qwen3-VL-4B (картинка + текст) 4,4 ГБ 2048 3,59 2,29 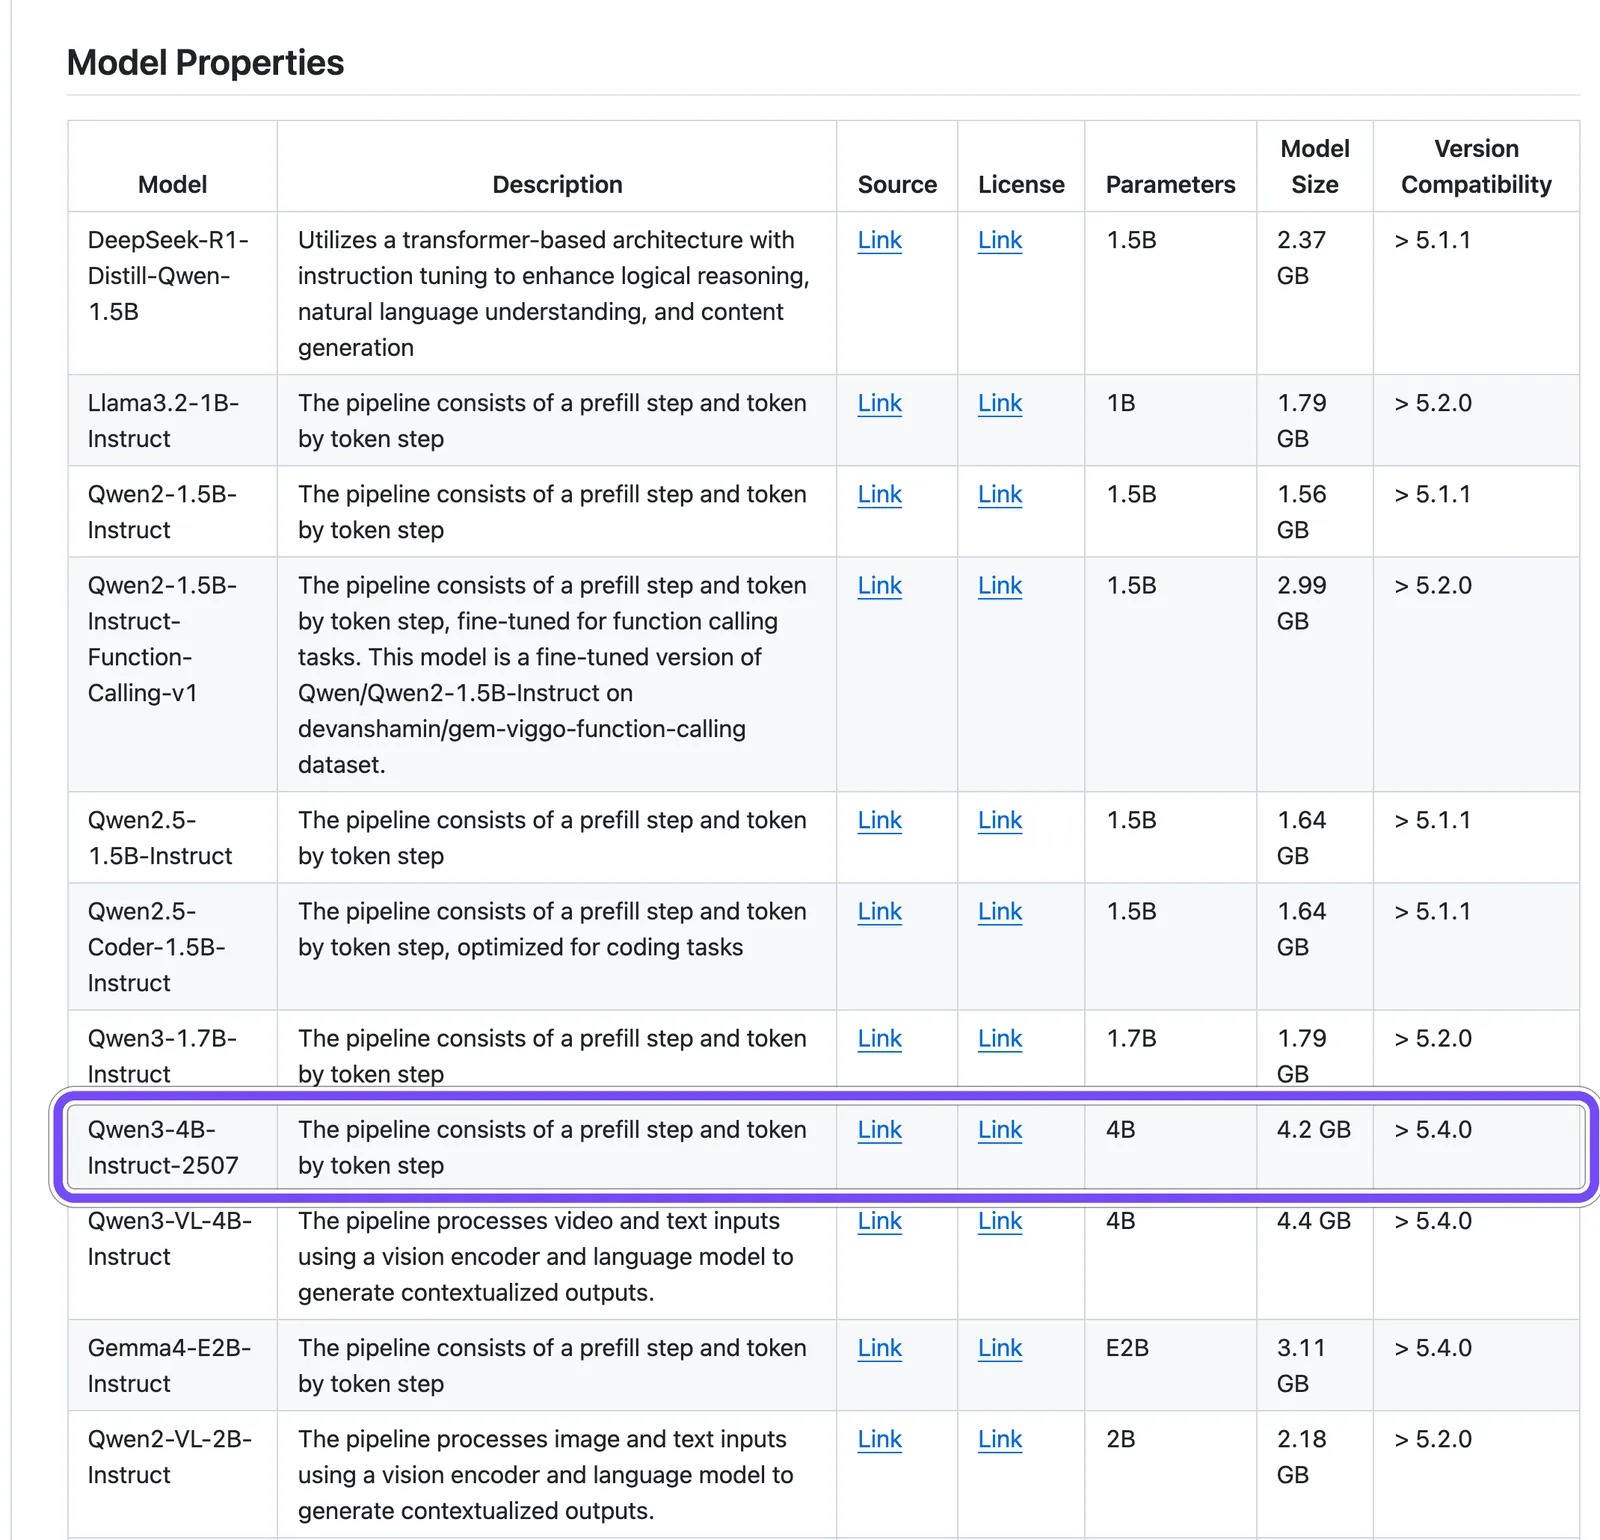
На скриншоте каталога рамкой выделена Qwen3-4B-Instruct-2507 на 4,2 ГБ — самая крупная LLM, которая на 15 ноября 2026 года есть для Hailo-10H. Обзор ComputingForGeeks от 19 октября 2026 года ещё называл потолком Qwen3 1.7B, хотя 4B добавили в версии v5.4.0 от 16 сентября. Кроме языковых моделей, в каталоге есть распознавание речи Whisper от Tiny до Medium.
Три ограничения видны сразу. Первое: контекст 2048 токенов у всех моделей. Это окно памяти модели, примерно 3–4 страницы текста вместе с вашим вопросом и ответом. Второе: потолок 4B, хотя 8 ГБ на плате формально вместили бы больше. Третье: свою модель из Hugging Face вы не загрузите — только дообучить готовую через адаптеры LoRA и скомпилировать их Dataflow Compiler.
AI HAT+ 2 против процессора Pi 5: почему ускоритель медленнее
Связку Hailo-10H и Raspberry Pi 5 независимо проверили три команды, и все пришли к одному выводу: в генерации текста ускоритель уступает процессору самой платы. CNX Software сравнил модели 1,5–3B в январе 2026 года, Гирлинг опубликовал свою таблицу в тот же месяц, ai-local-lab повторил тест в июле.Модель Процессор Pi 5, tok/s AI HAT+ 2, tok/s Чей замер Qwen2 1.5B 11,29 / 12,47 5,89 / 8,25 CNX / Гирлинг Qwen2.5-Instruct 1.5B 11,73 / 11,41 6,74 / 6,86 CNX / Гирлинг DeepSeek-R1-Distill 1.5B 9,04 / 10,99 6,72 / 6,85 CNX / Гирлинг Qwen2.5-Coder 1.5B 10,26 / 9,77 8,06 / 8,13 CNX / Гирлинг Llama 3.2 3B 4,78 / 5,55 2,60 / 2,66 CNX / Гирлинг Qwen2.5 1.5B, одинаковый промпт 9,72 7,05 ai-local-lab, 10.07.2026
Таблица Гирлинга приведена в пересказе ComputingForGeeks. У замеров есть оговорки: CNX мерил процессор на девките CM5 с 4 ГБ (тот же чип BCM2712), а HAT — на Pi 5 с 2 ГБ, версии Ollama и квантование разные. Поэтому самый чистый тест — у ai-local-lab: одна плата, один промпт, разница 38% в пользу процессора. Ближе всего HAT подошёл на Qwen2.5-Coder, но и там не догнал.
Почему 40 TOPS не превращаются в токены
Генерация текста — это чтение. На каждый новый токен модель заново прочитывает из памяти все свои веса, а считает при этом немного. Поэтому скорость упирается не в TOPS, а в пропускную способность памяти. У Pi 5 и у Hailo-10H стоит память одного класса, LPDDR4X-4267. Основатель Raspberry Pi Эбен Аптон подтвердил CNX Software, что похожий результат ожидаем именно по этой причине.
TOPS работают на другой стадии — prefill, когда модель разом обрабатывает весь ваш запрос. Там много вычислений и мало чтения памяти, поэтому NPU может выиграть. Но на ответе длиной в абзац основное время уходит на генерацию.
Калькулятор: сколько токенов выдаст ваше железо
Формулу даёт руководство Arm по генерации LLM: скорость генерации равна пропускной способности памяти, делённой на объём, прочитанный за один токен. На практике до теоретического потолка не доходит никто, поэтому результат умножают на коэффициент эффективности.
- Возьмите размер файла модели в гигабайтах. Если его нет — умножьте число миллиардов параметров на 0,7 (для квантования Q4_K_M).
- Разделите пропускную способность памяти на этот размер. У Pi 5 она около 17 ГБ/с по паспорту, Arm в своих тестах намерил 13,8 ГБ/с в устойчивом режиме.
- Умножьте результат на 0,45–0,7. Это реальная эффективность: в замерах ai-local-lab на Pi 5 она составила от 43 до 72%.
Проверка на живых цифрах ai-local-lab:Модель Размер (Q4_K_M) Потолок на Pi 5, tok/s Замер, tok/s Эффективность Gemma 3 1B ≈0,7 ГБ 24,3 10,84 45% Qwen2.5 1.5B ≈1,05 ГБ 16,2 10,62 66% Qwen3.5 4B ≈3,29 ГБ 5,2 2,24 43% Ministral 3 8B ≈6,23 ГБ 2,7 1,96 72%
Та же формула объясняет, почему Jetson Orin Nano Super в разы быстрее. Его память выдаёт 102 ГБ/с — в шесть раз больше, чем у Pi. Для модели на 3B (около 2,2 ГБ) потолок около 46 tok/s, и лучший замер NVIDIA — 43,07 tok/s у Llama 3.2 3B — почти упирается в него. Это наш расчёт по формуле, а не измерение.
Задержка до первого токена у Hailo-10H: заявка против замера
У Hailo есть сильный аргумент: время до первого токена (TTFT) — пауза перед тем, как модель начнёт отвечать. В статье Hailo в блоге Raspberry Pi приведено 320 мс на Hailo-10H против 2039 мс на процессоре Pi 5 (Qwen2.5-1.5B, запрос на 96 токенов, процессор через llama.cpp). Это в 6,4 раза быстрее.
Независимо эту цифру не подтвердил никто. CNX Software не нашёл в инструментах Hailo способа измерить TTFT. ai-local-lab в июле 2026 года получил обратный результат: 738 мс на HAT против 541 мс на процессоре (hailo-ollama 0.5.1). Возможно, выигрыш проявляется на длинных запросах или в собственном SDK Hailo, но на 15 ноября 2026 года это остаётся заявкой производителя.
Где AI HAT+ 2 оправдан: зрение, VLM, голос и экономия ватт
Сама Hailo формулирует назначение платы прямо: не спрашивайте у тостера уроки истории. AI HAT+ 2 сильнее всего там, где много входных данных и короткий ответ. Пять сценариев, в которых он даёт реальную пользу:
- Камера с пониманием сцены (VLM). Модель «картинка + текст» сначала прогоняет кадр через тяжёлый визуальный кодировщик — это работа как раз для NPU. Qwen2-VL-2B по каталогу Hailo отвечает со скоростью 7,13 tok/s. CNX Software считает такие камеры, включая системы видеонаблюдения вроде Frigate, лучшим применением платы.
- Голос в действие. Цепочка «речь → текст → команда»: Whisper распознаёт фразу, маленькая LLM понимает намерение и запускает действие. Ответ короткий, поэтому медленная генерация почти не мешает.
- Разгрузка процессора. Пока модель работает на HAT, процессор и память Pi свободны для камеры, базы данных или веб-интерфейса.
- Дешёвый хост. Модель живёт в 8 ГБ на плате, поэтому хватит Pi 5 на 2 ГБ за $77,50 вместо 8-гигабайтной версии за $175.
- Питание от аккумулятора или солнечной панели. Под LLM-нагрузкой вся система с HAT потребляет 7,2–7,6 Вт против 10,2–10,6 Вт на процессоре (CNX), у Гирлинга — 7,1 Вт против 12,3 Вт.
У Hackster.io вышло 5,2 Вт на всю систему, у ai-local-lab — 2,4 Вт против 6,2 Вт: методики разные, направление одно. По расчёту ai-local-lab, на 1000 сгенерированных токенов HAT тратит около 0,095 Вт·ч, процессор — 0,177 Вт·ч. В простое картина обратная: по данным Гирлинга, с HAT плата берёт 4,2 Вт, без него — 3,1 Вт.
Голосовой ассистент на Pi 5: хватит ли процессора
Для голосового помощника HAT не обязателен. На процессоре Pi 5 Whisper tiny распознаёт короткую команду меньше чем за секунду, base — за 1–2 секунды, small — за 3–6 секунд (оценка руководства 1c3d, сентябрь 2026). Плюс 1–2 секунды на ответ маленькой LLM — и ассистент укладывается в паузу обычного разговора.
HAT позволяет взять более точную модель распознавания: в каталоге Hailo есть Whisper Medium, которую процессор Pi обрабатывал бы слишком долго. Насколько важна точность распознавания на русском и украинском, видно по нашему разбору Whisper large-v3 и turbo на ПК и Mac.
Старые AI HAT+ и AI Kit на Hailo-8: только зрение, без LLM
До AI HAT+ 2 у Raspberry Pi уже были ИИ-ускорители: AI Kit на чипе Hailo-8L (13 TOPS) и AI HAT+ на Hailo-8 или Hailo-8L (26 или 13 TOPS). Языковые модели они не запускают. Причина — у них нет собственной памяти, и они опираются на память Raspberry Pi. Для сверточных сетей распознавания образов этого хватает, для LLM — нет.
На 15 ноября 2026 года AI Kit снят с производства, а AI HAT+ продаётся от $70 (на запуске версии стоили $70 и $110). Если вам нужно только зрение — детекция людей, машин, номеров, — старый HAT остаётся рабочим выбором:
- По зрению AI HAT+ 2 и 26-TOPS AI HAT+ почти равны. Так пишет сама Raspberry Pi. Hailo заявляет до двух раз выигрыша, но только на крупных моделях.
- Гирлинг сформулировал жёстче: детекция на HAT+ 2 работает в 10 раз быстрее, чем на процессоре Pi, но то же умеет старый HAT за $110 или камера AI Camera за $70.
- TOPS разных поколений не сравнивают напрямую. У Hailo-8 цифра в INT8, у Hailo-10H — в INT4, а это разная точность вычислений.
- Новые платы 2026 года тоже не про LLM. Sixfab AI HAT+ на чипе DEEPX (25 TOPS, 2 ГБ, около $95) рассчитан на зрение, поддержки языковых моделей у него нет.
Учтите и программную несовместимость: драйверный пакет hailo-h10-all для AI HAT+ 2 не уживается с hailo-all от старых плат.
Сборка Raspberry Pi 5 под LLM: комплектующие и итоговая цена
Плата — только часть расходов. Pi 5 под постоянной нагрузкой нужен официальный блок питания на 27 Вт, активный кулер и карта памяти. По ценам сборок ComputingForGeeks (октябрь 2026) этот набор добавляет примерно $65. Цены ниже — рекомендованные в долларах США.Компонент Цена На дату Зачем Raspberry Pi 5 2 ГБ $77,50 с 01.10.2026 хост для AI HAT+ 2, модель живёт на HAT Raspberry Pi 5 8 ГБ $175 апрель 2026 (старт — $80) базовый вариант для моделей 1–4B на процессоре Raspberry Pi 5 16 ГБ $385 с 02.11.2026 (старт в январе 2025 — $120) модели 14B и MoE-модель 30B AI HAT+ 2 $200 15.11.2026 (старт — $130) NPU Hailo-10H и 8 ГБ памяти Блок питания 27 Вт, Active Cooler, microSD 64 ГБ ≈$65 октябрь 2026, наш расчёт по сборкам ComputingForGeeks без них плата сбрасывает частоту
По 16-гигабайтной версии источники расходятся: на 15 ноября 2026 года официальная страница ещё показывает $305, а Tom’s Hardware, The Register и CNX Software сообщают о $385 с 2 ноября. Мы считаем по новой цене — это в 3,2 раза дороже, чем на старте.
Четыре готовые сборки:Сборка Расчёт Итого Что получаете Pi 5 8 ГБ, процессор $175 + $65 ≈$240 1–1,5B на 8–11 tok/s, 3B на 4,6 tok/s, любой GGUF Pi 5 2 ГБ + AI HAT+ 2 $77,50 + $200 + $65 ≈$340 модели из каталога Hailo, 7 Вт, свободный процессор Pi 5 8 ГБ + AI HAT+ 2 $175 + $200 + $65 ≈$440 то же плюс запас памяти для других задач Pi 5 16 ГБ, процессор $385 + $65 ≈$450 всё из первой строки плюс 14B и MoE-модель 30B
Вывод из таблицы: если цель — чат, а не камера, AI HAT+ 2 удваивает бюджет и ничего не добавляет к скорости. Самая разумная Pi-сборка под текст — 8 ГБ без ускорителя за ≈$240.
Pi 5, Jetson Orin Nano Super и мини-ПК на N150: цена и скорость
На бюджете $350–450 одноплатный компьютер для ИИ конкурирует не только с другими одноплатниками, но и с мини-ПК и платами NVIDIA. Сравнение на одной модели — Llama 3.2 3B или ближайшем аналоге:Платформа Цена на ноябрь 2026 Модель 3B, tok/s Мощность под нагрузкой Особенности Pi 5 8 ГБ, процессор $175 (≈$240 со всем) 4,61 пик 13,9 Вт (Гирлинг) любой GGUF, Ollama и llama.cpp Pi 5 16 ГБ, процессор $385 (≈$450) 4,88; MoE 30B ≈8 (заявка) пик 11,9 Вт единственный Pi под 14B и MoE Pi 5 8 ГБ + AI HAT+ 2 $375 (≈$440) 2,60–2,66 7,1–7,6 Вт только модели Hailo, контекст 2048 Jetson Orin Nano Super $399 (было $249) 22,6 (Ollama, Qwen2.5 3B) … 43,07 (NVIDIA, MLC) 7–25 Вт CUDA, 102 ГБ/с, наличие нестабильное Мини-ПК Intel N150, 16 ГБ медиана $349 9,06 пик 26,4 Вт готовый корпус и SSD M5Stack LLM-8850 + Pi 5 модуль $139, комплект $215 (январь 2026) 9,05 на 1,5B (заявка M5Stack) до 7 Вт чип Axera AX8850, 24 TOPS INT8
Jetson подорожал до $399 в июле 2026 года. Медиана N150 с 16 ГБ и SSD 500 ГБ — по срезу Amazon US на 1 ноября 2026 года (разброс $281–550), скорость — замер Гирлинга на GMKtec G3 Plus. Цифры LLM-8850 — от производителя, а одна версия модуля в магазине M5Stack уже снята с производства, так что актуальная цена неизвестна.
Что следует из сравнения:
- Мини-ПК на N150 вдвое быстрее Pi 5 на модели 3B (9,06 против 4,61 tok/s) и почти вдвое — на 14B (2,13 против 1,20 tok/s у DeepSeek R1 по замерам Гирлинга). Он стоит дешевле сборки Pi 5 8 ГБ с HAT и сразу идёт с SSD. Платите вы ваттами: пик 26,4 Вт против 7–14 Вт у Pi.
- Jetson Orin Nano Super — в 5–9 раз быстрее Pi на моделях 3B благодаря памяти на 102 ГБ/с. По цене он почти сравнялся со сборкой Pi + HAT: ComputingForGeeks оценивает Jetson с NVMe-диском в $440–480.
- Pi остаётся лучшим там, где важны 5–8 Вт, экосистема HAT-плат и GPIO для датчиков, камер и реле. По цене преимущества уже нет: Pi 5 16 ГБ в ноябре в 1,1 раза дороже типичного мини-ПК на N150.
Подробнее о том, почему для домашнего ИИ важнее память, а не NPU, — в разборе домашний ИИ-сервер: NAS, мини-ПК или ПК.
Риски AI HAT+ 2 и Pi 5: контекст, качество моделей, цены
- Контекст 2048 токенов. Hackster.io попросил модель на HAT пересказать обзор и получил сообщение о переполнении контекста. Документы, длинная переписка и RAG по собственным файлам на HAT не работают.
- Качество моделей 1–4B. Они путают факты и плохо держат длинную мысль. В тесте CNX Software перевод короткой фразы на французский вышел неточным. Для справочных вопросов такие модели ненадёжны.
- Только формат HEF. Новая модель появится на HAT, только когда её скомпилирует Hailo. Скачать свежую модель из Hugging Face в день релиза, как в Ollama, не выйдет.
- Холодный старт и сырые инструменты. Ускоритель выгружает модель после простоя, и первый ответ ждёт 25–40 секунд (Hackster.io). hailo-ollama дублирует запросы в терминал, версия 0.5.1 падала на запросе с переносом строки (ai-local-lab), а Open WebUI из инструкции открывается по HTTP на всех сетевых интерфейсах — в домашней сети это стоит закрыть.
- Неровный ритм обновлений. Релизы ПО для Hailo-10H выходят раз в квартал, но июльское обновление 2026 года опоздало: пакеты 5.4.0 вышли только 9–16 сентября, и даже тогда приложения hailo-apps их не принимали.
- Смена владельца Hailo. 24 июля 2026 года Microchip объявил о подписании соглашения о покупке Hailo. Закрытие ожидалось до конца сентября, подтверждения завершения сделки мы не нашли. Как это скажется на поддержке Hailo-10H, пока неизвестно.
- Цены на память. За 2026 год Raspberry Pi поднимал цены четыре раза, последний — 2 ноября, и дефицит памяти пока не закончился.
У связки есть и сильные стороны: полная работа без интернета, данные не уходят в облако, 7 Вт под нагрузкой и разъём GPIO, к которому напрямую подключаются камеры, датчики и реле.
Что устареет первым. Цены Raspberry Pi, список моделей в каталоге Hailo (новая версия выходит раз в квартал) и скорость рантаймов: свежая версия Ollama или LiteRT-LM может сдвинуть цифры из таблиц на десятки процентов. Перед покупкой сверьте цену на странице продукта и версию в каталоге Hailo.
Когда Raspberry Pi 5 для LLM мало и куда переходить дальше
Решение удобно принимать по шагам — от задачи к железу:
- Нужна модель 7B и больше или скорость выше 10 tok/s на 3B? Pi не подходит ни в каком варианте: на 7–8B он даёт меньше 2 tok/s. Смотрите мини-ПК, Mac или ПК с видеокартой.
- Нужны длинные документы, RAG или переписка на десятки сообщений? Отпадает AI HAT+ 2 с его 2048 токенами. Pi 5 на процессоре длинный контекст обработает, но медленно: на новом запросе в 1864 токена ai-local-lab ждал первого токена 29,7 секунды.
- Нужен голосовой помощник или текстовые команды умного дома? Хватит Pi 5 8 ГБ без ускорителя за ≈$240.
- Нужна камера, которая описывает происходящее словами, или питание от батареи? Это сценарий для Pi 5 2 ГБ + AI HAT+ 2 за ≈$340.
- Хотите максимум качества на одноплатнике и готовы ждать? Pi 5 16 ГБ с MoE-моделью Qwen3-30B-A3B, но за ≈$450 мини-ПК уже быстрее на обычных моделях.
Ждать следующего поколения нет смысла. Эбен Аптон на сессии вопросов и ответов 21 мая 2026 года сказал, что Pi 6 выйдет не раньше начала 2028 года. Отдельного NPU в нём не ждут: площадкой для ИИ-вычислений Аптон назвал сам процессор.
Следующая ступень после одноплатника — по нашему гиду как выбрать железо для локального ИИ. Если бюджет позволяет перешагнуть сразу через мини-ПК, посмотрите Mac Mini M4 Pro для нейросетей: у него быстрая единая память, а значит и другой порядок скорости.
FAQ
Потянет ли Raspberry Pi 5 на 8 ГБ модель на 7B?
Запустит, но пользоваться будет тяжело. В замерах ai-local-lab модель Ministral 3 8B в квантовании Q4_K_M выдала на Pi 5 8 ГБ 1,96 токена в секунду, то есть абзац ответа пишется около минуты. Памяти хватает, упирается всё в пропускную способность. Для модели 7–8B разумнее мини-ПК или Mac, а на Pi 5 лучше взять модель на 1,5–3B.
Нужен ли AI HAT+ 2, если у меня Raspberry Pi 5 на 16 ГБ?
Для чата — нет. Те же открытые модели (Qwen2.5, Llama 3.2, Gemma) Pi 5 запускает на процессоре в формате GGUF, и в независимых замерах на одинаковых моделях процессор быстрее HAT. Плюс 16 ГБ тянут 14B и MoE-модель на 30B, которых у HAT нет. AI HAT+ 2 имеет смысл, только если нужны камера с VLM, разгрузка процессора или работа от аккумулятора.
Работает ли AI HAT+ 2 с Raspberry Pi 4 или Pi 500?
Нет. AI HAT+ 2 подключается к разъёму PCIe в формате Raspberry Pi 5: у Pi 4, Pi 500 и Pi 500+ нет выведенного разъёма PCIe под плату расширения. Официально поддерживается только Raspberry Pi 5, причём подойдёт любая версия памяти, включая 2 ГБ: модель хранится в собственных 8 ГБ на плате ускорителя.
Можно ли запустить GGUF-модель с Hugging Face на Hailo-10H?
Нет. Hailo-10H понимает только модели в формате HEF, которые Hailo заранее компилирует под свой чип и выкладывает в каталог Model Zoo GenAI. На 15 ноября 2026 года там около десятка LLM и VLM до 4B. Свою модель можно только дообучить адаптерами LoRA и собрать через Hailo Dataflow Compiler, произвольный GGUF не загружается.
Можно ли поставить NVMe-диск вместе с AI HAT+ 2?
Напрямую — нет. У Raspberry Pi 5 одна линия PCIe, и AI HAT+ 2 занимает её целиком, поэтому для NVMe-накопителя понадобится отдельная плата-разветвитель PCIe. Без неё система загружается с карты microSD или USB-накопителя. Если быстрый SSD для системы важнее ускорителя, выбирайте сборку на процессоре: без HAT линия PCIe свободна, и NVMe-накопитель подключается через M.2-плату.