Коротко (TL;DR)
На 15 ноября 2026 года собственные ИИ-чипы Amazon и Google догнали Nvidia Blackwell Ultra (B300/GB300) по паспортной мощности в формате FP8, но не Rubin: в паре AWS Trainium vs Nvidia это видно на уровне систем, в паре Google TPU vs Nvidia — уже на уровне одного чипа. В отдельных задачах TPU даёт больше токенов на доллар. Но эти чипы не вытесняют видеокарты Nvidia, а встают рядом с ними — даже в облаках самих Amazon и Google.
- Коротко (TL;DR)
- ASIC против GPU: чем Trainium и TPU отличаются от видеокарт Nvidia
- Какие чипы актуальны на 15.11.2026: Trainium 3, TPU 8 и Rubin
- Trainium3, Ironwood и Nvidia B300 на чип: HBM, ТБ/с и FP8/FP4
- Ironwood против GB300 в тестах: что показал независимый InferenceX
- Сколько стоит PFLOPS-час: свой расчёт по прайсам Google и AWS
- Кто работает на Trainium и TPU: Anthropic, OpenAI, Meta
- Почему Nvidia остаётся лидером: CUDA, NVLink и поставки
- Доля рынка ASIC: 27,8% серверов и около 80% выручки у Nvidia
- Что гонка чипов значит для цен на ИИ: аренда, API и выбор
- Где расходятся источники: цена Ironwood, S-1 Anthropic и FP8 Trainium
- Риски для Trainium, TPU и Nvidia: вендорские цифры, CoWoS и 2027
- Частые вопросы про Trainium, TPU и Nvidia
Главный перекос в том, что у Nvidia остаются формат FP4, новое поколение Rubin, программная экосистема CUDA и, по оценкам отрасли, около 75–80% выручки рынка ИИ-ускорителей. Самые громкие ответы конкурентов — Trainium4 и TPU 8i Max — выйдут только в 2027 году.
- Система на систему. Trn3 UltraServer (144 чипа Trainium3) выдаёт 362 PFLOPS в FP8 по данным AWS — почти столько же, сколько стойка Nvidia GB300 NVL72 (360 PFLOPS dense). Новая стойка Vera Rubin NVL72 — уже 1 260 PFLOPS, в 3,5 раза больше.
- Чип на чип. Google TPU v7 Ironwood — 4,61 PFLOPS FP8 против 5 PFLOPS у Nvidia B300, но под Google собирает до 9 216 чипов, а стойка Nvidia — 72 GPU.
- Независимый тест. В InferenceX от 19 октября 2026 года на модели Qwen3.5-397B при 200 токенах в секунду на пользователя Ironwood в FP8 дал в 1,85 раза больше токенов на доллар, чем GB300 в FP8. Против GB300 в FP4 картина обратная: у TPU только 0,54 от результата Nvidia.
- Наш расчёт цены. PFLOPS-час FP8 у Ironwood по прайсу Google стоит $2,60 без обязательств и $1,17 при контракте на 3 года; у B300 в AWS Capacity Blocks — $3,23. Зато в FP4 тот же B300 обходится в $1,08.
- Кто на них работает. Anthropic по S-1/A-2 от 10 ноября 2026 года одновременно использует Trainium, TPU, GPU Nvidia и AMD; OpenAI обязалась потреблять около 2 ГВт мощностей Trainium; Meta уже обслуживает модели на TPU.
ASIC против GPU: чем Trainium и TPU отличаются от видеокарт Nvidia
ASIC (application-specific integrated circuit) — это микросхема, спроектированная под узкий класс задач. Trainium от AWS и TPU от Google — ASIC для нейросетей: почти весь кристалл отдан блокам матричного умножения, на котором держатся и обучение модели, и инференс (генерация ответа). GPU Nvidia — универсальный параллельный процессор: его программируют через CUDA под любые вычисления, и ИИ — лишь самая доходная из них.
Специализация даёт выигрыш в цене и энергопотреблении на «своих» задачах и проигрыш в гибкости. Свежий пример: у Ironwood нет нативной поддержки формата FP4, на который делает ставку Nvidia, — и в тестах это решает исход сравнения (подробно ниже). Сделать свой ASIC по карману только гиперскейлерам: по данным CNBC на ноябрь 2025 года, разработка кастомного чипа стоит десятки миллионов долларов ещё до первой партии, а Nvidia продаёт стойку GB200 NVL72 примерно за $3 млн.
Второе отличие — как чипы объединяются в один большой компьютер (scale-up). Nvidia соединяет 72 GPU через коммутаторы NVLink: любой GPU стойки говорит с любым на полной скорости. Google собирает TPU в трёхмерный тор, где каждый чип связан с соседями напрямую, а оптические коммутаторы перестраивают топологию пода. Масштаб у тора больше, но сигнал до дальнего чипа идёт через промежуточные. Google делает TPU больше десяти лет и даже испытывает TPU Google на орбите, а в 2026 году впервые начала ставить TPU-системы в дата-центры клиентов.Параметр Google TPU v7 Ironwood AWS Trainium3 Nvidia B300 (GB300 NVL72) Тип чипа ASIC ASIC GPU Где взять Google Cloud; с 2026 года — ЦОДы клиентов только AWS; вне AWS — план «конец 2027» любые облака и покупка серверов Объединение в scale-up 3D-тор, до 9 216 чипов в поде Trn3 UltraServer, до 144 чипов NVLink 5 с коммутаторами, 72 GPU Канал между чипами 600 ГБ/с в одну сторону (1 200 ГБ/с в обе) н/д 900 ГБ/с в одну сторону Нативный FP4 нет MXFP4 с той же пиковой цифрой, что FP8 да, 15 PFLOPS dense Софт для PyTorch TorchTPU (открыт в октябре 2026), бэкенды vLLM и SGLang Neuron, TorchNeuron (открыт 20.10.2026) CUDA, TensorRT-LLM, Dynamo
Каналы между чипами — по документации Google и сводке SemiAnalysis InferenceX; данные Trainium3 — со страницы AWS (проверено 15.11.2026).
Какие чипы актуальны на 15.11.2026: Trainium 3, TPU 8 и Rubin
Больше всего путаницы в теме создают анонсы, которые выдают за доступное железо. В конкурентных обзорах Trainium4 и TPU 8 сравнивают с Blackwell так, будто их уже можно арендовать. На середину ноября 2026 года картина такая.Вендор Чип или система Статус на 15.11.2026 Ключевая дата AWS Trainium3 / Trn3 UltraServer, первый 3-нм чип AWS общий доступ в EC2 GA 02.12.2025 AWS Trainium4 в разработке, поставки ожидаются с 2027 года анонс 02.12.2025 AWS Trainium для клиентов вне AWS план «late in 2027» заявление 29.10.2026 Google TPU v7 Ironwood общий доступ, есть публичный прайс анонс 04.2025, GA — 2026 Google TPU 8t (обучение) и TPU 8i (инференс) анонсированы, независимых тестов нет 22.04.2026 Google TPU 8tx (конфиденциальные вычисления) и TPU 8i Max анонсированы, доступность — 2027 09.11.2026 Nvidia B300 / GB300 NVL72 (Blackwell Ultra) массово в облаках, в AWS — инстансы P6-B300 в продаже Nvidia Vera Rubin NVL72 производственные поставки с августа 2026; GA в Oracle Cloud 27.10.2026 Microsoft Maia 300 анонсирован, в продакшен — 2027 12.10.2026
Отсюда первое правило чтения новостей: в сравнении AWS Trainium 3 vs Nvidia честная пара — Trainium3 против B300 и Rubin, а Trainium4 соревнуется с тем, что Nvidia выпустит в 2027 году. Для Google честная пара — Ironwood против Blackwell Ultra: именно так её и тестирует SemiAnalysis. TPU 8t и 8i — следующий шаг, который Google описывает в техническом разборе TPU 8t и TPU 8i от 22 апреля 2026 года, но замеров на них пока нет.
Nvidia тем временем уже отгружает Rubin — его сравнение с другим претендентом, AMD, мы разбирали в материале AMD Instinct MI400 против Nvidia Vera Rubin. По блогу Nvidia, общий доступ к инстансам Vera Rubin в Google Cloud ожидается в ноябре 2026 года — то есть Google будет сдавать в аренду и свои TPU, и самый новый GPU конкурента.
Trainium3, Ironwood и Nvidia B300 на чип: HBM, ТБ/с и FP8/FP4
Три цифры решают, сколько ИИ-задач чип прожуёт за час. Первая — объём памяти HBM: это стеки DRAM прямо на подложке рядом с кристаллом, в них живут веса модели и кэш контекста. Вторая — пропускная способность этой памяти: при генерации ответа чип большую часть времени ждёт данные, поэтому ТБ/с часто важнее PFLOPS.
Третья — вычислительная мощность в формате чисел. FP8 и FP4 — восьми- и четырёхбитные числа с плавающей точкой: чем меньше бит, тем больше операций за такт, но тем выше риск потерять точность модели. Ещё одна ловушка — dense и sparse: Nvidia часто печатает «разреженные» (sparse) цифры, вдвое выше «плотных» (dense). Ниже — только dense, если не оговорено иное.
| На один чип | Trainium3 | TPU v7 Ironwood | TPU 8t | TPU 8i | Nvidia B300 | Nvidia Rubin |
|---|---|---|---|---|---|---|
| Память | 144 ГБ HBM3e | 192 ГиБ (≈206 ГБ) HBM3e | 216 ГБ | 288 ГБ | 288 ГБ HBM3e | 288 ГБ HBM4 |
| Пропускная способность | 4,9 ТБ/с | 7,37 ТБ/с | 6,53 ТБ/с | 8,6 ТБ/с | 8 ТБ/с | 19,2 ТБ/с |
| FP8, PFLOPS | 2,52* | 4,61 | н/д | н/д | 5 | 17,5 |
| FP4, PFLOPS | 2,52* (MXFP4) | нет нативного | 12,6 (пик) | 10,1 (пик) | 15 | 50 (инференс, sparse) |
| Scale-up | 144 чипа | 9 216 чипов | 9 600 чипов | до 1 152 чипов | 72 GPU | 72 GPU |
| Статус | доступен | доступен | анонс | анонс | доступен | поставки с 08.2026 |
*AWS публикует 362 PFLOPS FP8 на систему из 144 чипов, то есть ≈2,52 на чип, и не уточняет, dense это или sparse. Цифры Google по TPU 8t и 8i — пиковые FP4; FP8 для них Google не публикует, поэтому прямое сравнение с Ironwood и Blackwell в FP8 невозможно.
Что видно из таблицы, если поделить одно на другое:
- Ironwood почти равен B300: 0,92 от него по FP8 и по пропускной способности памяти, 0,72 по объёму HBM. Отставание — в пределах одного поколения.
- Trainium3 на чип вдвое слабее B300: 0,5 по FP8 и по памяти, 0,61 по пропускной способности. AWS добирает за счёт количества чипов в системе.
- Rubin уходит в отрыв: в 3,5 раза больше FP8 и в 2,4 раза больше пропускной способности, чем у B300. С ним сравниться в 2026 году не может ни один ASIC — ответы конкурентов (TPU 8i Max с 384 ГБ и 17,2 ТБ/с, Trainium4) датированы 2027 годом.
Trn3 UltraServer, под Ironwood и стойки NVL72: сравнение систем
На уровне системы картина ровнее. Trn3 UltraServer — 144 чипа и 362 PFLOPS FP8, GB300 NVL72 — 72 GPU и 360 PFLOPS FP8 dense (Nvidia пишет 720 PFLOPS с разреженностью). Любопытное совпадение: у обеих систем и у стойки Vera Rubin NVL72 по 20,7 ТБ памяти — 144 × 144 ГБ и 72 × 288 ГБ дают одно и то же число. Различие в том, что Rubin NVL72 выдаёт 1 260 PFLOPS FP8 (72 × 17,5) при той же памяти, только уже HBM4 с пропускной способностью 1 400 ТБ/с на стойку против 706 ТБ/с у Trn3 UltraServer.
Под Ironwood на 9 216 чипов по нашему умножению даёт около 42 500 PFLOPS FP8. Это не значит, что под «в 118 раз мощнее стойки Nvidia»: задачи, которым нужен целый под, есть у считанных лабораторий, а у тора и у коммутируемого NVLink разная цена передачи данных между далёкими чипами.
Энергоэффективность Ironwood и GB300: PFLOPS FP8 на киловатт
SemiAnalysis закладывает в планирование дата-центров 1,207 кВт на чип Ironwood и 2,12 кВт на GPU GB300 — это мощность с учётом охлаждения и сети. Отсюда наш расчёт: 4,614 / 1,207 ≈ 3,82 PFLOPS FP8 на кВт у Ironwood против 5 / 2,12 ≈ 2,36 у GB300, то есть преимущество TPU примерно в 1,6 раза. Для ЦОДа, который упирается в лимит подведённой мощности, это аргумент сильнее паспортных PFLOPS.
Ironwood против GB300 в тестах: что показал независимый InferenceX
InferenceX — открытая панель замеров SemiAnalysis, где ускорители гоняют на одинаковых агентных сценариях (AgentX) и считают токены на доллар стоимости владения. Это единственный найденный нами независимый замер в паре «TPU Ironwood vs Nvidia». Для Trainium3 независимых тестов на 15.11.2026 нет вовсе — есть только заявление AWS о росте «до 4,4 раза» к системам Trn2.
Методика важна не меньше результата. Стоимость считается по модели SemiAnalysis: $2,31 за GPU-час для GB300 NVL72, $1,21 за чип-час Ironwood для внешнего покупателя и $1,03 — для самой Google. Скорость — p90 интерактивности, то есть токенов в секунду на одного пользователя.Сравнение (InferenceX, 19.10.2026) Модель Скорость на пользователя TPU к GB300, токены на $ (внешн. / внутр. стоимость) TPU к GB300 на МВт Ironwood FP8 против GB300 FP8 (Dynamo SGLang) Qwen3.5-397B 200 ток/с 1,85x / 2,17x 1,70x Ironwood FP8 против GB300 FP4 (Dynamo TensorRT-LLM) Qwen3.5-397B 200 ток/с 0,54x / 0,64x 0,50x Ironwood против GB300 (Dynamo vLLM), Kimi K3: веса MXFP4, активации MXFP8 у обеих систем Kimi K3 100 ток/с 0,97x / 1,15x 0,90x
Первая строка — источник заголовков «TPU в полтора-два раза выгоднее Nvidia». Она верна, но только при равной точности FP8. Вторая строка — тот же тест, но Nvidia включает FP4, которого у Ironwood нет, и выигрывает почти вдвое: по итоговой таблице InferenceX GB300 в FP4 впереди во всех сопоставимых точках при обеих оценках стоимости. На модели Kimi K3 GB300 ведёт по внешней стоимости, а TPU — только по внутренней стоимости Google. FP4 в этой строке — формат весов самой модели; аппаратных FP4-вычислений у Ironwood нет.
Оговорки авторов, без которых цифры читаются неверно:
- AgentX не оценивает качество ответов, поэтому разница в точности между FP4 и FP8 остаётся за рамками теста.
- Ironwood в тесте на Qwen работал на одном хосте из 4 чипов, GB300 — на конфигурациях до 32 GPU.
- В кривых GB300 есть пробелы, и часть значений между замерами интерполирована.
Издание NeoTeo в разборе от 8 ноября 2026 года пришло к тому же выводу: результаты зависят от модели, точности и софта и описывают конкретные конфигурации, а не общий рейтинг ускорителей. Сама SemiAnalysis в той же публикации InferenceX от 19 октября 2026 года напоминает, что её более ранние «до 50% лучше по цене» для Ironwood относились к другому сценарию (запросы 8k/1k) и к сравнению FP8 с FP8 против B200 и B300.
Сколько стоит PFLOPS-час: свой расчёт по прайсам Google и AWS
Паспортные PFLOPS ничего не говорят о деньгах, поэтому мы поделили публичную цену чип-часа на мощность чипа в FP8 dense. Получилась цена одного PFLOPS-часа — сколько стоит час работы условного «петафлопса» в облаке. Метод грубый: он не учитывает загрузку, сеть и софт. Зато он считается по первоисточникам и показывает порядок цен.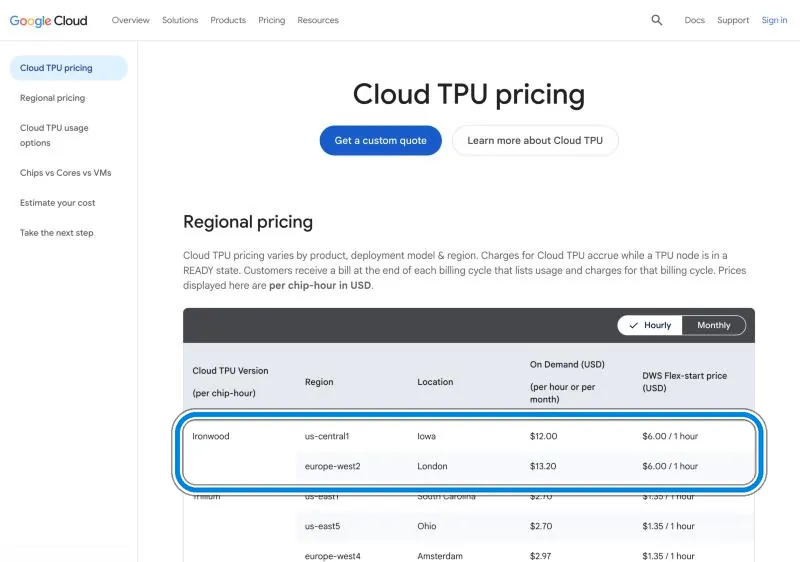
Скриншот: cloud.google.com/tpu/pricing, 15.11.2026. Рамкой выделена строка Ironwood: по прайсу Google Cloud TPU чип-час стоит $12,00 без обязательств в регионе us-central1 (Айова), $13,20 в europe-west2 (Лондон) и $6,00 в режиме DWS Flex-start, где задача ждёт освободившихся мощностей. Цены указаны за один чип в час.Чип и условия (15.11.2026) Цена за чип-час FP8 dense, PFLOPS $ за PFLOPS-час FP8 Ironwood, on-demand, us-central1 $12,00 4,614 $2,60 Ironwood, on-demand, europe-west2 $13,20 4,614 $2,86 Ironwood, DWS Flex-start $6,00 4,614 $1,30 Ironwood, обязательство на 1 год $8,40 4,614 $1,82 Ironwood, обязательство на 3 года $5,40 4,614 $1,17 Nvidia B300, AWS Capacity Blocks (p6-b300, $129,168 за 8 GPU) $16,146 5,0 $3,23 Nvidia B300 в FP4, те же условия $16,146 15 (FP4) $1,08 за PFLOPS FP4 Nvidia B200, AWS Capacity Blocks (p6-b200) $14,208 — — Nvidia H100, AWS on-demand (p5, us-east-1) $6,88 — — AWS Trainium2, Capacity Blocks (trn2.48xlarge, 16 чипов) $2,235 — — AWS Trainium3 н/д: AWS не публикует цену 2,52 н/д
Выводы из таблицы:
- По прайс-листу Ironwood дешевле B300 в FP8 примерно на 20% даже без скидок ($2,60 против $3,23), а с трёхлетним контрактом — почти в 2,8 раза.
- FP4 переворачивает расчёт. Если модель держит качество в FP4, PFLOPS-час B300 стоит $1,08 — дешевле любого варианта Ironwood в FP8. Это та же история, что в тесте InferenceX.
- Сравнение AWS Trainium vs Google TPU по цене сейчас невозможно. У Trainium3 публичной цены нет: AWS продаёт его через инстансы и считает выгоду в цене токена, а не чипа. Известна только блочная ставка Trainium2 — $2,235 за чип-час.
Прайс-лист против стоимости владения: Ironwood и GB300
Прайс-лист — это цена для всех. Крупные клиенты платят по договорам, а сами гиперскейлеры — себестоимость. По модели SemiAnalysis, владение чипом Ironwood обходится внешнему покупателю в $1,21 в час, то есть около $0,26 за PFLOPS-час FP8; у GB300 — $2,31, или около $0,46. Аренду Ironwood у Google на 3 года SemiAnalysis оценивает в $2,00 за чип-час, тогда как публичный прайс за те же 3 года — $5,40. Это не ошибка одной из сторон, а разные базы: открытый прайс против договорной оценки.
Цены на GPU Nvidia в AWS растут
С 1 июля 2026 года AWS подняла ставки Capacity Blocks на GPU Nvidia — у H200 в p5e, например, на 20%, с $39,80 до $47,76 за инстанс-час, — а ставки Trainium повышение не затронуло (по разбору otontechnology). При этом спрос на Trainium тоже высок: Энди Джасси 30 октября 2026 года сказал, что краткосрочные мощности прошлых поколений Trainium продаются с наценкой к первому полугодию. В июльской сетке B300 стоил $14,04 за GPU-час, на 15 ноября 2026 года — $16,146, ещё на 15% выше. Так же на 15% выросли ставки B200 и H100 в блоках: p6-b200 подорожал с $12,355 до $14,208 за GPU-час, p5 — с $5,191 до $5,970.
Кто работает на Trainium и TPU: Anthropic, OpenAI, Meta
Anthropic работает на обоих чипах сразу и подписала договоры на гигаватты мощностей; OpenAI законтрактовала около 2 ГВт Trainium (Trn3 и Trn4, причём Trn4 — с 2027 года); Meta обслуживает модели на TPU в продакшене. Лучший тест для чипа — не бенчмарк, а готовность лаборатории доверить ему модели за миллиарды долларов, и здесь у Amazon и Google сильные аргументы.Клиент и чип Что подписано Дата Чем подтверждено Anthropic — AWS Trainium более $100 млрд на технологии AWS за 10 лет, до 5 ГВт мощностей, Trainium2/3/4 20.04.2026 Amazon, DCD Anthropic — Project Rainier около 500 тыс. чипов Trainium2 в одном кластере, запуск в октябре 2025 10.2025 только данные Amazon Anthropic — Google TPU до 1 млн TPU и свыше 1 ГВт в 2026 году, «десятки миллиардов долларов» 23.10.2025 Anthropic, DCD Anthropic — Google и Broadcom 3,5 ГВт мощностей TPU с 2027 года, условия не раскрыты 07.04.2026 DCD, Tom’s Hardware OpenAI — AWS Trainium около 2 ГВт мощностей Trainium (Trn3 и Trn4), расширение договора на $100 млрд за 8 лет к прежним $38 млрд 27.02.2026 OpenAI, Amazon Meta — Google TPU SGLang на TorchTPU работает в продакшене Meta 22.10.2026 Tom’s Hardware со ссылкой на Google Apple, Meta, Oracle — TPU клиенты TPU; в Oracle Cloud TPU появятся с 2027 года 09.11.2026 Bloomberg через Straits Times
По данным Amazon, Project Rainier насчитывает около 500 тыс. чипов Trainium2; в S-1 Anthropic числа чипов нет, поэтому независимого подтверждения у этой цифры нет. Сама Google 9 ноября 2026 года сообщила, что у TPU уже почти 100 клиентов — от лабораторий передовых моделей до трейдинговых фирм и университетов.
Самая показательная строка — не в таблице, а в проспекте Anthropic. В S-1/A-2 от 10 ноября 2026 года компания описывает свою архитектуру как мульти-чиповую: AWS Trainium, Google TPU, GPU Nvidia и GPU AMD. Совокупные обязательства Anthropic по вычислениям в этой редакции — около $900,9 млрд. Для крупной лаборатории выбор «Amazon Trainium vs Google TPU vs Nvidia GPU» звучит как «и то, и другое, и третье»:
- страховка от дефицита: если один поставщик не успевает, нагрузку переносят на другой;
- торг по цене: три платформы дают аргумент в переговорах с каждой;
- разные задачи: обучение, инференс и эксперименты удобнее ставить на разное железо.
Amazon 30 октября 2026 года, в отчёте за третий квартал, сообщила, что обязательства клиентов по выручке выросли более чем в 20 раз год к году — отдельно у Trainium и отдельно у Graviton. Спрос на ASIC реален — но он добавляется к спросу на Nvidia, а не заменяет его.
Почему Nvidia остаётся лидером: CUDA, NVLink и поставки
Если ASIC так хороши на бумаге, почему Nvidia по-прежнему забирает большую часть денег? Причин пять, и у каждой есть ответ конкурентов — пока частичный.Сильная сторона Nvidia Цифра или факт Как отвечают AWS и Google Новое поколение уже в поставках Rubin: 17,5 PFLOPS FP8 на GPU, поставки с августа 2026 TPU 8i Max и Trainium4 — 2027 Формат FP4 B300: 15 PFLOPS FP4 dense, лидер теста InferenceX в FP4 нативный FP4 появится в TPU 8t и 8i; у Ironwood его нет Софт CUDA стандарт для исследователей и open-source TorchNeuron и TorchTPU переносят PyTorch-код Доступность GPU есть во всех облаках и в продаже ASIC только в облаке владельца Деньги и поставки AWS развернёт ещё 2 млн GPU Nvidia в 2027–2028 своих чипов не хватает, Google арендует мощности у третьих сторон
Софт. Барьер CUDA сужается заметнее, чем год назад. Amazon 20 октября 2026 года открыла TorchNeuron: для запуска PyTorch-модели на Trainium достаточно заменить .to('cuda') на .to('neuron'), а совместимость проверена на 100 тыс. популярных моделей. Google в октябре открыла TorchTPU и бэкенды vLLM и SGLang для TPU. Скептики в InfoQ резонно замечают, что настоящий экзамен — не запуск, а скорость и цена токена на конкретной задаче.
Сеть и партнёрство. Самая неожиданная деталь: Trainium4 получит технологии самой Nvidia. Поддержку интерфейса NVLink Fusion AWS объявила вместе с анонсом Trainium4 2 декабря 2025 года, а память NVHBM — 26 августа 2026 года. Конкурент Nvidia будет соединять свои чипы её же интерфейсом. 26 августа AWS и Nvidia объявили о развёртывании ещё 2 млн GPU Nvidia в 2027–2028 годах. Amazon одновременно соревнуется с Nvidia и остаётся одним из её крупнейших покупателей.
Поставки. Nvidia отгружает Rubin с августа 2026 года и, по пересказу Tom’s Hardware, ожидает, что в третьем квартале он даст около 20% выручки сегмента дата-центров. Alphabet на отчёте 22 июля 2026 года признала, что работает в условиях дефицита мощностей и временно закрывает его арендой у третьих сторон. Отдельное ограничение для Nvidia — экспортный контроль США на поставки в Китай; как его обходят, мы разбирали в материале про санкции на чипы Nvidia и Китай.
Доля рынка ASIC: 27,8% серверов и около 80% выручки у Nvidia
Две цифры, которые в новостях часто противопоставляют, на самом деле не спорят друг с другом. Одна считает штуки, другая — деньги.Метрика ASIC (Trainium, TPU и другие) Nvidia и GPU Источник и дата Доля в поставках ИИ-серверов, штуки (прогноз на 2026) 27,8% — максимум с 2023 года GPU-серверы 69,7% TrendForce, прогноз от 20.01.2026 Доля в выручке рынка ИИ-ускорителей около 16% у кастомных чипов (расчёт zhiyenotes) Nvidia около 75% (Silicon Analysts) — около 80% (оценки отрасли) оценки на ноябрь 2026 Деньги в абсолюте чипы Amazon (Trainium + Graviton): более $25 млрд в год (годовой темп на конец июля 2026) Data Center Nvidia: $89,0 млрд за один квартал 31.07.2026 / 26.08.2026
Почему так получается: чип ASIC дешевле, а внутренние чипы гиперскейлеров учитываются по себестоимости, без маржи Nvidia. По модели SemiAnalysis час владения Ironwood стоит 52% от часа GB300. Поэтому каждый сервер на TPU в штуках весит столько же, сколько сервер на GPU, а в выручке рынка — заметно меньше.
Наш расчёт масштаба: во втором квартале 2027 финансового года (май — июль 2026) сегмент Data Center Nvidia принёс $89,0 млрд, в годовом темпе это около $356 млрд. Весь чиповый бизнес Amazon — более $25 млрд в год (годовой темп на конец июля 2026 года), причём сюда входит и Graviton (серверный процессор, не ИИ-ускоритель). Разница — около 14 раз, не больше: у Amazon цифра «более», а чиповый бизнес растёт трёхзначными темпами. Общая выручка Nvidia за тот же квартал — $96,2 млрд (+106% год к году), прогноз на третий квартал 2027 финансового года (август — октябрь 2026) — $108 млрд ±2% (прогноз от 26 августа).
Поставки ИИ-серверов в целом, по прогнозу TrendForce от января 2026 года, вырастут в 2026 году на 28%. Рынок растёт так быстро, что ASIC набирают долю без падения продаж Nvidia.
Что гонка чипов значит для цен на ИИ: аренда, API и выбор
Конкуренция ASIC и GPU пока не сделала вычисления дешевле. Ставки AWS на GPU Nvidia в блоках с июля по ноябрь 2026 года выросли дважды, Alphabet жалуется на дефицит, а самые сильные ответы конкурентов перенесены на 2027 год. Для читателя это значит три вещи.
- Купить Trainium или TPU нельзя. Оба чипа доступны только в облаках владельцев; Trainium вне AWS Amazon обещает «в конце 2027 года», а TPU-системы в дата-центры клиентов Google начала ставить только в 2026 году.
- Цена API не равна цене чипа. Провайдер модели сам решает, сколько брать за токен, и смешивает разное железо — как Anthropic с четырьмя архитектурами. Удешевление TPU не превращается в скидку на API автоматически.
- Для небольших задач рынок GPU по-прежнему самый гибкий. H100 в AWS стоит $6,88 за GPU-час без обязательств (us-east-1, на 15.11.2026), его можно взять на час, у любого облака и без переписывания кода.
Как выбирать железо под задачу, если вы считаете облачный бюджет команды:Ваша задача На что смотреть Почему Эксперименты, дообучение открытых моделей, небольшой инференс GPU Nvidia (H100, B200) CUDA, переносимость между облаками, почасовая аренда Большой стабильный инференс в FP8 внутри Google Cloud TPU Ironwood $2,60 за PFLOPS-час без обязательств и $1,17 на 3 года; выигрыш в FP8 по InferenceX Нагрузка уже в AWS, код на PyTorch Trainium2 через Capacity Blocks, Trainium3 — по договору блочная ставка Trainium2 с июля не менялась, но краткосрочные мощности дорожают; TorchNeuron снижает цену переезда Модель держит качество в FP4 B300, Rubin $1,08 за PFLOPS-час FP4 у B300; лидер InferenceX в FP4
Ключевое слово — «проверить». Любая из строк таблицы ломается на конкретной модели: прежде чем подписывать годовой контракт, имеет смысл прогнать свою нагрузку на пробной аренде и посчитать цену токена, а не PFLOPS.
Где расходятся источники: цена Ironwood, S-1 Anthropic и FP8 Trainium
Тема свежая, и цифры в ней меняются от редакции к редакции. Вот расхождения, которые мы нашли и как их читаем.
- Цена Ironwood на 3 года: $5,40 за чип-час в прайсе Google против $2,00 в оценке SemiAnalysis. Публичный список против договорной оценки — показываем обе.
- Обязательства Anthropic: $417 млрд в S-1 от 26 октября (по Fortune), $895,4 млрд в поправке от 2 ноября (по DCD) и около $900,9 млрд в S-1/A-2 от 10 ноября 2026 года на sec.gov. Fortune отдельно называл $542–567 млрд — это иная группировка. Берём последнюю редакцию с датой.
- Дата GA Ironwood: блог Google 6 ноября 2025 года обещал общий доступ «в ближайшие недели», а в release notes запись о GA стоит в блоке 2026 года. Отсюда наша формулировка «анонс в апреле 2025, GA и публичный прайс — 2026».
- Доля рынка: 27,8% ASIC в штуках, около 16% по деньгам и 75–80% у Nvidia по выручке — разные метрики, а не противоречие.
- FP8 у Trainium3: AWS не уточняет, dense или sparse её 362 PFLOPS на систему. Сравниваем с dense-цифрами Nvidia и подаём как данные AWS.
- «Ни один ASIC нельзя арендовать»: так пишет обзор Spheron от 19 октября 2026 года, хотя его же таблица указывает «только AWS» для Trainium3 и «только GCP» для Ironwood. Арендовать можно, но только у владельца.
- Project Rainier: «около 500 тыс. чипов» — заявление Amazon, независимого подтверждения нет.
Риски для Trainium, TPU и Nvidia: вендорские цифры, CoWoS и 2027
Слабые места есть у обеих сторон спора, и часть из них проявится уже в ближайшие недели.
- Вендорские цифры без проверки. Рост Trn3 «до 4,4 раза» к Trn2, прирост TPU 8t «до 2,7 раза» в цене обучения и TPU 8i «на 80%» в цене инференса — заявления самих AWS и Google. По данным DailySynapse на 14 ноября 2026 года, независимых тестов новейших систем Google нет.
- 2027 год как обещание. Trainium4, TPU 8tx и 8i Max, Maia 300 и продажа Trainium вне AWS — планы, а не продукты. Сроки таких планов в отрасли сдвигаются регулярно.
- Дефицит упаковки CoWoS. CoWoS — технология TSMC, которая соединяет вычислительный кристалл со стеками HBM; через неё проходят и GPU Nvidia, и TPU. По сводке Data Gravity от 2 июня 2026 года, оценки поставок TPU на 2026 год расходятся от 3,3 млн (DigiTimes Research, с поправкой на лимиты CoWoS) до 4,6 млн штук (Bank of America).
- Риски покупателей. В S-1/A-2 Anthropic прямо называет среди рисков нехватку вычислений и ограничения по критическим ресурсам для них. Даже крупнейший клиент не уверен, что получит всё законтрактованное.
- Смена руководства Nvidia. 12 ноября 2026 года Nvidia раскрыла в форме 8-K, что Дженсен Хуанг ушёл с постов президента и CEO и из совета директоров; временный CEO — финансовый директор Колетт Кресс. Компания заявила, что дорожная карта продолжится без перерывов.
- Привязка к облаку. Модель, оптимизированная под TPU или Trainium, живёт у одного поставщика: переезд обратно на GPU стоит инженерного времени, даже с TorchTPU и TorchNeuron.
Есть и плюсы для конкурентов: Ironwood по независимому тесту выигрывает у Blackwell Ultra в FP8 по цене токена, PyTorch-мосты снижают барьер входа, а Trainium4 с NVLink Fusion сделает возможными гибридные системы из ASIC и GPU.
Что устареет первым. Nvidia отчитается за третий квартал 2027 финансового года (август — октябрь 2026) 17 ноября 2026 года — цифры выручки и доли Rubin обновятся. Следом — общий доступ к Rubin в Google Cloud, следующая сетка цен AWS Capacity Blocks и первые независимые тесты TPU 8t и 8i. Свежие цены смотрите на страницах прайсов Google Cloud TPU и AWS Capacity Blocks.
Частые вопросы про Trainium, TPU и Nvidia
Можно ли купить или арендовать Trainium 3 и TPU вне AWS и Google Cloud?
Купить для своего сервера нельзя, арендовать — только у владельца. Trainium3 доступен в облаке AWS, а продавать Trainium вне AWS Amazon планирует «в конце 2027 года». TPU Google сдаёт в Google Cloud и с 2026 года ставит в дата-центры отдельных клиентов. В Oracle Cloud TPU появятся с 2027 года, по данным Bloomberg.
Чем TPU отличается от GPU Nvidia простыми словами?
GPU — универсальный параллельный процессор, который через CUDA программируют под любые вычисления. TPU — специализированная микросхема (ASIC), где почти весь кристалл занят матричным умножением для нейросетей. Поэтому TPU дешевле и экономнее на типовых задачах ИИ, но менее гибок: например, у Ironwood нет нативного формата FP4, который есть у Nvidia B300.
На чём тренируют Claude: на Trainium, на TPU или на GPU Nvidia?
На всём сразу. В проспекте S-1/A-2 от 10 ноября 2026 года Anthropic описывает мульти-чиповую архитектуру: AWS Trainium, Google TPU, GPU Nvidia и GPU AMD. Крупнейшие договоры — с AWS (до 5 ГВт, Trainium2/3/4) и с Google (до 1 млн TPU, плюс 3,5 ГВт с 2027 года). Какая модель на каком чипе обучалась, компания не раскрывает.
Почему Anthropic использует сразу Trainium, TPU и GPU Nvidia?
Это страховка и рычаг. Мощностей не хватает всем, и Anthropic в S-1/A-2 прямо называет нехватку вычислений риском — несколько поставщиков снижают зависимость от одного. Три-четыре платформы дают аргумент в переговорах о цене. Наконец, обучение, инференс и эксперименты удобнее распределять по разному железу под конкретную задачу.
Когда выйдет Trainium 4 и что известно о его характеристиках?
Поставки Trainium4 ожидаются с 2027 года — так пишет OpenAI, которая заказала мощности на Trn3 и Trn4. Amazon обещает минимум в 6 раз больше производительности в FP4, в 3 раза больше в FP8 и в 4 раза больше пропускной способности памяти, чем у Trainium3. Чип получит NVLink Fusion и память NVHBM от Nvidia. Независимых данных нет.
Дешевле ли TPU и Trainium, чем GPU Nvidia B300 и H100?
Зависит от формата чисел. По нашему расчёту на 15.11.2026, PFLOPS-час FP8 у Ironwood стоит $2,60 по прайсу Google против $3,23 у B300 в AWS Capacity Blocks. Но в FP4 B300 обходится в $1,08. H100 в AWS — $6,88 за GPU-час без обязательств. Цену Trainium3 AWS не публикует, Trainium2 в блоках — $2,235 за чип-час.
Заменят ли чипы Google и Amazon видеокарты Nvidia?
В ближайшие годы — нет, они встраиваются рядом. ASIC займут около 27,8% поставок ИИ-серверов в 2026 году по прогнозу TrendForce, но Nvidia сохраняет около 75–80% выручки рынка. Сами конкуренты закупают Nvidia: AWS развернёт ещё 2 млн её GPU в 2027–2028 годах, а Trainium4 использует интерфейс NVLink Fusion.