
Claude Sonnet 5.5 коротко: кому брать, цена и главный соперник
Claude Sonnet 5.5 — модель среднего класса Anthropic, вышедшая 28 сентября 2026 года. Она стоит столько же, сколько Claude Sonnet 5: $2 за миллион входных токенов и $10 за миллион выходных (цены на 21 октября 2026 года). Мы сверили обещания Anthropic с независимыми замерами, прогнали новую модель и Sonnet 5 на трёх одинаковых задачах и посчитали, когда новая модель реально обходится дешевле.
- Claude Sonnet 5.5 коротко: кому брать, цена и главный соперник
- Что изменилось в Claude Sonnet 5.5 по сравнению с Sonnet 5
- Цена Claude Sonnet 5.5: API, кэш, Batch и подписки Claude
- Бенчмарки по данным Anthropic: где новая модель выросла сильнее всего
- Независимые замеры: Artificial Analysis, Vals AI и Epoch AI
- Сколько Sonnet 5.5 тратит на задачу: уровень effort решает счёт
- Sonnet 5.5 против GPT-6.1 Sol и Grok 4.7: цены, индексы, скорость
- Наша проверка Sonnet 5.5 и Sonnet 5 на трёх одинаковых задачах
- Отзывы разработчиков: CodeRabbit, ComputingForGeeks, партнёры
- Когда брать Sonnet 5.5, а когда Opus 5.5, GPT-6.1 Sol или Grok 4.7
- Переход с Sonnet 5 на Sonnet 5.5: что сломается в коде
- Где модель подводит: кибер-риски, факты без поиска, счёт на max
- Вопросы и ответы о Claude Sonnet 5.5
- Кому подходит: повседневному программированию и багфиксам, ревью каждого пулл-реквеста, работе с документами, таблицами и слайдами, агентам с длинным контекстом больше 272 тыс. токенов.
- Главный соперник — GPT-6.1 Sol с той же ценой $2/$10. По индексу Artificial Analysis Sonnet 5.5 выше (56 против 52 на максимальном уровне усилия), но задача индекса у Sol обходится в $0,72, а у Sonnet 5.5 — в $5,46.
- Главная оговорка: обещание «до 30% дешевле за задачу» не работает на максимальном уровне усилия: там Sonnet 5.5 обходится дороже Sonnet 5 — $5,46 против $5,09 за задачу индекса Artificial Analysis.
- Кому не подходит: тем, кто занимается тестированием на проникновение (рискованные кибер-запросы модель передаёт Sonnet 5), и тем, кто задаёт справочные вопросы без веб-поиска — по фактам «из памяти» она слабее старших моделей.
- Когда нужна старшая модель: для сложной открытой работы сама Anthropic рекомендует Claude Opus 5.5 — она вдвое дороже ($4/$20), но, по словам компании, «остаётся заметно сильнее» в задачах, где нужно долгое самостоятельное суждение.
Один термин понадобится во всей статье. Уровень усилия (effort) — настройка, которая определяет, сколько модель рассуждает перед ответом. У Sonnet 5.5 их пять: low, medium, high, xhigh и max. Чем выше уровень, тем больше выходных токенов и тем выше счёт. В Claude Code и приложениях Claude по умолчанию стоит medium, в API — high.
Что изменилось в Claude Sonnet 5.5 по сравнению с Sonnet 5
Sonnet 5 вышла 30 июня 2026 года, Sonnet 5.5 — через три месяца. Цена токенов не изменилась: вводные $2/$10 у Sonnet 5 Anthropic сделала постоянными, и Sonnet 5.5 их унаследовала. Всё остальное сдвинулось заметно. Сравнение Claude Sonnet 5.5 vs 5 по опубликованным данным:Параметр Sonnet 5 Sonnet 5.5 Источник Дата выхода 30.06.2026 28.09.2026 Anthropic Вход / выход, $ за 1 млн токенов 2 / 10 2 / 10 Anthropic Чтение кэша, $ за 1 млн 0,20 0,10 Anthropic Контекст / максимум ответа 1 млн / 128 тыс. 1 млн / 128 тыс. (300 тыс. в Batch, бета) документация Срез знаний — июнь 2026 документация Скорость вывода, max (Artificial Analysis) 81,6 токена/с 135,5 токена/с AA, 21.10.2026 Индекс Artificial Analysis, max 38 56 AA, 21.10.2026 Стоимость задачи индекса, max $5,09 $5,46 AA, 21.10.2026 Terminal-Bench 4.0 (данные Anthropic) 10,3% 70,6% анонс SWE-Bench Pro (system card) 63,2 81,3 system card Global MMLU, 42 языка 89,2% 92,1% system card Режим рассуждений можно выключить выключить нельзя, минимум — between_toolsдокументация Кибер-ограничения без отдельного отката рискованные запросы откатываются на Sonnet 5 анонс Срок поддержки остаётся активной не раньше 28.09.2027 документация
Что из этого важно на практике. Во-первых, чтение кэша подешевело вдвое — с $0,20 до $0,10 за миллион токенов. Кэш — это повторно отправленная часть контекста, которую модель уже обработала: системная инструкция, документ, история диалога. В агентной работе на него приходится большая часть входа, поэтому снижение здесь заметнее, чем выглядит в прайсе. В части обзоров по-прежнему встречается цифра $0,20 — это цена Sonnet 5, у Sonnet 5.5 официально $0,10.
Во-вторых, скорость. Anthropic обещает «на 30% и больше быстрее». Независимый замер это подтверждает с запасом: Artificial Analysis на 21 октября 2026 года видит 135,5 токена в секунду против 81,6 у Sonnet 5 — прирост 66%.
В-третьих, режим рассуждений теперь нельзя выключить совсем. Самая «тихая» настройка — between_tools: модель не думает перед ответом, но рассуждает между вызовами инструментов. Для тех, кто держал Sonnet 5 с выключенным мышлением, это ломающее изменение — подробности в разделе о переходе.
Цена Claude Sonnet 5.5: API, кэш, Batch и подписки Claude
В API платят за токены — кусочки текста по 3–4 символа. Отдельно считаются вход (ваш запрос и контекст), выход (ответ вместе с рассуждениями) и кэш. Полный прайс Sonnet 5.5 по документации Anthropic на 21 октября 2026 года:Статья расходов Цена за 1 млн токенов Вход $2 Выход $10 Чтение кэша $0,10 Запись в кэш на 5 минут $2,50 Запись в кэш на 1 час $4 Batch API (асинхронно) скидка 50%: $1 вход / $5 выход Обработка только в США ( inference_geo)множитель ×1,1 на все статьи Длинный контекст весь 1 млн по одной ставке
Последняя строка — структурное преимущество. Документация прямо пишет: запрос на 900 тыс. токенов тарифицируется по той же ставке, что и запрос на 9 тыс. У GPT-6.1 Sol и Grok 4.7 есть пороги, после которых дорожает весь запрос, — об этом в разделе сравнения.
Пример месячного счёта за API
Возьмём приложение, которое за месяц отправляет 40 млн входных токенов, из них 75% — чтение кэша, и получает 8 млн выходных:Строка счёта Sonnet 5.5 Sonnet 5 Обычный вход: 10 млн × $2 $20 $20 Чтение кэша: 30 млн $3 (по $0,10) $6 (по $0,20) Выход: 8 млн × $10 $80 $80 Итого за месяц $103 $106 Через Batch API (−50%) $51,50 — С обработкой только в США (×1,1) $113,30 —
Вывод из таблицы: при одинаковом объёме токенов экономия на кэше скромная — 3%. Основные деньги — выходные токены, а их количество зависит от уровня усилия. Поэтому главный рычаг экономии у Sonnet 5.5 не прайс, а настройка effort (следующие разделы).
Подписки Claude и бесплатный доступ
Для работы в чате и Claude Code вместо оплаты токенов есть подписки. На странице тарифов Anthropic на 21 октября 2026 года:
| Тариф | Цена | Для кого |
|---|---|---|
| Free | $0 | попробовать модель |
| Pro | $17 в месяц при оплате за год ($200 сразу) или $20 помесячно | регулярная работа одного человека |
| Max | от $100 в месяц | интенсивная работа, большие лимиты |
PCWorld сообщает, что Sonnet 5.5 стала моделью по умолчанию для бесплатных пользователей Claude. На странице тарифов Anthropic это прямо не указано, поэтому считайте это данными издания, а не официальным обещанием. Как устроены лимиты подписок в работе с кодом и как их растянуть, мы разбирали в материале про лимиты Claude Code.
Доступ из Украины. По официальному списку Anthropic, Claude и API работают в Украине, кроме Крыма, Донецкой, Херсонской, Луганской и Запорожской областей.
Бенчмарки по данным Anthropic: где новая модель выросла сильнее всего
Бенчмарк (англ. benchmark) — стандартный набор задач, на котором модели сравнивают в одинаковых условиях. Ниже — бенчмарки Claude Sonnet 5.5 из анонса и system card Anthropic от 28 сентября 2026 года. Все цифры этой таблицы — данные вендора, независимые замеры идут отдельным разделом.Тест и что он проверяет Sonnet 5.5 Sonnet 5 Opus 5.5 GPT-6 Sol Terminal-Bench 4.0 — агент в терминале 70,6% 10,3% 66,4% (xhigh) н/д FrontierCode 1.1 — сложные задачи по коду 46,2% (max) / 52,1% (xhigh) 42,4% 54,4% 49,3% CursorBench 4.0 — работа в редакторе Cursor 55,5% 34,1% 57,8% н/д GDPval-AA v2.1 — офисная работа, рейтинг Elo 1844 1449 1846 1487 Humanity’s Last Exam — экзамен с инструментами 64,5% 54,9% 67,7% н/д OSWorld 2.1 — управление компьютером 80,1% 57,0% 81,8% н/д Chartography — чтение графиков без инструментов 61,6% 15,6% 64,4% 53,6% SWE-Bench Pro — реальные задачи из репозиториев 81,3 63,2 89,9 н/д Global MMLU — знания на 42 языках 92,1% 89,2% 94,3% н/д
Сильнее всего выросли агентные навыки. Terminal-Bench 4.0 — с 10,3% до 70,6%, это выше даже Opus 5.5 по данным той же Anthropic. Chartography (чтение графиков) — с 15,6% до 61,6%. OSWorld, где модель управляет компьютером через интерфейс, — с 57,0% до 80,1%. В офисной работе (GDPval-AA) Sonnet 5.5 почти догнала Opus 5.5: 1844 против 1846 Elo.
Три оговорки к таблице, без которых её легко прочитать неверно:
- На FrontierCode уровень max хуже xhigh (46,2% против 52,1%). Anthropic объясняет это тем, что на max модель чаще запускала подагентов-ревьюеров, и в двух разобранных случаях это привело к таймауту или правкам за пределами задачи. Больше усилия — не всегда лучше результат.
- GPT-6 Sol в таблице — прошлая версия, а не GPT-6.1 Sol. Сравнение с актуальной моделью OpenAI — только у независимых площадок.
- В паре Claude Sonnet 5.5 vs Opus 5.5 старшая модель впереди почти везде, кроме Terminal-Bench. Сама Anthropic пишет, что Opus 5.5 «остаётся заметно сильнее в сложной открытой работе, требующей долгого суждения».
Независимые замеры: Artificial Analysis, Vals AI и Epoch AI
Вендорские таблицы показывают модель в лучших условиях. Ниже — замеры трёх независимых площадок, которые гоняют все модели по одной методике. Даты важны: рейтинги обновляются с каждой новой моделью.
Карточка модели на Artificial Analysis на 21 октября 2026 года, режим max. В рамках — две вещи, которые стоит держать в голове вместе: слева индекс интеллекта 56 и второе место из 214 моделей, справа цена задачи индекса $5,46 и многословность — 420 млн выходных токенов на прогон индекса при медиане 82 млн. Модель сильная и быстрая, но на максимальном усилии пишет очень много.Площадка и метрика Sonnet 5.5 Для сравнения Дата замера Artificial Analysis, индекс интеллекта (max) 56, 2-е место из 214 Opus 5.5 — 58, GPT-6.1 Sol — 52, Grok 4.7 — 46, Sonnet 5 — 38 21.10.2026 Artificial Analysis, скорость вывода (max) 135,5 токена/с Grok 4.7 — 89,7, Sonnet 5 — 81,6, GPT-6.1 Sol — 54,3 21.10.2026 Artificial Analysis, выходные токены на индекс (max) 420 млн Sonnet 5 — 370 млн, Grok 4.7 — 240 млн, GPT-6.1 Sol — 67 млн 21.10.2026 Artificial Analysis, время до первого токена (max, с учётом рассуждений) 406 с — 21.10.2026 Vals Index 70,85%, 1-е место из 23 GPT-6.1 Sol — 63,94% (7-е), Grok 4.7 — 58,56% (11-е) 21.10.2026 Vals AI, Terminal-Bench 4.0 64,14% GPT-6.1 Sol — 55,05%, Grok 4.7 — 28,79% 21.10.2026 Vals AI, CyberBench v1.1 59,58%, 36-е место из 47 — 21.10.2026 Epoch AI, индекс возможностей ECI 166, 6-е место из 253 лучший результат — 169 21.10.2026 Epoch AI, SimpleQA Verified (факты без поиска) 47% Opus 5.5 — 72% 21.10.2026 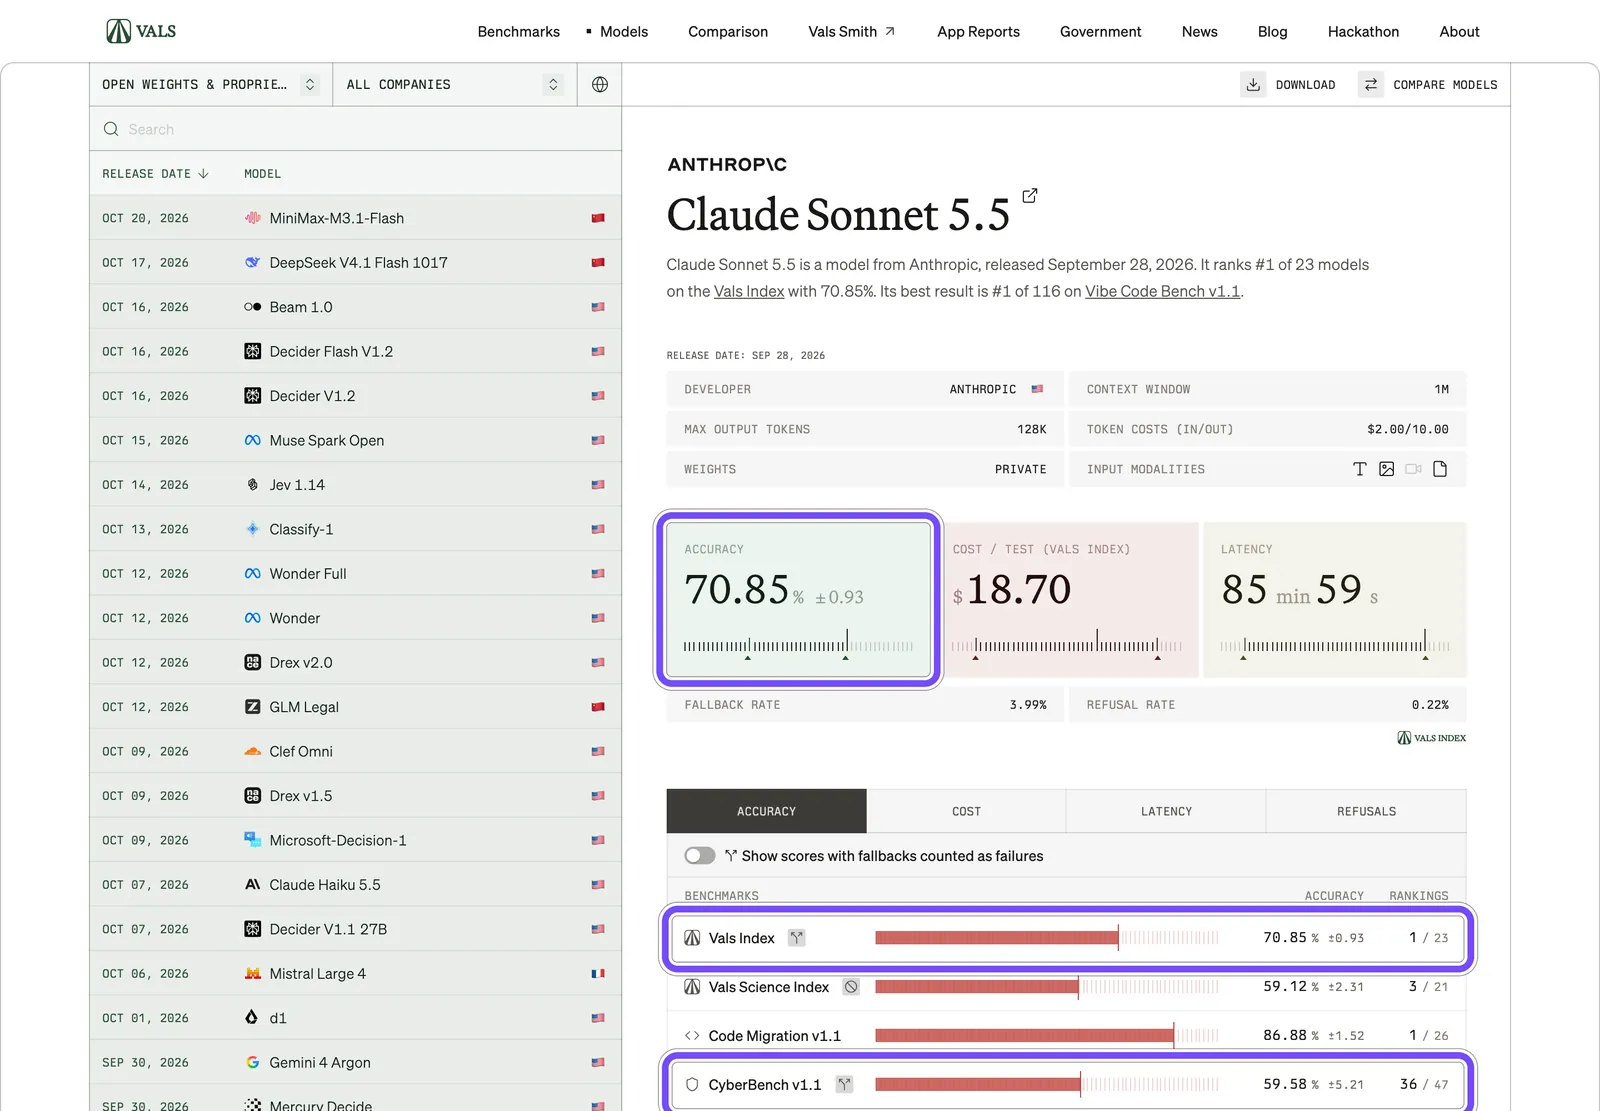
На Vals AI на 21 октября 2026 года Sonnet 5.5 — первая из 23 моделей в сводном Vals Index с 70,85% (верхняя и средняя рамки на кадре). Нижняя рамка — CyberBench v1.1: 59,58% и только 36-е место из 47. Это след кибер-ограничений: Vals запускала модель с откатом на Sonnet 5, и на CyberBench на откат ушли 54 задачи из 116. Если считать их проваленными, результат падает с 59,58% до 41,97%. По всему Vals Index доля откатов — 3,99%. Средняя задача Vals Index обходится площадке в $18,70 — против $3,61 у GPT-6.1 Sol и $11,63 у Grok 4.7.
Что видно, если положить независимые цифры рядом с вендорскими:
- Terminal-Bench 4.0 ниже заявленного. Anthropic пишет 70,6%, прогон Vals AI дал 64,14%. Разница в 6,5 пункта — обычное дело для разных обвязок и настроек, но опираться стоит на независимую цифру. Отрыв от GPT-6.1 Sol (55,05%) при этом сохраняется.
- Лидерство в индексах подтверждается. И Artificial Analysis, и Vals AI ставят Sonnet 5.5 на первое-второе место, выше GPT-6.1 Sol и Grok 4.7. Выше неё в индексе AA только Opus 5.5.
- Слабое место — знания без поиска. Epoch намерила 47% на SimpleQA Verified против 72% у Opus 5.5. System card Anthropic сообщает о том же: по шкале AA-Omniscience у Sonnet 5.5 итоговый балл 0,35 — лучше, чем у Sonnet 5, но модель чуть чаще даёт неверный ответ там, где стоило бы сказать «не знаю».
Чего мы не нашли. Свежего места в LMArena на 21 октября 2026 года нет: страница рейтинга недоступна для проверки, а кэшированные копии устарели. Отдельной оценки государственных институтов безопасности ИИ (американского CAISI или британского AISI) для Sonnet 5.5 тоже нет — в system card упомянут только бенчмарк Gray Swan, созданный вместе с ними.
Сколько Sonnet 5.5 тратит на задачу: уровень effort решает счёт
Anthropic пишет, что в её тестах Sonnet 5.5 обходится «до 30% дешевле за задачу», чем Sonnet 5. Ключевое слово — «до». Цена задачи — это прайс, умноженный на количество токенов, а количество токенов определяется уровнем усилия. Artificial Analysis прогнала индекс на разных уровнях, и картина получается такая (на 21 октября 2026 года):Модель и уровень усилия Индекс AA Стоимость задачи индекса Центов за 1 балл индекса Sonnet 5.5, max 56 $5,46 9,8 Sonnet 5.5, xhigh 52 $2,01 3,9 Sonnet 5.5, high 47 $0,88 1,9 Sonnet 5, max 38 $5,09 13,4 GPT-6.1 Sol, max 52 $0,72 1,4 GPT-6.1 Sol, high 50 $0,32 0,6 Grok 4.7, xhigh 46 $3,74 8,1
Последний столбец — наш расчёт: стоимость задачи, делённая на балл индекса. Он отвечает на вопрос «сколько стоит единица качества» — в англоязычных сравнениях это называют соотношением price-performance. Для Claude Sonnet 5.5 оно сильно зависит от выбранного уровня усилия.
Что из этого следует:
- На max Sonnet 5.5 дороже Sonnet 5 за задачу — на 7% ($5,46 против $5,09). Обещанной экономии здесь нет.
- Но за единицу качества она дешевле на 27% (9,8 цента за балл против 13,4). То есть «−30%» почти выполняется, если считать не задачи, а результат: за те же деньги вы получаете модель на 18 баллов умнее.
- Переход с max на xhigh срезает счёт в 2,7 раза ценой 4 баллов индекса. С max на high — в 6,2 раза ценой 9 баллов.
- GPT-6.1 Sol дешевле при близком качестве. Sonnet 5.5 на xhigh набирает те же 52 балла, что Sol на max, но стоит $2,01 против $0,72 — в 2,8 раза дороже. Причина — многословность: на прогон индекса Sol тратит 67 млн выходных токенов, Sonnet 5.5 на max — 420 млн.
Независимые тесты на реальных задачах показывают ту же зависимость от уровня усилия:
- CodeRabbit, ревью кода (28 сентября 2026 года): вызовы модели обошлись в $0,46 за ревью против $1,16 у Sonnet 5 — на 60% дешевле, потому что Sonnet 5.5 тратит на ревью намного меньше токенов.
- ComputingForGeeks, DevOps-задачи: девять генераций (манифест Kubernetes, bash-скрипт и конфигурация OpenTofu, по три прогона) на уровне medium обошлись в $0,0665, на max — в $1,3585, то есть в 20 раз дороже при одинаковом результате. Авторы советуют держать max только для задач, где он доказанно окупается.
Практический вывод: в API по умолчанию стоит high. Для рутины явно задайте medium, а xhigh и max включайте точечно — на задачах, где вы проверили, что они дают прирост.
Sonnet 5.5 против GPT-6.1 Sol и Grok 4.7: цены, индексы, скорость
Сравнение Sonnet 5.5 с GPT-6.1 Sol и Grok 4.7 — главный выбор осени 2026 года в среднем ценовом классе. Все три вышли с разницей в восемь дней: Grok 4.7 — 21 сентября, Sonnet 5.5 — 28 сентября, GPT-6.1 Sol — 29 сентября 2026 года на DevDay OpenAI. Цены и замеры на 21 октября 2026 года:Параметр Sonnet 5.5 GPT-6.1 Sol Grok 4.7 Дата выхода 28.09.2026 29.09.2026 21.09.2026 Вход / выход, $ за 1 млн 2 / 10 2 / 10 2 / 6 Чтение кэша, $ за 1 млн 0,10 0,10 0,50 Контекст 1 млн, одна ставка 1,05 млн; запрос свыше 272 тыс. — вход и кэш ×2, выход ×1,5 на весь запрос 500 тыс.; запрос от 200 тыс. — $4 / $1 кэш / $12 Максимум ответа 128 тыс. 128 тыс. без лимита (по документации xAI) Срез знаний июнь 2026 30 апреля 2026 май 2026 Индекс Artificial Analysis (верхний уровень) 56 (max) 52 (max) 46 (xhigh) Стоимость задачи индекса AA $5,46 $0,72 $3,74 Скорость вывода (AA) 135,5 токена/с 54,3 токена/с 89,7 токена/с Vals Index 70,85%, 1-е место 63,94%, 7-е 58,56%, 11-е Terminal-Bench 4.0 (Vals AI) 64,14% 55,05% 28,79% (xAI заявляет 37,6%) Открытые веса нет нет нет
Цены кэша и порог длинного контекста у Grok 4.7 — по странице цен в документации xAI: если промпт достигает 200 тыс. токенов, весь запрос оплачивается по повышенной ставке.
Против GPT-6.1 Sol. Цена токена одинаковая, качество у Sonnet 5.5 выше в обоих независимых индексах, скорость — в 2,5 раза выше. Но Sol гораздо экономнее расходует токены и поэтому дешевле за задачу в разы. Если ваша нагрузка — тысячи коротких агентных прогонов, где решает цена, Sol выгоднее. Предшественницу этой модели мы подробно разбирали в обзоре GPT-6 Sol и Luna.
Claude Sonnet 5.5 vs Grok 4.7. У Grok дешевле выход ($6 против $10), но по обоим независимым индексам он ниже и Sonnet 5.5, и GPT-6.1 Sol, а на Terminal-Bench 4.0 в прогоне Vals AI отстаёт более чем вдвое. Заявленные xAI 37,6% на этом тесте независимый замер не подтвердил: у Vals AI вышло 28,79%. Предыдущую версию мы подробно разбирали в обзоре Grok 4.5.
Длинный контекст: где Sonnet 5.5 дешевле в разы
Пороги у GPT-6.1 Sol (272 тыс.) и Grok 4.7 (200 тыс.) включают повышенную цену на ВЕСЬ запрос. Агент, который загружает в контекст большой репозиторий, переходит порог в начале сессии и остаётся за ним. Мы посчитали один шаг агента при одинаковом числе токенов: 90% контекста из кэша, ответ 4 тыс. токенов, без записи в кэш.Шаг агента Sonnet 5.5 GPT-6.1 Sol Grok 4.7 Контекст 150 тыс. токенов (ниже всех порогов) $0,084 $0,084 $0,122 Контекст 400 тыс. токенов (выше порогов) $0,156 $0,292 $0,568 Сессия из 100 шагов по 400 тыс. $15,60 $29,20 $56,80
Ниже порогов Sonnet 5.5 и Sol стоят одинаково. Выше — Sonnet 5.5 почти вдвое дешевле Sol и в 3,6 раза дешевле Grok 4.7. Оговорка та же, что в разделе про effort: расчёт исходит из одинакового числа токенов, а на деле GPT-6.1 Sol пишет намного короче. В коротких задачах с большим выводом Sol может оказаться дешевле, в длинных сессиях с большим контекстом выигрывает Sonnet 5.5.
Наша проверка Sonnet 5.5 и Sonnet 5 на трёх одинаковых задачах
21 октября 2026 года мы прогнали три одинаковых задания через Claude Code CLI версии 2.1.306 на четырёх конфигурациях: Sonnet 5.5 на уровнях low, medium и high и Sonnet 5 с настройками по умолчанию. Условия одинаковые: короткий нейтральный системный промпт, без инструментов, без сохранения сессии. Это по одному прогону на конфигурацию — иллюстрация поведения, а не бенчмарк: один прогон не усредняет случайность. Уровни xhigh и max мы не гоняли — на простых задачах они дают только рост счёта, это показали независимые тесты выше.Задача и что проверяли Sonnet 5.5 low Sonnet 5.5 medium Sonnet 5.5 high Sonnet 5 Код merge_intervals + тесты: наш набор из 12 проверок12 из 12 12 из 12 12 из 12 12 из 12 …собственных тестов модели (все прошли) 14 16 16 10 …выходных токенов / время ответа 1036 / 10,1 с 1142 / 10,2 с 1174 / 9,2 с 911 / 11,9 с Объяснение на украинском, лимит 3–4 предложения 4 — уложилась 5 — превысила 5 — превысила 4 — уложилась Расчёт счёта API (верный ответ — $103) верно, 120 токенов верно, 119 токенов верно, 219 токенов верно, 198 токенов
Задание 1 — код. Написать на Python функцию объединения отрезков merge_intervals и тесты pytest, вывести один блок кода. Все четыре функции прошли наш общий набор из 12 случаев (пустой список, соприкасающиеся и вложенные отрезки, дубли). Все модели выполнили требование «только код». Разница — в старательности: Sonnet 5.5 написала 14–16 собственных тестов, Sonnet 5 — 10. И Sonnet 5.5 ответила чуть быстрее на всех уровнях.
Задание 2 — объяснение на украинском. В 3–4 предложениях без списков объяснить новичку, чем кэширование промптов отличается от обычного запроса. Все ответы написаны грамотным украинским языком без русизмов, суть передана верно, у всех есть удачная бытовая аналогия (закладка в книге, конспект). Но на medium и high Sonnet 5.5 вышла за лимит — пять предложений. На medium пятым стал практический совет ставить неизменную часть запроса в начало, на high модель разбила объяснение на два предложения. Совет полезный, однако лимит длины нарушен в обоих случаях. Sonnet 5 и Sonnet 5.5 на low уложились в четыре.
Задание 3 — расчёт. Посчитать месячный счёт за API из раздела о ценах (40 млн входных токенов, 75% из кэша, 8 млн выходных). Все четыре конфигурации дали верные $103. Sonnet 5.5 на medium уложилась в 119 выходных токенов против 198 у Sonnet 5 — на простом расчёте новая модель заметно лаконичнее.
Стоимость прогонов из CLI мы не сравниваем: её искажает разовая запись контекста самого Claude Code в кэш на первом вызове (около 42 тыс. токенов). Итог совпадает с независимыми данными: на простых задачах качество двух моделей одинаковое, Sonnet 5.5 старательнее в тестах и быстрее, а строгий формат ответа на medium и high стоит проверять.
Отзывы разработчиков: CodeRabbit, ComputingForGeeks, партнёры
Отзывы с открытой методикой ценнее цитат из пресс-релиза: в них видно, на чём и как мерили. Нашлось два таких разбора.
CodeRabbit — ревью кода (28 сентября 2026 года). Сервис автоматического ревью прогнал модель на 13 самых сложных известных багах и на 44 реальных пулл-реквестах открытых проектов:
- нашла 6 багов из 13 против 4 у Sonnet 5 при той же точности замечаний — 41,2% против 40,0%;
- среднее ревью заняло 6:33 против 13:31 у Sonnet 5 — вдвое быстрее;
- вызовы модели стоили около $0,46 за ревью против $1,16 — на 60% дешевле;
- Opus 5.5 на тех же 13 случаях нашла 8 багов на стандартном уровне и 10 на max.
Сами авторы предупреждают: 13 случаев — маленькая выборка, а четыре из них не решила ни одна конфигурация Sonnet. Вывод CodeRabbit: это первый Sonnet, который они рассматривают для основного ревью каждого пулл-реквеста, но заменой Opus 5.5 он не является. Если хотите настроить такое ревью у себя, у нас есть разбор, как подключить Claude Code к GitHub с авто-ревью PR.
ComputingForGeeks — DevOps (28 сентября 2026 года). Авторы генерировали манифесты Kubernetes, bash-скрипты и конфигурации OpenTofu, по три прогона на конфигурацию. Все файлы прошли линтеры, но реальный деплой в кластер k3s показал разницу: у Sonnet 5 ни один из трёх деплоев не заработал, у Sonnet 5.5 на medium и выше — все три. Уровень low оказался единственной настройкой Sonnet 5.5, которая выдала нерабочие манифесты. А max дал тот же результат, что medium, за двадцатикратную цену.
Отзывы партнёров из анонса Anthropic. Это примеры, которые отобрала сама компания, — лучшие случаи, а не среднее:
- Balyasny Asset Management: на 2441 финансовой задаче Sonnet 5.5 обошла Sonnet 5 и тратила около 121 тыс. токенов на ответ против 497 тыс.;
- Base44: на 118 сборках приложений — качество на уровне Opus 5 за 3,6 итерации против 7,7 у Opus 5;
- Zendesk: тикеты обрабатываются на 20% быстрее;
- Slack: около 14% меньше выходных токенов без правки промптов.
Когда брать Sonnet 5.5, а когда Opus 5.5, GPT-6.1 Sol или Grok 4.7
Решение по сценариям на 21 октября 2026 года:Сценарий Что брать Почему Повседневный код, багфиксы, Claude Code Sonnet 5.5 на medium качество выше Sonnet 5 при той же цене токена, effort по умолчанию в Claude Code — medium Ревью каждого пулл-реквеста Sonnet 5.5 CodeRabbit: больше найденных багов, ревью вдвое быстрее и на 60% дешевле Ревью высокорисковых изменений, архитектура Opus 5.5 8–10 багов из 13 против 6; вдвое дороже ($4/$20) Документы, таблицы, слайды Sonnet 5.5 GDPval-AA 1844 Elo — почти как Opus 5.5 Агенты с контекстом больше 272 тыс. токенов Sonnet 5.5 одна ставка на весь 1 млн, у конкурентов наценка на весь запрос Массовые короткие агентные прогоны GPT-6.1 Sol $0,72 за задачу индекса AA против $2,01 у Sonnet 5.5 при равном индексе Справочные вопросы без веб-поиска Opus 5.5 или Sonnet 5.5 с веб-поиском у Sonnet 5.5 слабее знания «из памяти»: SimpleQA Verified 47% против 72% у Opus 5.5 Дешёвый вывод больших текстов Grok 4.7 выход $6 против $10, но ниже по независимым индексам Тесты на проникновение, исследования уязвимостей не Sonnet 5.5 рискованные кибер-запросы откатываются на Sonnet 5
Короткая версия для выбора Claude Sonnet 5.5 vs GPT-6.1 Sol: если нужна лучшая модель класса и скорость — Sonnet 5.5; если нужна минимальная цена за выполненную задачу при близком качестве — GPT-6.1 Sol. Если вы уже на Sonnet 5, переходить стоит: качество выше, а при уровне medium счёт почти не изменится (у ComputingForGeeks — $0,0665 против $0,0650), а на ревью кода у CodeRabbit упал на 60%. Но сначала проверьте свой код по списку ниже.
Переход с Sonnet 5 на Sonnet 5.5: что сломается в коде
Через API Sonnet 5.5 подключается сменой идентификатора на claude-sonnet-5-5. Но документация Anthropic перечисляет пять ломающих изменений для кода, который уже работает на Sonnet 5.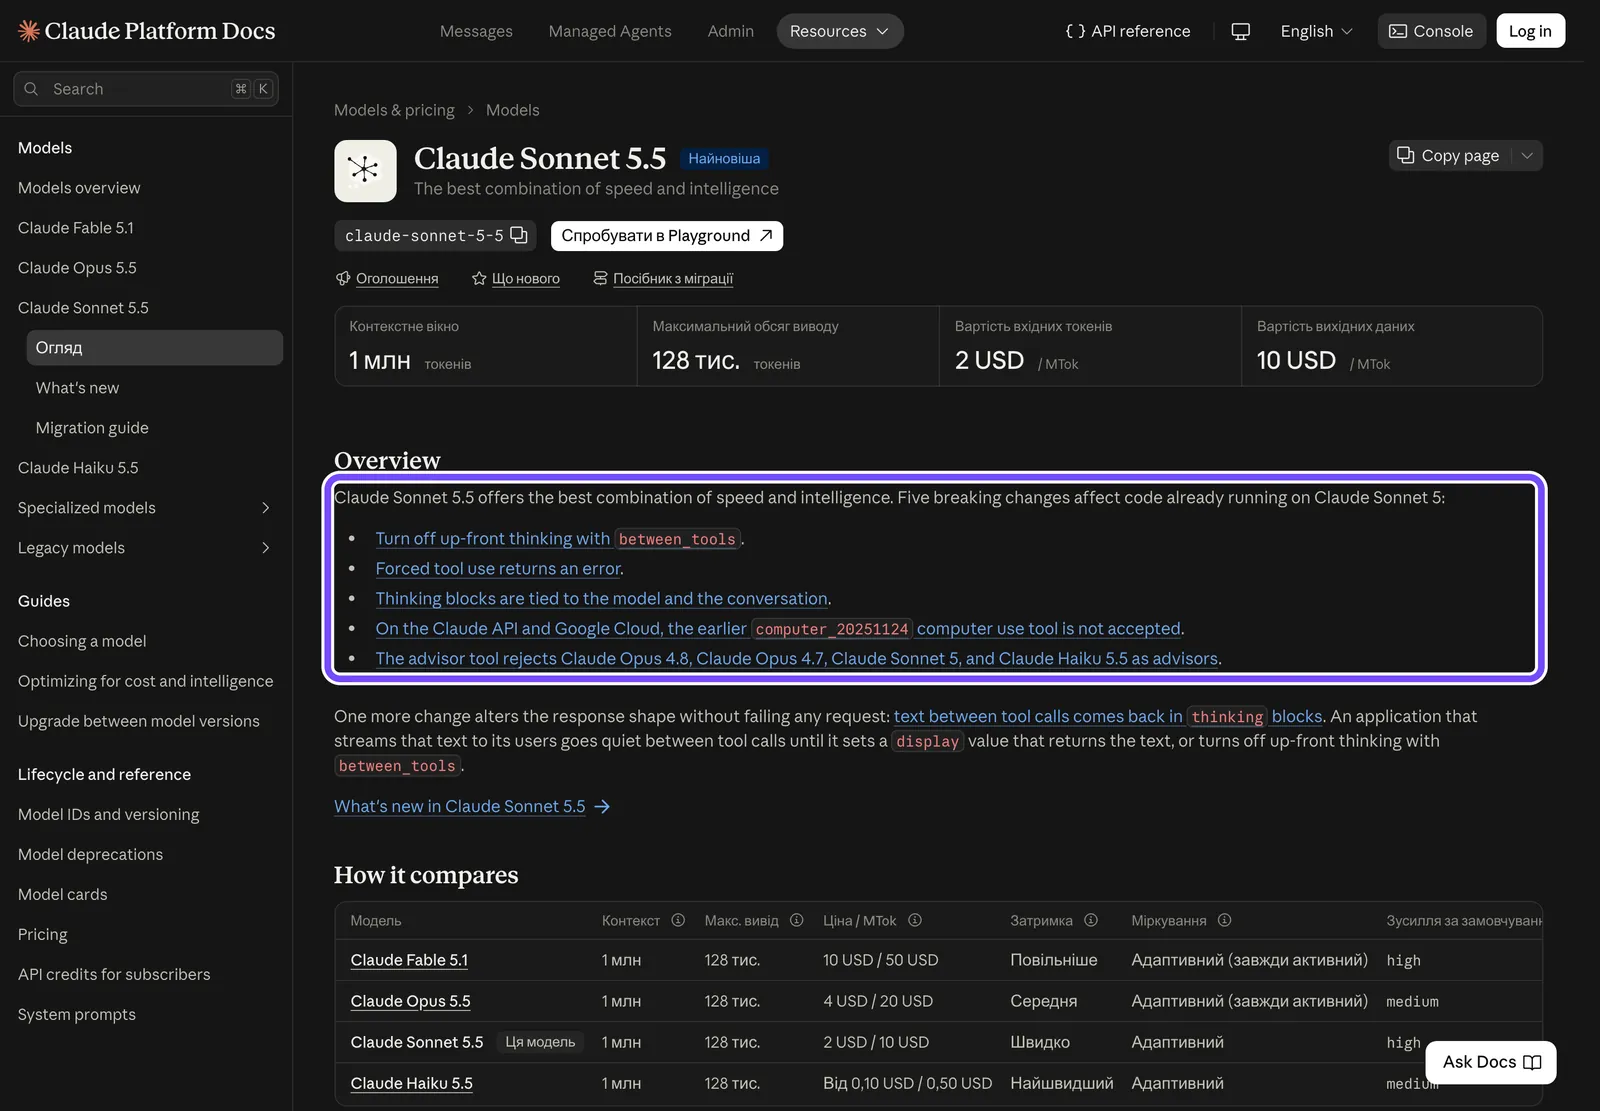
Список на кадре снят со страницы модели в документации Claude 21 октября 2026 года. По шагам, что проверить:
- Выключенное мышление больше не работает. Запрос с
thinking: {type: "disabled"}возвращает ошибку. Минимальная настройка —between_tools: она убирает рассуждения перед ответом, но оставляет их между вызовами инструментов. Работает она на уровне усилия high и ниже. - Принудительный вызов инструмента возвращает ошибку. Если вы заставляли модель вызвать конкретный инструмент через
tool_choice, перейдите на structured outputs — структурированный ответ по заданной схеме. - Блоки рассуждений привязаны к модели и диалогу. Переносить их из диалогов с другой моделью нельзя.
- Старый инструмент управления компьютером
computer_20251124не принимается на Claude API и Google Cloud — обновите интеграции computer use. - Инструмент advisor больше не принимает Opus 4.8, Opus 4.7, Sonnet 5 и Haiku 5.5 в роли советника.
Ещё одно изменение запрос не роняет, но меняет форму ответа: текст между вызовами инструментов приходит в блоках рассуждений. Приложение, которое транслирует этот текст пользователю, «замолкает» между вызовами, пока не задан параметр display или не включён between_tools.
Две вещи не новые, но о них стоит помнить при переезде. Нестандартные temperature, top_p и top_k дают ошибку 400 — так было и у Sonnet 5, поэтому рабочий код их уже не шлёт. И задайте уровень усилия явно: в API по умолчанию high, а для рутины, по данным ComputingForGeeks, medium даёт тот же результат дешевле.
Sonnet 5 при этом остаётся доступной, а Sonnet 5.5 Anthropic обещает поддерживать не раньше чем до 28 сентября 2027 года — время на переход есть.
Где модель подводит: кибер-риски, факты без поиска, счёт на max
- Кибербезопасность. Sonnet 5.5 — первая модель линейки Sonnet с защитой уровня Opus: рискованные кибер-запросы заметно для пользователя откатываются на Sonnet 5. System card предупреждает, что отказов станет больше даже на безобидных задачах по безопасности. На Vals AI CyberBench на 21 октября 2026 года модель на 36-м месте из 47. Поиск и исправление багов в своём коде это не затрагивает, но для пентеста модель неудобна.
- Факты без поиска. По SimpleQA Verified у Sonnet 5.5 47% против 72% у Opus 5.5, а по system card она чуть чаще Sonnet 5 даёт неверный ответ вместо «не знаю». Для справочных вопросов включайте веб-поиск или проверяйте ответ.
- Многословность на максимуме. На max модель пишет 420 млн выходных токенов на прогон индекса AA, а время до первого токена на 21 октября 2026 года — 406 секунд. Max «по умолчанию» превращается в кратно больший счёт и долгое ожидание.
- Формат ответа. В нашем прогоне на medium и high модель нарушила заданный лимит длины на одно предложение. Если нужен строгий формат — проверяйте вывод.
- Ломающие изменения API. Код под Sonnet 5 может упасть на пяти изменениях из списка выше.
- Вендорские цифры не равны независимым. Terminal-Bench у Vals AI — 64,14% вместо заявленных 70,6%. Ориентируйтесь на независимые замеры и на свой тест.
- Данные и аккаунты. По анонсу Anthropic, Sonnet 5.5, как Opus 5.5 и Sonnet 5, доступна в режиме нулевого хранения данных (zero data retention). Рассуждения модели теперь привязаны к аккаунту, в котором созданы: если вы переносите диалоги между аккаунтами или меняете аккаунт посреди сессии Claude Code, сверьтесь с документацией Anthropic.
- Доступ. Claude работает в Украине, кроме Крыма и Донецкой, Херсонской, Луганской и Запорожской областей: в списке Anthropic эти области исключены целиком, без деления на оккупированные и подконтрольные части.
- Что устареет первым. Места в рейтингах и цены конкурентов: новые модели выходят каждые несколько недель. Свежие цифры — на странице тарифов Anthropic и в карточках моделей Artificial Analysis и Vals AI.
Вопросы и ответы о Claude Sonnet 5.5
Чем Claude Sonnet 5.5 отличается от Sonnet 5?
При той же цене $2/$10 Sonnet 5.5 вдвое дешевле на чтении кэша ($0,10 против $0,20), на 66% быстрее по замеру Artificial Analysis и заметно сильнее: индекс AA 56 против 38, Terminal-Bench 4.0 по данным Anthropic — 70,6% против 10,3%. Мышление в ней нельзя выключить совсем, а для кода под Sonnet 5 есть пять ломающих изменений API.
Сколько стоит Claude Sonnet 5.5 и можно ли пользоваться бесплатно?
В API — $2 за миллион входных токенов, $10 за выходные и $0,10 за чтение кэша, через Batch API вдвое дешевле. Подписка Pro стоит $17 в месяц при оплате за год или $20 помесячно, Max — от $100. По данным PCWorld, Sonnet 5.5 — модель по умолчанию и на бесплатном тарифе, но Anthropic этого на странице тарифов прямо не пишет.
Что лучше для программирования: Claude Sonnet 5.5 или GPT-6.1 Sol?
По качеству впереди Sonnet 5.5: на 21 октября 2026 года Terminal-Bench 4.0 у Vals AI — 64,14% против 55,05%, индекс Artificial Analysis — 56 против 52. Sonnet 5.5 и в 2,5 раза быстрее. GPT-6.1 Sol выигрывает ценой задачи: она пишет намного меньше токенов, поэтому для массовых недорогих агентных прогонов выгоднее она.
Правда ли, что Sonnet 5.5 на 30% дешевле Sonnet 5?
Не на всех уровнях усилия. Anthropic пишет «до 30% дешевле за задачу», CodeRabbit на ревью кода насчитала даже −60%. Но на уровне max задача индекса Artificial Analysis стоит $5,46 против $5,09 у Sonnet 5 — дороже на 7%. В пересчёте на балл индекса Sonnet 5.5 всё равно выгоднее на 27%.
Можно ли полностью выключить размышления в Sonnet 5.5?
Нет. Запрос с выключенным мышлением возвращает ошибку. Минимальная настройка — between_tools (на уровне усилия high и ниже): модель не рассуждает перед ответом, но думает между вызовами инструментов. Рассуждения оплачиваются как выходные токены, поэтому объём регулируйте уровнем усилия: для рутины — medium, xhigh и max — только там, где они доказанно дают прирост.
Работает ли Claude Sonnet 5.5 в Украине?
Да. По официальному списку Anthropic, Claude и API доступны в Украине, кроме Крыма, Донецкой, Херсонской, Луганской и Запорожской областей. Модель можно использовать в приложениях Claude по подписке или через API с оплатой за токены. Для работы с кодом есть Claude Code, где Sonnet 5.5 по умолчанию работает на уровне усилия medium.