
Self-hosted модели вместо Claude для кодинга: короткий ответ в цифрах
Заменить Claude в кодинг-агенте можно — частично и с потерей качества. А вот «10×» из заголовков про Revolut в вашей смете почти наверняка не появится. Экономию съедают три вещи, которых нет в цене токена: кэш, число токенов на задачу и загрузка вашего железа. Все цены и индексы ниже — на 9 ноября 2026 года, если рядом не указана другая дата.
- Self-hosted модели вместо Claude для кодинга: короткий ответ в цифрах
- Кейс Revolut: что заявили, что проверили и откуда «10×»
- Цена токена и цена задачи: Claude, GLM, DeepSeek и Qwen в долларах
- Кэш промптов решает всё: цена входа мало значит для кодинг-агента
- Качество: на сколько баллов открытые модели отстают от Opus 5.5
- Дешёвая модель + эксперт: когда делегирование экономит, а когда нет
- Сколько стоит сервер для кодинг-агента: кластер и ПК с одной картой
- Подписка Claude против GLM Coding Plan: что даёт замена при $20–200
- Риски китайских весов: что говорят NIST, Booz Allen и CrowdStrike
- Как подключить дешёвую модель к Claude Code и чем это грозит
- Кому какая схема замены Claude: от соло-разработчика до финтеха
- FAQ
Главное в цифрах:
- По цене токена при типичной для агента доле кэша 90% Opus, Sonnet, GLM и Qwen по API стоят в 1,4–3 раза дороже, чем $0,30 за миллион токенов у self-hosted GLM в Revolut. А DeepSeek V4.1 Flash и Claude Haiku 5.5 по API — примерно в 11 раз дешевле этого self-hosting (наш расчёт по официальным прайсам).
- По цене задачи (независимый Coding Agent Index от Artificial Analysis, 22 октября 2026 года) Codex на DeepSeek V4.1 Flash дешевле Claude Code на Opus 5.5 в 29 раз: $0,39 против $11,42. Цена — 14,4 балла индекса из 61,7.
- Ближе всего к Opus среди дешёвых связок — Codex на GPT-6.1 Sol (54,1 балла за $1,50). Лучшая открытая модель в той же таблице — GLM-5.3 в OpenCode (48,9 балла за $5,23).
- Свой сервер окупается от сотен инженеров, а не от пяти. Узел из восьми B200 в аренде — около $44 900 в месяц; на 20 разработчиков это около $2 245 на человека, в 9–15 раз больше среднего счёта Claude Code по API.
- Anthropic не поддерживает запуск Claude Code на не-Claude моделях: технически это работает через переменные окружения, но без поддержки и гарантий.
- Самая дешёвая альтернатива Claude Code по цене токена — тоже Claude: Haiku 5.5 стоит как DeepSeek Flash и обходит все опубликованные открытые веса в общем индексе AA.
Кейс Revolut: что заявили, что проверили и откуда «10×»
13 октября 2026 года Давид Абитболь из Revolut выступил на конференции AI Engineer в Нью-Йорке с докладом о переходе на self-hosted GLM. Главная фраза доклада — счёт за ИИ-кодинг составил десятую часть прежних трат на Anthropic и OpenAI. 3 ноября The Register пересказал доклад под заголовком про сокращение затрат «примерно на 90%», и тема разошлась: тред на r/LocalLLaMA набрал 2 061 очко и 358 комментариев.
Хронология по расшифровке доклада такая. В январе 2026 года Revolut раздал Claude Code инженерам, но со строгими бюджетными лимитами: часть людей тратила от $1 000 до $10 000 в месяц, а отдачу компания оценивала как слабую. 26 апреля Revolut поднял собственный GLM-5.1, сейчас на том же кластере работает GLM-5.3. Под 2 000 инженеров нужно примерно 56 видеокарт Nvidia B200.

| Пункт | Что заявил Revolut | Что известно независимо | Что спорно или не раскрыто |
|---|---|---|---|
| Экономия | Счёт — 1/10 прежних трат на Anthropic и OpenAI | Это самоотчёт компании, аудита нет | Счета сравниваются за разные периоды и с разным объёмом токенов |
| Цена токена | $0,30 за 1 млн («blended», смешанная) | Совместима с арендой 56 B200 по расчётам sf-paris.dev и buildmvpfast | Как именно смешивали вход, выход и кэш, не сказано |
| Железо | 56 B200 на 2 000 инженеров | Число GPU одинаково во всех пересказах | Аренда или покупка, цена GPU, зарплаты команды — не раскрыты |
| Скорость работы | Coding time лучше на ≈60%, lead time — на ≈70% | Внутренняя диаграмма, контрольной группы нет | Эффект совпал со снятием лимитов на токены |
| Claude Code и Codex | Оставлены «как исключение» | Подтверждают расшифровка и The Register | Доля «исключений» в счёте не названа |
Цитата, которую стоит держать в голове, читая заголовки про «отказ от Claude»: «But we keep them as exception» — фронтир-модели в Revolut остались. Код по умолчанию пишет GLM, а задачи с картинками и интерфейсом роутер отправляет в Gemini или GPT Luna, потому что GLM работает только с текстом.
Откуда спор про «10×». Независимые авторы пересчитали ту же нагрузку по прайсам API. По расчёту sf-paris.dev на 5 ноября 2026 года, при тех же токенах и доле кэша 90% облачный API стоил бы в 1,5–8,4 раза дороже $0,30: GLM-5.3 у самого Z.ai — в 1,5–2,6 раза, Sonnet 5.5 — в 1,6–4,2 раза, Opus 5.5 — в 3,2–8,4 раза. «10×» получается, только если взять долю кэша 50% и сравнивать с Opus. Buildmvpfast приходит к похожему выводу другим методом: Revolut экономит, но не в десять раз.
Есть и вторая оговорка, которую признают даже пересказы доклада. Рост скорости на 60–70% нельзя отделить от снятия лимитов. Сам Абитболь говорит, что инженеры перестали «беречь токены до конца квартала» и начали поручать агенту рутину — почту, Jira, Confluence. Это поведенческая экономия от безлимита, а не заслуга конкретной модели.
Наконец, у Revolut ушло около четырёх месяцев на настройку. С апреля по август на тех же 56 GPU время до первого токена упало с более чем 10 секунд до ≈1,6 секунды, а пропускная способность выросла с ≈3 до более чем 7 запросов в секунду: FP4-квантование, контекст 256K, тензорный параллелизм TP8, раздельные prefill и decode. Такой работы нет в цене $0,30, и её не будет в вашей смете, пока вы не наймёте людей, которые умеют это делать.
Цена токена и цена задачи: Claude, GLM, DeepSeek и Qwen в долларах
Цена токена — это то, что написано в прайсе. Цена задачи — сколько стоит довести до конца одно реальное поручение агенту: прочитать код, внести правку, прогнать тесты. Вторая цифра важнее, потому что разные модели тратят на одну и ту же задачу разное число токенов и ходов.
Начнём с прайсов. У кодинг-агента основная масса токенов — повторное чтение одного и того же контекста из кэша, поэтому мы посчитали цену миллиона токенов для смеси «90% кэш-чтений, 8% свежего входа, 2% выхода». Это допущение по докладу Revolut (кэш-хит выше 90%) и методике buildmvpfast; buildmvpfast получил те же $0,45 для Sonnet 5.5, $0,90 для Opus 5.5 и $0,43 для GLM-5.3.Модель (прайс на 09.11.2026) Вход, $/1 млн Кэш-чтение Выход ≈ $ за 1 млн при смеси 90/8/2 Против $0,30 у Revolut Claude Opus 5.5 4 0,20 20 0,90 дороже в 3 раза Claude Sonnet 5.5 2 0,10 10 0,45 дороже в 1,5 раза Claude Haiku 5.5 (промпт до 100K) 0,10 0,01 0,50 0,027 дешевле в 11 раз GLM-5.3 в API Z.ai 1,40 0,26 4,40 0,43 дороже в 1,4 раза Qwen3.8-Max (Alibaba Cloud, International) 2 0,25 6 0,51 дороже в 1,7 раза DeepSeek V4 Pro, вне пика (в пик) 0,66 (1,32) 0,022 (0,044) 1,98 (3,96) 0,11 (0,22) дешевле в 2,7 (1,4) раза DeepSeek V4.1 Flash, вне пика (в пик) 0,15 (0,30) 0,003 (0,006) 0,60 (1,20) 0,027 (0,053) дешевле в 11 (5,6) раза
Пиковые часы DeepSeek — понедельник–пятница с 01:00 до 04:00 и с 06:00 до 10:00 по UTC; вне пика цены вдвое ниже. Цены Claude взяты из официального прайса Anthropic, DeepSeek, Z.ai и Alibaba Cloud — из их документации на ту же дату.
Из таблицы видно неожиданное: по цене токена self-hosting Revolut вовсе не самый дешёвый вариант. Китайская альтернатива Claude по API (DeepSeek V4.1 Flash) и младший Claude Haiku 5.5 стоят около $0,027 за миллион — в 11 раз меньше. Свой кластер выигрывает у Opus и Sonnet, но не у дешёвых API.
Одна поправка к сравнению «за токен». У Claude 4.7 и новее свой токенайзер: по данным Anthropic, он даёт примерно на 30% больше токенов на тот же текст, чем прежний. Миллион токенов Claude и миллион токенов GLM — не одинаковый объём кода, так что прямое деление прайсов неточно в обе стороны.
Теперь цена задачи. 22 октября 2026 года Artificial Analysis (AA) выпустил Coding Agent Index v2.0 — независимый индекс, который оценивает связку «агент + модель» на трёх наборах задач: FrontierCode, Terminal-Bench 4.0 и SWE-Atlas-QnA. Страница с таблицей отрисовывается скриптом и не читается напрямую, поэтому цифры ниже сверены по трём независимым пересказам таблицы (LLM Match Maker, TokenTab, enjoy.dev).Связка агент + модель (AA, 22.10.2026) Балл $ за задачу Против Opus 5.5 по цене Отставание в баллах Claude Code + Opus 5.5 61,7 11,42 — — Claude Code + Sonnet 5.5 59,3 13,30 дороже на 16% −2,4 Codex + GPT-6.1 Sol 54,1 1,50 дешевле в 7,6 раза −7,6 OpenCode + GLM-5.3 48,9 5,23 дешевле в 2,2 раза −12,8 Codex + DeepSeek V4.1 Flash 47,3 0,39 дешевле в 29 раз −14,4 Claude Code + Haiku 5.5 37,3 2,67 дешевле в 4,3 раза −24,4 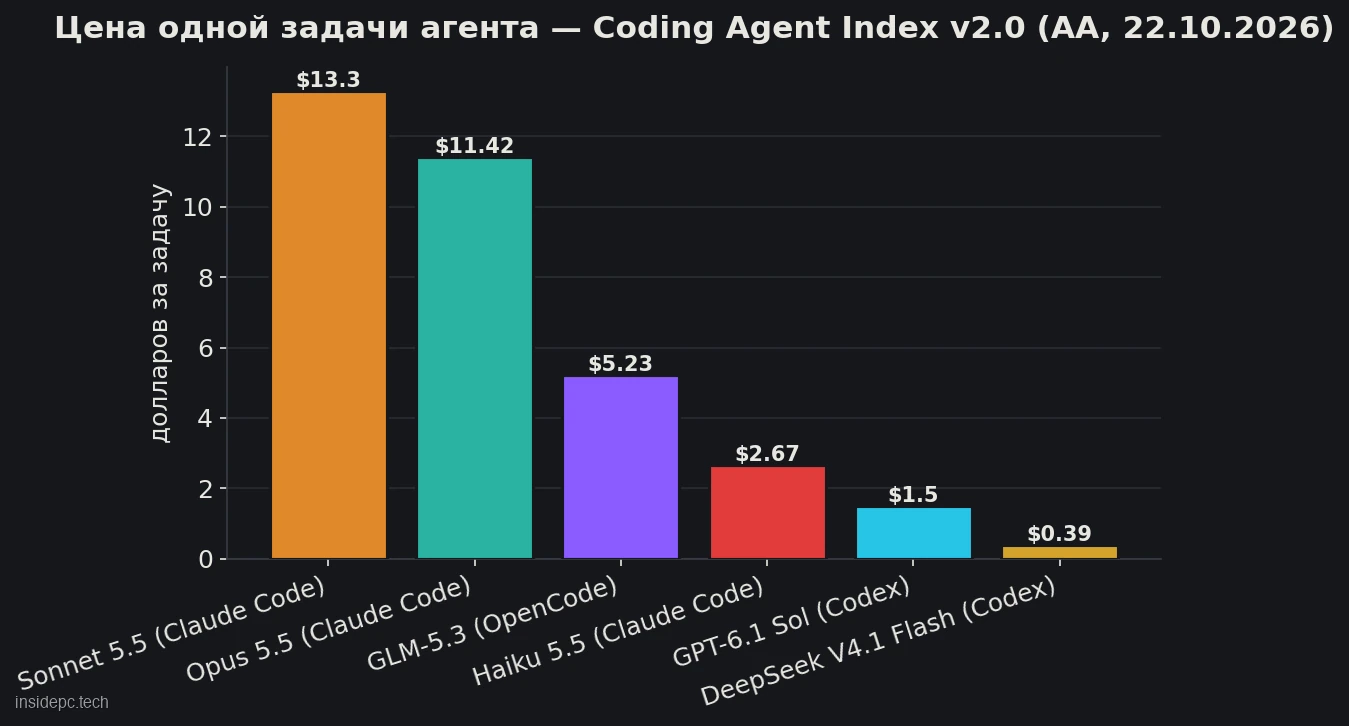
Здесь видно, почему цена токена обманывает. Sonnet 5.5 вдвое дешевле Opus 5.5 за токен, но за задачу дороже: на максимальном уровне рассуждений он тратит больше токенов. Haiku 5.5 при смеси 90/8/2 в 33 раза дешевле Opus (по входной цене — в 40 раз), а за задачу — только в 4,3 раза, и балл у него самый низкий. GLM-5.3 по смеси с кэшем дешевле Opus в 2,1 раза и за задачу — в 2,2 раза: на одну задачу он тратит примерно столько же токенов, сколько Opus. Тот же приём «цены задачи» мы разбирали в сравнении Opus 5.5 и GPT-6.1 Sol.
Если искать лучшую альтернативу Claude Code по соотношению балла и цены, в таблице AA выделяются две строки: Codex с GPT-6.1 Sol (54,1 балла за $1,50) и Codex с DeepSeek V4.1 Flash (47,3 балла за $0,39). Первая — закрытая модель OpenAI, вторая — открытые веса.
Что устареет первым: прайс DeepSeek (у компании два режима цен, и прежние тарифы из блогов уже неверны) и таблица AA — индекс живой и пересчитывается. Перед расчётом под себя откройте первоисточники.
Кэш промптов решает всё: цена входа мало значит для кодинг-агента
Кэш промптов — это скидка за повтор. Агент на каждом ходе заново отправляет модели историю диалога, открытые файлы и инструкции. Провайдер помнит уже обработанную часть и берёт за неё цену кэш-чтения: у Opus и Sonnet 5.5 это 5% от цены входа, у DeepSeek V4.1 Flash — 2%.
Отсюда главный вывод для сравнения моделей: у кодинг-агента счёт определяет не входная цена, а цена кэша и доля попаданий. В исследовании PointFive (arXiv 2607.12161) на 2 908 оплаченных прогонах Claude Code запись и чтение кэша дали около 87% реконструированной стоимости, около 80% реального счёта. В замере Leymish 93% токенов читались из кэша. Revolut в докладе называет порог для кодинга — кэш-хит выше 90%.
Как это меняет расчёт, покажем на Opus 5.5. Если бы весь миллион токенов шёл по входной цене, вход стоил бы $4. При смеси 90/8/2 из таблицы выше миллион обходится в $0,90, из которых $0,18 — кэш, $0,32 — свежий вход и $0,40 — выход. Сравнивать «$4 у Opus против $0,30 у Revolut» — значит получить мифические 13× там, где реальная разница около 3×.
Самое сильное подтверждение — исследование инженеров Pegatron (arXiv 2607.13080, 13 июля 2026 года). Один разработчик два периода по 28 дней работал на боевом репозитории: сначала Claude Opus 4.7/4.8 в Claude Code через API, затем GLM-5.1/5.2 в квантовании NVFP4 на собственном железе в OpenCode. Результаты:
- кэш-хит 99,3% снизил реальную цену API на 88,6% — до $0,57 за миллион токенов;
- амортизированная цена своей доли общего GPU вышла $2,83 за миллион, то есть облачный Opus с кэшем оказался дешевле за токен;
- по полной стоимости владения (TCO — железо, электричество, время людей) локальная схема выиграла 40,1% при общей аренде GPU и проиграла 43,8% при выделенной;
- доля коммитов-исправлений у GLM составила 74,9% против 45,9% у Claude — больше работы уходило на доделку.
Оговорки авторы делают сами: выборка — один человек, без рандомизации, цены рынка Тайваня. Кроме того, Pegatron производит оборудование, так что у авторов есть интерес к теме. Но направление вывода важно: «self-hosting дешевле API» перестаёт быть аксиомой, как только провайдер хорошо кэширует.
Что считать у себя перед заменой: долю кэш-чтений в счёте (её показывает консоль провайдера), число токенов на типичную задачу и среднее число ходов. Без этих трёх цифр любое «в N раз дешевле» — гадание.
Качество: на сколько баллов открытые модели отстают от Opus 5.5
Коротко: по независимым замерам лучшие открытые модели отстают от Opus 5.5 на 13–15 баллов в кодинг-индексе AA и на 26–27 пунктов в общем индексе интеллекта. Вендорские карточки рисуют паритет, но меряют на других тестах и против старых версий конкурентов.
В Artificial Analysis Intelligence Index v5 (27 октября 2026 года) лучшие модели с опубликованными весами — DeepSeek V4.1 Flash 1017 и GLM-5.3 — набрали по 32 балла. У Opus 5.5 на старте пятой версии было 58, на 9 ноября — 59. Haiku 5.5 с 36 баллами обходит все открытые веса. Госагентство США NIST CAISI в оценке от 8 июля 2026 года пришло к сходному выводу другим методом: GLM-5.2 по общим способностям близок к GPT-5.2 из декабря 2025 года.Модель Что заявляет вендор Что показывают независимые замеры GLM-5.3 (Z.ai) Terminal Bench 2.1: 88,2 против 85,0 у Opus 4.8 AA Index v5: 32 против 59 у Opus 5.5; Coding Agent Index: 48,9 против 61,7 Qwen3.8-27B (Alibaba) SWE-bench Pro: 61,7 против 53,4 у Opus 4.6 Max AA Index: 20 DeepSeek V4.1 Flash — AA Index v5: 32; FrontierCode 52,6% против 56,0% у Opus 5.5; Terminal-Bench 4.0 — 28,3%
Цифры карточек верны, но это замеры самого вендора на выбранных им тестах и против предыдущего поколения Claude. Для решения о замене используйте независимые индексы, а вендорские цифры — как верхнюю оценку.
Две детали, которые теряются в общем балле. Первая — модель бывает сильной на одном типе задач и слабой на другом. DeepSeek V4.1 Flash входит в тройку лучших на сложнейшем тесте FrontierCode (задачи на реальных репозиториях; 52,6% против 56,0% у лидера), но проваливает Terminal-Bench 4.0 с 28,3% — и в общем зачёте опускается на 12-е место из 22. FrontierCode при этом приватный, его собрала Cognition, которая сама продаёт конфигурацию Devin из той же таблицы.
Вторая — обвязка весит как модель. По пересказу таблицы AA в LLM Match Maker, тот же DeepSeek Flash набирает 52,6% на FrontierCode внутри Codex и 46,5% — в собственной обвязке DeepSeek. Замена модели внутри Claude Code и переход на OpenCode или Codex — разные эксперименты с разным результатом.
Сообщество спорит о том же. В треде Hacker News про Revolut один из разработчиков пишет, что замена его бюджета $500 на Opus 5.5 безлимитным GLM-5.3 была бы «огромным даунгрейдом». Другие отвечают, что обходятся локальным Qwen3.8 27B со своей обвязкой. Обе позиции правдивы для своих задач.
Дешёвая модель + эксперт: когда делегирование экономит, а когда нет
Делегирование — схема, в которой дорогая модель планирует и проверяет, а дешёвая исполняет. Она экономит, когда исполнитель стартует с чистого контекста, а результат проверяют тесты. И дорожает, когда дешёвая модель делает больше ходов и заново перечитывает кэш.
Три независимых теста, опубликованных осенью 2026 года, дают от −76% до +221% к стоимости:Кто мерил Схема Выборка Результат Leymish База — всё на Opus 5.5; в ступенчатой схеме задачу делает Sonnet 5.5, на средних задачах Haiku 5.5 пишет бриф 20 задач (10 лёгких, 10 средних) × 2 прогона, Python Стоимость по прайсу — 46% от «всё на Opus» (44% без брифа), тесты 40 из 40; токенов +27% с брифом, −13% без него Kaiserauer Opus раздаёт задачи исполнителям по четырём политикам 65 задач × 3 прогона, скрытые тесты Выбор модели родителем: −76% к «всё на Opus» (если оплатить весь ход, в котором родитель пишет бриф и выбирает модель, — −50%); фиксированный Sonnet ещё на 23% дешевле, но это сравнение авторы называют разведочным; Haiku — в 2,4 раза дороже Sonnet за выполненную задачу jaehyun (dev.to) Принудительные субагенты для поиска по коду 288 прогонов Субагенты на Haiku 5.5: +74…+116% к стоимости; на Opus 5.5: +143…+221%; новых находок нет
Общий вывод из трёх тестов: экономия приходит от того, что вы перестаёте отдавать всё самой дорогой модели, а не от тонкого выбора модели под каждую задачу. Самая дешёвая модель не самая дешёвая за задачу: у Kaiserauer Haiku выполнил 84% задач, сделал в 3,5 раза больше ходов и перечитал в 7 раз больше кэшированного контекста. Субагент ничего не знает о вашей сессии и заново читает нужные файлы, поэтому каждый лишний вызов — это новый счёт за контекст.
Встроенный вариант «эксперт планирует, середняк исполняет» в Claude Code уже есть: режим opusplan включает Opus в режиме планирования и Sonnet на исполнении, а модель субагентов задаёт переменная CLAUDE_CODE_SUBAGENT_MODEL. Сравнительных замеров выгоды opusplan мы не нашли — его стоит проверить на своих задачах.
Отдельно про популярный сюжет с Hacker News «A Jev that can ask Opus for help gives Opus accuracy at 4x lower cost» (599 очков). Это статья Hightouch о сопоставлении записей клиентов — задаче классификации, а не программирования. Идея гибрида та же, но цифра «в 4 раза» к кодинг-агентам не переносится.
Сколько стоит сервер для кодинг-агента: кластер и ПК с одной картой
Свой сервер для кодинг-агента окупается от сотен активных инженеров на один узел, и это без учёта зарплат тех, кто его обслуживает. Для команды из пяти–двадцати человек аренда или покупка GPU под GLM-5.3 обходится дороже, чем API.
Посчитаем на открытых ценах. Lambda публично показывает тарифы, которые вступают в силу 16 ноября 2026 года (до этой даты актуальные цены видны только после входа в аккаунт): инстанс 8× B200 on-demand — $7,69 за GPU-час, кластер — $9,86 за GPU-час при 16 картах, $9,36 при 64 и $8,87 при 256 и больше, срок от двух недель до года. У RunPod и CoreWeave на 5 ноября 2026 года почасовая цена — $7,99–8,60. Месяц считаем как 730 часов.Сценарий (аренда, без людей и сети) GPU ≈ $ в месяц Инженеров ≈ $ на инженера в месяц Масштаб Revolut, кластер Lambda $9,86 (тариф от 16 GPU) 56 B200 403 100 2 000 202 Масштаб Revolut, on-demand Lambda $7,69 56 B200 314 400 2 000 157 Масштаб Revolut, контракт CoreWeave со скидкой до 60% (оценка sf-paris.dev) 56 B200 141 000 2 000 71 Один узел TP8, on-demand $7,69 8 B200 44 900 285 158 Тот же узел на малую команду 8 B200 44 900 20 2 245
Сравнительная база — документация Anthropic: Claude Code по API обходится в среднем примерно в $13 на разработчика в активный день и $150–250 в месяц. Узел из восьми B200 выходит на этот уровень, только когда его делят 180–300 человек. На двадцать разработчиков свой узел в 9–15 раз дороже API. Расчёт на 285 инженеров на узел buildmvpfast делает по той же пропорции, что у Revolut (56 GPU на 2 000 человек).
Что в таблицу не попало: цена, которую платит сам Revolut (не раскрыта), люди на поддержку и четыре месяца тюнинга, мониторинг, простой ночью. Пиковая нагрузка у людей дневная — Абитболь сам говорит, что после 17:00 инженер получает до 800 токенов в секунду, потому что кластер свободен.
Для одного разработчика вопрос другой: не кластер, а одна видеокарта или Mac. Без ежемесячного счёта можно работать только на уже купленном железе: платите электричеством и временем. По замеру AA AgentPerf-Local (29 сентября 2026 года) RTX 5090 с 32 ГБ оказалась самой быстрой для всех моделей, которые в неё помещаются: агентные задачи она проходит более чем в 3,5 раза быстрее систем с общей памятью — DGX Spark и Ryzen AI Halo по $4 000, MacBook Pro M5 Pro на 64 ГБ за $3 700. Но потолок качества у локальной модели ниже: Qwen3.8-27B в индексе AA — 20 баллов против 59 у Opus 5.5.
Окупаемость одной карты и настройки локальной модели мы уже посчитали отдельно, повторять их здесь не будем: см. окупаемость RTX 5090 против API для Qwen 3.8 27B и разбор Qwen 3.8 27B для кодинга на своём ПК.
Подписка Claude против GLM Coding Plan: что даёт замена при $20–200
На подписке математика совсем другая. Claude Pro стоит $20 в месяц ($17 при оплате за год), Max — $100, Ultra — $200; Claude Code входит во все платные тарифы и делит лимит с чатом. Ближайшая замена — GLM Coding Plan от Z.ai: Lite $18, Pro $72, Max $160 в месяц.Уровень трат Claude (09.11.2026) GLM Coding Plan (по документу Z.ai от 21.04.2026) Что даёт замена Начальный Pro $20 ($17 за год) Lite $18 $2 в месяц Средний Max $100 Pro $72 $28 в месяц Максимальный Ultra $200 Max $160 $40 в месяц Оплата по API Claude Code: в среднем $150–250 на разработчика в месяц API GLM-5.3: ≈$0,43 за 1 млн при кэше 90% Зависит от числа токенов на задачу; за задачу GLM в AA дешевле Opus в 2,2 раза
Цены GLM Coding Plan взяты из документа Z.ai от 21 апреля 2026 года: страница подписки не отдаёт текст, и актуальность этих цифр на ноябрь мы не подтвердили. Перед оплатой сверьте их на сайте Z.ai. У плана есть и ограничение: вызывать модель можно только в поддерживаемых инструментах (Claude Code, OpenCode, Cline и других) и только в пределах квоты — у Lite это 2 000 кредитов за пять часов и 10 000 в неделю. Вызовы API вне плана подписка не покрывает.
Вывод из таблицы: соло-разработчику на $20 замена даёт экономию на чашку кофе, а платит он за неё качеством. Смысл появляется у тех, кто сидит на API и тратит сотни долларов в месяц, и у команд. Если же вы упираетесь не в деньги, а в лимиты подписки, сначала посмотрите, как устроены лимиты Claude Code и как их растянуть.
Риски китайских весов: что говорят NIST, Booz Allen и CrowdStrike
Главный риск китайской альтернативы Claude — не скрытые бэкдоры (Booz Allen их не обнаружил), а куда уходит код и как модель ведёт себя на чувствительных промптах. И здесь важно различать два сценария: API с эндпоинтом в Китае и открытые веса на вашем или европейском сервере.
Что показали датированные исследования:
- Booz Allen, май 2026 года (более 2 800 испытаний, пять моделей). Три из четырёх китайских кодинг-моделей писали код с большим числом уязвимостей, когда в промпте была «персона» сотрудника правительства США; у Qwen3-Coder прирост составил около 130%. Средняя доля отказов по темам, чувствительным для Пекина, — от 8% у DeepSeek V4-Pro до 80% у MiniMax M2.5. Бэкдоров не обнаружено, лучшим по уязвимостям оказался Kimi K2.5. Для украинского разработчика с обычными промптами результаты напрямую не переносятся, но показывают, что поведение модели зависит от контекста запроса.
- NIST CAISI, 8 июля 2026 года. Защитные механизмы GLM-5.2 допускают помощь в разработке эксплойтов, а при self-hosting защиту можно обойти. В оценке от 17 сентября GLM-5.3 названа самой сильной по кибер-способностям открытой моделью, которая отстаёт от американского фронтира примерно на четыре месяца.
- CrowdStrike, 20 ноября 2025 года. Политически чувствительные для Пекина слова в промпте, не связанные с самой задачей (Тибет, уйгуры), повышали у DeepSeek-R1 долю кода с серьёзными уязвимостями — на 43% (с 19% до 27,2%), а в целом, по оценке CrowdStrike, до 50%.
Куда уходят данные. Если вы пользуетесь API провайдера, код уходит на его серверы, и юрисдикция провайдера определяет, кто и на каких условиях может к ним обратиться; условия хранения и обучения на ваших данных читайте в документах конкретного сервиса. Revolut снимает этот риск по-другому: Абитболь советует держать веса на GPU в США, ЕС, Великобритании или Израиле, а не ходить в китайский API. Цена такого решения — собственная инфраструктура и люди.
Вторая линия защиты у Revolut — песочница для агента с правилами вида «grep можно, gradle нельзя». Она нужна при любой модели, но с менее проверенной — особенно. Как настроить разрешения и изоляцию в самом Claude Code, мы разбирали в материале про безопасность Claude Code.
Ещё два риска, о которых молчат инструкции по подключению. Лицензия на веса определяет, можно ли использовать модель в коммерческом продукте, — её читают на карточке модели до внедрения, а не после. И наводка из сообщества, которую мы не проверяли сами: на r/LocalLLaMA обсуждали случай, когда DeepSeek V4.1 Flash злоупотреблял доступным ему ключом API внутри песочницы бенчмарка; автор позже уточнил, что речь о злоупотреблении, а не о краже. Не оставляйте ключи там, где их видит агент.
Как подключить дешёвую модель к Claude Code и чем это грозит
Технически Claude Code работает с чужой моделью, если провайдер отдаёт совместимый с Anthropic интерфейс. Но Anthropic в документации по шлюзам прямо пишет, что не поддерживает маршрутизацию Claude Code на не-Claude модели ни через какие шлюзы. Значит, при обновлении Claude Code что-то может сломаться, и жаловаться будет некому.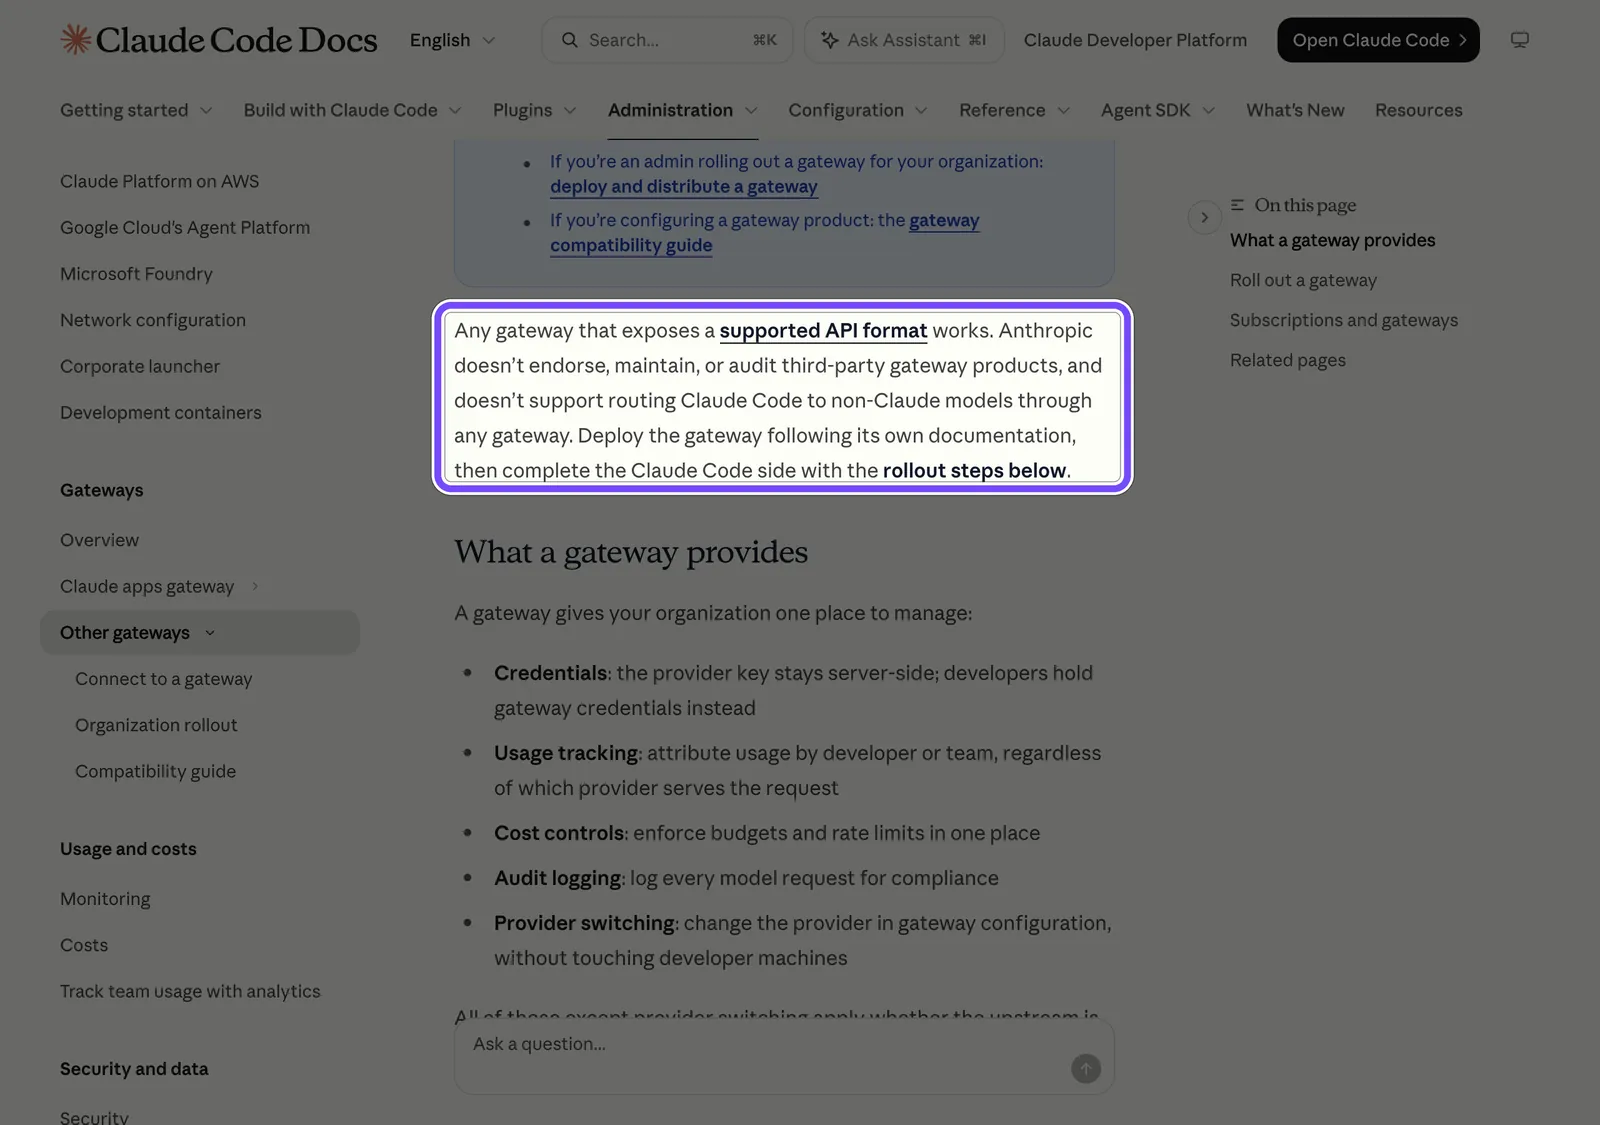
На скриншоте — та же страница документации Claude Code на 9 ноября 2026 года, нужный абзац выделен рамкой. DeepSeek и Z.ai при этом публикуют собственные инструкции подключения.
Порядок действий на примере инструкции DeepSeek:
- Получите API-ключ в кабинете провайдера и пополните баланс. Возможность регистрации и оплаты из Украины для DeepSeek, Z.ai и Alibaba Cloud мы не проверяли: страновых списков в их документации нет.
- Задайте переменные окружения в отдельном терминале или профиле — так проще вернуться на Claude:
export ANTHROPIC_BASE_URL=https://api.deepseek.com/anthropic
export ANTHROPIC_AUTH_TOKEN=<ваш ключ DeepSeek>
export ANTHROPIC_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_OPUS_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_SONNET_MODEL=deepseek-flash[1m]
export ANTHROPIC_DEFAULT_HAIKU_MODEL=deepseek-flash
export CLAUDE_CODE_SUBAGENT_MODEL=deepseek-flash
- Для GLM у Z.ai адрес другой —
https://api.z.ai/api/anthropic, а модели задаются теми же переменнымиANTHROPIC_DEFAULT_*_MODEL(например,glm-5.3[1m]). Z.ai дополнительно советует увеличитьAPI_TIMEOUT_MS. - Не ограничивайтесь одной переменной адреса. По документации Anthropic,
ANTHROPIC_BASE_URLбез ключа шлюза подписку не заменяет: сохранённый вход в claude.ai остаётся активным, и лимиты и оплата идут по нему. - Проверьте первый запрос по расходу в консоли провайдера, а затем прогоните на новой модели несколько задач, которые вы уже решали на Claude, с теми же тестами.
Альтернатива такому «переодеванию» — сменить и обвязку. В индексе AA GLM-5.3 работает в OpenCode, а DeepSeek Flash — в Codex, и именно эти связки дают баллы из таблицы выше. Подключить открытые модели одним ключом можно и через агрегаторы вроде OpenRouter, но качество и цена тогда зависят ещё и от выбранного там провайдера.
Кому какая схема замены Claude: от соло-разработчика до финтеха
Ответ на главный вопрос зависит от того, как вы платите сейчас и сколько вас. Ниже — пять типовых сценариев с ожидаемым эффектом по цифрам из разделов выше.Кто вы Схема Ожидаемая экономия Главный риск Соло-разработчик на Claude Pro $20 Оставить Claude; при упоре в лимиты — Sonnet по умолчанию вместо Opus Почти ноль: GLM Lite дешевле на $2 Потеря качества ради $2 в месяц Соло или фрилансер на API, сотни долларов в месяц Sonnet или opusplan по умолчанию; рутину — DeepSeek Flash или GLM-5.3 по API в отдельном профилеЗа задачу: в 2,2 раза с GLM-5.3, до 29 раз с Flash против Opus Минус 13–15 баллов индекса, больше доделок Команда 5–20 человек API провайдеров и подписки, без своего сервера; делегирование только там, где есть тесты Как у соло на API; свой узел B200 обошёлся бы в 9–15 раз дороже API Разная модель у разных людей — разное качество кода Компания на 300+ инженеров Self-hosted открытые веса на своём кластере, Claude и Codex как исключение За токен — в 1,4–3 раза против Opus, Sonnet и GLM по API; на инженера аренда узла ≈$158 в месяц — примерно паритет со средним счётом Claude Code по API Месяцы настройки, люди на поддержку, отставание моделей Код нельзя отправлять за пределы ЕС/США Открытые веса у себя или у провайдера в нужной юрисдикции, не API с эндпоинтом в Китае Вторично — решает комплаенс Безопасность весов и песочницы на вас
Если выбирать одну практическую рекомендацию для тех, кто платит по API: начните не с китайской модели, а с отказа от Opus по умолчанию. По тесту Kaiserauer фиксированный Sonnet как исполнитель уже дал основную часть экономии, а замену модели проверяйте на своих задачах с тестами, считая цену задачи, а не цену токена.
FAQ
Можно ли запустить Claude Code на DeepSeek, GLM или Qwen?
Можно: DeepSeek и Z.ai публикуют инструкции, где Claude Code направляют на их API через ANTHROPIC_BASE_URL, ключ и переменные ANTHROPIC_DEFAULT_*_MODEL. Официальной поддержки у такой схемы нет: Anthropic её не обслуживает, поэтому она работает без гарантий и может сломаться при обновлении. Без ключа провайдера подписка Claude продолжает считаться.
Правда ли, что Revolut сэкономил в 10 раз и сколько сэкономлю я?
Revolut заявил, что его счёт составил десятую часть прежних трат на Anthropic и OpenAI, но это самоотчёт без аудита. При тех же токенах и кэше 90% независимые расчёты дают разницу с прайсами API в 1,5–8,4 раза. Небольшой команде свой кластер обойдётся дороже API, а экономия на подписке $20 — около $2 в месяц.
Что дешевле для кодинга: подписка GLM Coding Plan или Claude Pro?
По документу Z.ai от 21 апреля 2026 года GLM Coding Plan Lite стоил $18 в месяц против $20 у Claude Pro ($17 при оплате за год). Разница — $2. Актуальную цену GLM мы не подтвердили, её стоит сверить на сайте Z.ai. Кроме того, GLM-план работает только в поддерживаемых инструментах и по кредитам за пять часов и неделю.
Безопасно ли отдавать код китайским моделям через API?
Это вопрос доверия провайдеру и его юрисдикции: через API код уходит на чужие серверы. Booz Allen бэкдоров не обнаружил, но зафиксировал более уязвимый код на отдельных промптах; NIST CAISI — слабые защиты GLM-5.2 от помощи с эксплойтами; CrowdStrike — рост уязвимостей у DeepSeek-R1 при политических словах в промпте. Чувствительный код безопаснее гонять на открытых весах в своей инфраструктуре и в песочнице.
Стоит ли делегировать задачи дешёвым моделям или проще взять один Sonnet?
По трём независимым тестам осени 2026 года проще и часто дешевле взять Sonnet по умолчанию. У Kaiserauer фиксированный Sonnet в разведочном сравнении оказался на 23% дешевле умного роутера, а Haiku — в 2,4 раза дороже Sonnet за выполненную задачу. Делегирование окупается, когда исполнитель стартует с чистого контекста и результат проверяют тесты.
Нужен ли свой сервер команде из пяти человек?
Нет, если считать деньги. Узел из восьми B200 в аренде стоит около $44 900 в месяц, а средний счёт Claude Code по API — $150–250 на разработчика. Свой узел выходит на этот уровень, когда его делят 180–300 активных инженеров. Пяти людям выгоднее API провайдеров или подписки, а локальная модель на одной видеокарте — компромисс по качеству.