Коротко (TL;DR)
Це огляд GLM-5.3 — відкритої моделі китайської компанії Z.ai (колишня Zhipu AI). Головне, що варто знати до купівлі заліза: під одним номером вийшли дві різні моделі, і вдома запускається лише молодша.
- Коротко (TL;DR)
- GLM-5.3 і GLM-5.3-Flash: дві різні моделі під одним номером
- Звідки цифри в огляді GLM-5.3: чужі заміри й наші оцінки
- Розміри й ліцензія GLM-5.3 і Flash: що можна завантажити й продати
- Бенчмарки GLM-5.3: що підтвердили незалежні заміри
- GLM-5.3 проти Kimi K3 і DeepSeek V4: порівняння відкритих моделей
- Чим GLM-5.3 відрізняється від GLM-5.2: ефект одного пост-навчання
- Скільки пам’яті потрібно GLM-5.3 і Flash: кванти від 1 до 8 біт
- Швидкість GLM-5.3-Flash на Mac і RTX: заміри й розрахункові оцінки
- Як запустити GLM-5.3-Flash локально: llama.cpp, MLX і пастка Ollama
- Сильні й слабкі сторони двох моделей Z.ai в одній таблиці
- Ризики GLM-5.3: кіберможливості, слабкий захист і юрисдикція
- Що обрати під завдання: хмарний API, Flash на Mac чи флагман
- FAQ
- GLM-5.3 — флагман на 753 млрд параметрів. Ваги відкриті з 28 серпня 2026 року, але навіть найстисліший файл важить 217 ГБ: це Mac Studio на 256–512 ГБ або сервер, а не домашній ПК.
- GLM-5.3 Flash — окрема модель на 320 млрд параметрів під ліцензією MIT. Вона вміщується в один Mac зі 128 ГБ пам’яті (2–3 біти, після підняття ліміту відеоядра) або 256 ГБ (4 біти).
- Швидкість Flash удома за заміром MacStories — 41 токен за секунду на Mac Studio M5 Ultra і 26 на M3 Ultra. Для решти машин даємо розрахункову оцінку й позначаємо її.
- Незалежний індекс Artificial Analysis станом на 25.10.2026 ставить GLM-5.3 до трійки найкращих відкритих моделей: 45 балів. Вище лише MiMo-V2.6-Pro від Xiaomi (46), стільки ж у DeepSeek V4.1 Flash 1017 (45), у Kimi K3 — 44.
- API дешевший за залізо для більшості: Flash коштує $0,15 за мільйон вхідних токенів і $0,50 за мільйон вихідних (прайс Z.ai станом на 25.10.2026).
- Головний ризик — сильні кібернавички за слабкого вбудованого захисту. Кібернавички зафіксував NIST, легкий обхід захисту показала Anthropic, прямий конкурент Z.ai.
- Дані перевірено станом на 25.10.2026. Власного прогону моделі в нас немає, тому бал не ставимо: усі цифри — документи Z.ai, незалежні заміри й наші розрахунки з відкритою формулою.
GLM-5.3 і GLM-5.3-Flash: дві різні моделі під одним номером
Більшість сторінок у видачі змішують дві моделі в одну. Через це в одному місці пишуть, що GLM-5.3 «потребує серверної стійки», а в іншому — що «працює на Mac». Обидва твердження правильні, просто про різні моделі.
Спершу словничок. Без нього далі буде складно:
- Параметри — числа всередині нейромережі, у яких записано її знання. Що їх більше, то модель зазвичай розумніша і то більше пам’яті їй потрібно.
- MoE (Mixture of Experts, суміш експертів) — будова, за якої модель розбито на безліч «експертів», а на кожне слово працюють лише кілька з них. Тому в MoE-моделі два числа: усього параметрів і активних на один токен.
- Токен — шматочок слова, яким модель читає і пише. Швидкість вимірюють у токенах за секунду (ток/с).
- Квантування — стиснення ваг: замість 16 біт на число зберігають 2–4 біти. Файл стає в рази меншим, точність трохи падає.
- Контекст — скільки тексту модель тримає в голові за раз: запит, документи, історія діалогу.
- VRAM — пам’ять відеокарти. Єдина пам’ять (unified memory) у Mac — спільна для процесора й відеоядра, тому Mac зі 128 ГБ може віддати моделі більшу частину: за замовчуванням близько 75%, більше — після налаштування (див. нижче).
Тепер самі моделі:




- GLM-5.3 (флагман). Вийшла 14 серпня 2026 року спершу лише в API, ваги Z.ai виклала через два тижні — 28 серпня. Усього 753 млрд параметрів, активних 40 млрд. Картка моделі — GLM-5.3 на Hugging Face.
- GLM-5.3-Flash. Не урізана копія флагмана, а нова модель, навчена з нуля на власній базі (30 трлн токенів даних). Вийшла 26 серпня 2026 року одразу з відкритими вагами. Усього 320 млрд параметрів, активних 18 млрд, розуміє текст і зображення.
Для домашнього користувача GLM 5.3 Flash — самостійна модель сімейства GLM-5.3 і єдина з двох, яку реально запустити в себе. До розкриття вона кілька тижнів серпня брала участь у сліпих порівняннях під кодовим ім’ям Ox Alpha й обганяла моделі з відомими назвами (Gigazine, LLMCheck).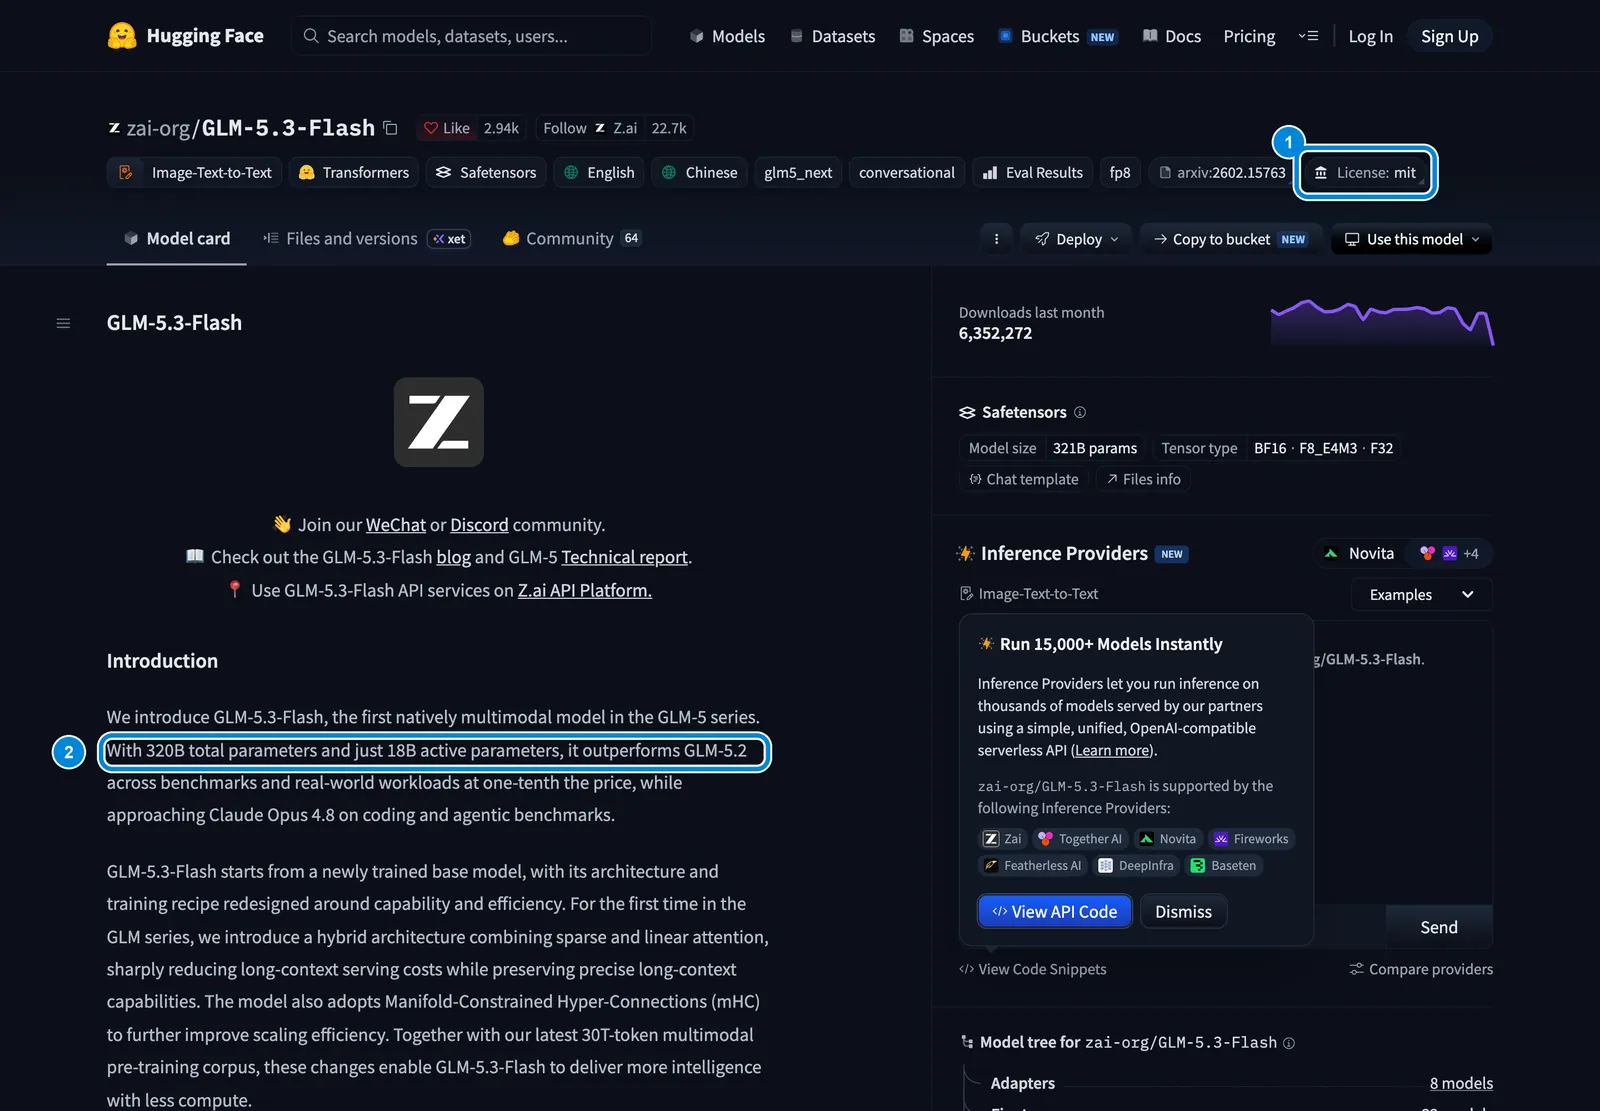
На знімку картки GLM-5.3-Flash від 25.10.2026 рамка 1 показує ліцензію MIT, рамка 2 — рядок «320B total parameters and just 18B active parameters». Лічильник праворуч — 6 352 272 завантаження за останній місяць: молодшу модель завантажують утричі частіше за флагман (2 074 062 за той самий період).
Звідки цифри в огляді GLM-5.3: чужі заміри й наші оцінки
Власного прогону GLM-5.3 на нашому залізі в цьому огляді немає. Нижче три типи даних, і біля кожної цифри сказано, до якого вона належить:
- Заяви Z.ai — таблиця бенчмарків із картки моделі. Це слова виробника, і ми так їх і підписуємо.
- Незалежні заміри — індекс Artificial Analysis, оцінка кіберможливостей NIST, заміри швидкості MacStories і спільноти llama.cpp. Біля кожного вказано умови тесту.
- Наші оцінки за відкритою формулою — там, де заміру немає (M5 Max, M4 Max, DGX Spark, RTX). Формулу й коефіцієнт показуємо, щоб кожен міг перерахувати під свою машину.
У серпні ми писали, чому Z.ai притримала ваги GLM-5.3 — тоді модель була доступна лише через API. Тепер ситуація інша: репозиторій на Hugging Face відкритий без заявок, і все нижче стосується вже опублікованих ваг.
Розміри й ліцензія GLM-5.3 і Flash: що можна завантажити й продати
Скільки параметрів у GLM-5.3: флагман має 753 млрд усього і 40 млрд активних на токен, Flash — 320 млрд і 18 млрд. Unsloth і частина сайтів пишуть «744B», Artificial Analysis і сума тензорів чекпойнта на Hugging Face дають 753 млрд; далі спираємося на чекпойнт. Будова флагмана — 78 шарів і 256 експертів, із яких на кожен токен працюють 8.Параметр GLM-5.3 GLM-5.3-Flash GLM-5.2 (для порівняння) Параметрів усього / активних 753B / 40B 320B / 18B 753B / 40B База та сама, що в GLM-5.2 нова, навчена з нуля — Вхід текст текст і зображення текст Контекст 1 048 576 токенів ≈1 млн (за Artificial Analysis) н/д Вихід ваг 28.08.2026 (API — з 14.08) 26.08.2026 раніше Ліцензія власна ліцензія GLM-5.3 MIT MIT Оригінальний чекпойнт FP8 ≈ 755 ГБ, BF16 ≈ 1,5 ТБ BF16 ≈ 642 ГБ н/д Мінімальний квант 217 ГБ (1 біт) 93 ГБ (1 біт) н/д
Ліцензія флагмана — головна відмінність від GLM-5.2. GLM-5.2 мала MIT, GLM-5.3 — власну ліцензію. Користуватися, донавчати й продавати продукти на ній можна вільно. Умова одна: якщо компанія продає доступ до моделі як сервіс (MaaS, model as a service) і разом з афілійованими особами заробляє понад $10 млрд за будь-які 12 місяців поспіль, перед комерційним використанням вона має пройти перевірку безпеки Z.ai.
Звичайного користувача, стартапу чи студії це не стосується: під умову потрапляють хмарні гіганти масштабу найбільших провайдерів. У GLM-5.3-Flash такого пункту немає взагалі — MIT дозволяє комерцію, зміни й поширення із зазначенням авторства.
Бенчмарки GLM-5.3: що підтвердили незалежні заміри
Бенчмарк (англ. benchmark) — стандартний набір завдань, на якому порівнюють моделі. Цифри GLM-5.3 треба читати з трьох джерел, і вони кажуть різне.
Що заявляє Z.ai. Таблиця з картки моделі — це заміри самого виробника:Тест (дані Z.ai) GLM-5.3 GLM-5.2 Kimi K3 Opus 4.8 GPT-5.6 Sol Terminal Bench 3.0 28,3 4,6 17,4 21,1 34,6 DeepSWE v1.1 66,9 46,2 67,5 58,0 72,7 CyberGym 84,5 77,2 80,0 78,1 83,6 HLE з інструментами 62,5 54,7 59,8 57,9 64,5
Навіть за власними даними Z.ai GLM-5.3 не лідер у програмуванні: у Terminal Bench 3.0 і DeepSWE попереду GPT-5.6 Sol і Fable 5 (33,7 і 69,7; цієї колонки в нашій вибірці немає), а в DeepSWE ще й Kimi K3. Із 16 тестів своєї таблиці Z.ai ставить GLM-5.3 першою у трьох: CyberGym (кібербезпека), AutomationBench (48,2) і GDPval-AA v2 (1769) — офісні агентні завдання.
Що виміряли незалежні. Artificial Analysis (AA) проганяє моделі на своїх десяти тестах і зводить їх в індекс. Станом на 25.10.2026 у версії індексу v4.3.2 GLM-5.3 має 45 балів, Kimi K3 — 44, GLM-5.3-Flash — 42 (порівняння на Artificial Analysis).
Висновок із графіка: за зведеним балом GLM-5.3 третя серед відкритих моделей (у DeepSeek V4.1 Flash 1017 стільки ж — 45), але в Terminal-Bench 4.0, тесті агента в терміналі, вона перша з восьми моделей графіка — 42% проти 34–35% у нових суперників і 13% у Kimi K3. Flash відстає від флагмана на три бали й водночас випереджає GLM-5.2. Бали AA знято в режимі Max — із максимальною глибиною міркувань; заміри швидкості нижче зроблено в полегшеному режимі.Модель Індекс AA v4.3.2 (25.10.2026) Terminal-Bench 4.0 за AA MiMo-V2.6-Pro 46 35% GLM-5.3 45 42% DeepSeek V4.1 Flash 1017 45 34% Kimi K3 44 13% GLM-5.3-Flash 42 33% Qwen3.8-Flash-Next 40 25% DeepSeek V4 Flash 0731 34 12% GLM-5.2 34 1%
Чому в новинах було 60 балів, а тепер 45. На релізі, 19 серпня 2026 року, AA давав GLM-5.3 60 балів — нарівні з Kimi K3 і на 7 вище за GLM-5.2 (The Decoder, Gigazine). Тодішня версія індексу — v4.1.1 (мітку версії називає сама Z.ai в матеріалах про Flash). Відтоді AA змінив набір тестів, і у версії v4.3.2 в усіх моделей інші числа. Порівнювати 60 із серпня з 45 із жовтня не можна — це різні лінійки. Пара GLM-5.3 і Kimi K3 і далі йде майже нарівні (45 і 44), але відтоді вийшли дві відкриті моделі з не меншим балом: MiMo-V2.6-Pro (46) і DeepSeek V4.1 Flash 1017 (45).
Що сказав NIST. Центр стандартів ШІ при NIST (CAISI) 17 вересня 2026 року назвав GLM-5.3 найсильнішою в кібербезпеці відкритою моделлю на той момент. За їхнім зведенням тестів вона відстає від найкращих американських моделей приблизно на чотири місяці. Це державна оцінка на чотирьох власних тестах CAISI з пошуку вразливостей і написання експлойтів (SEC-Bench Pro, ExploitBench, ExploitGym, CAISI OSS-Fuzz). CyberGym серед них немає, але загальний висновок той самий, що в Z.ai: модель сильна саме в кібербезпеці.
GLM-5.3 проти Kimi K3 і DeepSeek V4: порівняння відкритих моделей
Порівняння GLM 5.3 vs Kimi K3 — пара, яку найчастіше ставлять поруч: на релізі AA дав обом однакові 60 балів. Нижче до них додано дві нові відкриті моделі з тим самим або більшим балом — MiMo-V2.6-Pro від Xiaomi (вересень 2026) і DeepSeek V4.1 Flash 1017 (жовтень 2026), а також «молодші» моделі, які реально запустити вдома: DeepSeek V4 Flash і Qwen3.8-Flash-Next. Докладні розбори — у наших оглядах Kimi K3 і DeepSeek V4 Flash.Модель Усього / активних Ліцензія Індекс AA API: вхід / вихід за 1M токенів Швидкість API Удома MiMo-V2.6-Pro 1,0T / 42B MIT 46 $0,435 / $0,87 57 ток/с н/д GLM-5.3 753B / 40B власна (MaaS > $10 млрд) 45 $1,40 / $4,40 95 ток/с Mac Studio 256–512 ГБ DeepSeek V4.1 Flash 1017 552B / 16B MIT 45 $0,30 / $1,20 169 ток/с н/д Kimi K3 2,8T / 104B власна 44 $3,00 / $15,00 47 ток/с ні GLM-5.3-Flash 320B / 18B MIT 42 $0,15 / $0,50 70 ток/с Mac 128–256 ГБ Qwen3.8-Flash-Next 180B / 6B Qwen Community 40 $0,15 / $0,47 52 ток/с н/д (MacStories ганяв на M5 Ultra 256 ГБ) DeepSeek V4 Flash 0731 284B / 13B MIT 34 $0,14 / $0,28 150 ток/с Mac 128 ГБ у 2 бітах (замір спільноти)
Дані — Artificial Analysis і прайс Z.ai станом на 25.10.2026. Швидкість API — це швидкість у хмарі провайдера, а не на вашому комп’ютері. Удома молодші суперники швидші: Qwen3.8-Flash-Next у замірі MacStories видає 108 ток/с на M5 Ultra, DeepSeek V4 Flash за заміром спільноти — 39 ток/с на M5 Max у 2 бітах.
На сторінці Pricing у документації Z.ai GLM 5.3 коштує $1,40 за мільйон вхідних і $4,40 за мільйон вихідних токенів, Flash — $0,15 і $0,50 (станом на 25.10.2026).
Що видно на графіку цін: за тарифом Kimi K3 у 2–3,5 раза дорожча за GLM-5.3, але середнє завдання індексу AA обходиться в них майже однаково — $2,00 і $2,01. GLM-5.3 «думає» довше й витрачає більше токенів на міркування. Суперники з тим самим або більшим балом розв’язують завдання значно дешевше: DeepSeek V4.1 Flash 1017 — за $0,26 (у 8 разів дешевше), MiMo-V2.6-Pro — за $0,13. Flash за завдання — $0,28, приблизно в сім разів дешевше за флагман.Модель Ціна завдання AA (25.10.2026) GLM-5.3 $2,01 Kimi K3 $2,00 DeepSeek V4.1 Flash 1017 $0,26 MiMo-V2.6-Pro $0,13 Qwen3.8-Flash-Next $0,37 GLM-5.3-Flash $0,28 DeepSeek V4 Flash 0731 $0,15
Як читати порівняння. Kimi K3 із 2,8 трлн параметрів удома не запустити взагалі — це вибір лише для API. Головний аргумент на користь GLM-5.3 проти дешевших MiMo-V2.6-Pro і DeepSeek V4.1 Flash 1017 — агентна робота: 42% у Terminal-Bench 4.0 проти 35% і 34%. Якщо такі завдання не ваш випадок, за рівного бала дешевше взяти суперника. GLM-5.3-Flash на вісім балів випереджає DeepSeek V4 Flash за індексом і майже втричі краща в Terminal-Bench 4.0, але DeepSeek удвічі швидший у хмарі й дешевший на виході. Для агента, який годинами працює в терміналі, Flash сильніша. Для дешевого швидкого чату — DeepSeek.
Чим GLM-5.3 відрізняється від GLM-5.2: ефект одного пост-навчання
У парі GLM 5.3 vs 5.2 розмір однаковий: та сама база на 753 млрд параметрів. Z.ai прямо пише в картці, що весь приріст отримано пост-навчанням — донавчанням готової моделі на завданнях агента, коду й кібербезпеки. Про попередницю — у нашому огляді GLM-5.2.
Що змінилося:
- Агентна робота. За незалежним Terminal-Bench 4.0 від AA — 42% у GLM-5.3 проти 1% у GLM-5.2. За власним Terminal Bench 3.0 Z.ai — 28,3 проти 4,6.
- Зведений індекс AA зріс із 34 до 45 балів (версія v4.3.2, 25.10.2026).
- Кібернавички. ExploitBench у таблиці Z.ai — 54,4 проти 24,4. Anthropic окремо пише, що стрибок від GLM-5.2 до GLM-5.3 схожий на стрибок між її власними Opus 4.6 і Mythos Preview.
- Ціна API не змінилася: $1,40 і $4,40 за мільйон токенів в обох моделей. Швидкість в API теж та сама — 94–95 ток/с.
- Завдання подорожчало: $2,01 проти $1,47 у GLM-5.2, бо нова модель міркує довше.
- Ліцензія стала суворішою: на зміну MIT прийшла власна ліцензія з умовою для MaaS-гігантів.
- Вимоги до заліза не змінилися: ваги того самого розміру, той самий Mac Studio на 256–512 ГБ.
Практичний висновок: якщо ви вже тримали GLM-5.2 локально, GLM-5.3 стає на те саме залізо й у ті самі кванти.
Скільки пам’яті потрібно GLM-5.3 і Flash: кванти від 1 до 8 біт
Оригінальний флагман у форматі FP8 важить близько 755 ГБ, у BF16 — близько 1,5 ТБ. Удома використовують стиснені файли GGUF від Unsloth: флагман від 217 ГБ, Flash від 93 ГБ.
Правило підбору просте: у пам’ять має вміститися файл плюс 5–10% на контекст і систему. Unsloth дає орієнтири: флагману в 1 біті потрібно 223 ГБ сумарної пам’яті (оперативна плюс відеопам’ять, або єдина в Mac), у 2 бітах — 245 ГБ, у 4 бітах — 372–475 ГБ, у 8 бітах — 810 ГБ. Flash в 1 біті працює на 100 ГБ, у 3 бітах — на пристроях зі 128 ГБ.
Головне на графіку: увесь ряд Flash до 4 біт уміщується в 128–256 ГБ, а флагман починається там, де у Flash уже 4 біти. Колонки «точність» у таблиці нижче — частка токенів, на яких стиснена модель обирає той самий найімовірніший наступний токен, що й оригінал (метрика Unsloth top-1).Квант Flash, ГБ Flash, точність GLM-5.3, ГБ GLM-5.3, точність На чому (Flash / флагман) IQ1_S (1 біт) 93,1 70,9% 216,7 72,6% Mac 128 ГБ / Mac 256 ГБ, ліміт підняти IQ2_XXS / IQ2_M (2 біти) 101,8 76,3% 238,6 78,5% Mac 128 ГБ, ліміт підняти / Mac 256 ГБ, ліміт підняти Q2_K_XL (2 біти) 108,7 78,3% 253,9 80,9% Mac 128 ГБ, ліміт 112 ГіБ / Mac 512 ГБ IQ3_XXS (3 біти) 120,4 81,6% 281,7 84,2% Mac 128 ГБ, ліміт ≈120 ГіБ / Mac 512 ГБ Q3_K_XL (3 біти) 147,5 86,3% 343,0 88,9% Mac 192 ГБ впритул або 256 ГБ / Mac 512 ГБ IQ4_XS (4 біти) 156,8 88,2% 365,3 90,6% Mac 192 ГБ, ліміт підняти, або 256 ГБ / Mac 512 ГБ Q4_K_XL (4 біти) 199,7 92,2% 467,3 94,3% Mac 256 ГБ впритул / Mac 512 ГБ, ліміт підняти Q5_K_XL (5 біт) 240,3 94,4% 562,5 95,8% Mac 256 ГБ, ліміт підняти / сервер Q6_K_XL (6 біт) 291,8 95,2% 684,4 96,6% Mac 512 ГБ / сервер Q8_0 (8 біт) ≈341 н/д ≈801 н/д Mac 512 ГБ / сервер BF16 (оригінал) ≈642 100% ≈1508 100% сервер / сервер
Розміри — Unsloth (Q8_0 Flash — Toolhalla, Q8_0 і BF16 флагмана — ModelFit), десяткові гігабайти. Деякі сайти пишуть GiB (ГіБ, двійкові гігабайти): 112,1 ГіБ у IQ3_XXS — це ті самі 120 ГБ. Apple, навпаки, зазначає пам’ять у двійкових: «128 ГБ» у Mac — це 128 ГіБ, або 137 десяткових ГБ.
Ліміт macOS — пастка, про яку забувають. За замовчуванням macOS віддає відеоядру близько 75% єдиної пам’яті: на Mac зі 128 ГБ це приблизно 96 ГіБ, на 256 ГБ — 192 ГіБ, на 512 ГБ — 384 ГіБ. Файл Flash IQ3_XXS важить 112,1 ГіБ і в 96 ГіБ не вміщується. Ліміт піднімають командою sudo sysctl iogpu.wired_limit_mb=… (значення в мегабайтах). OrcaRouter наводить 114688 (112 ГіБ) для 2-бітної збірки близько 102 ГБ і називає 122880 (120 ГіБ) верхньою межею того, що ставлять на Mac зі 128 ГБ. Файл IQ3_XXS у 112 ГіБ уже не вміщується. Налаштування скидається після перезавантаження, а якщо залишити системі замало пам’яті, Mac почне зависати.
Звідси практичні сходинки. Mac на 96 ГБ не тримає жодного кванта Flash. Mac на 128 ГБ — 2 біти (Q2_K_XL, 101 ГіБ) за ліміту 112 ГіБ або 3 біти IQ3_XXS лише за ліміту близько 120 ГіБ: тоді macOS залишається близько 8 ГіБ, а контекст доведеться тримати коротким. Mac на 256 ГБ — повноцінні 4 біти Q4_K_XL (186 ГіБ): за штатного ліміту 192 ГіБ під контекст залишається всього кілька гігабайтів, тому ліміт теж варто підняти. Флагман починається з Mac Studio на 256 ГБ в 1–2 бітах, і тут без підняття ліміту не обійтися: навіть 1-бітний файл (217 ГБ, 202 ГіБ) більший за штатні 192 ГіБ. Точність при цьому помітно падає; Unsloth радить цілитися в Q4_K_XL і Q5_K_XL, а це вже 467–563 ГБ. Як обирати обсяг пам’яті під різні моделі, ми розбирали в статті «Єдина пам’ять Mac для ШІ».
Швидкість GLM-5.3-Flash на Mac і RTX: заміри й розрахункові оцінки
Швидкість генерації у великих моделей майже цілком задає пропускна здатність пам’яті — скільки гігабайтів за секунду чип устигає прочитати. На кожен токен модель читає свої активні ваги. У Flash у 4 бітах це близько 10 ГБ на токен проти приблизно 180 ГБ, якби ті самі 320 млрд параметрів працювали всі одразу (LLMCheck). Саме тому 320-мільярдна MoE-модель узагалі стала темою для Mac.
Заміри. MacStories ганяв GLM-5.3-Flash на двох Mac Studio: збірка MLX mixed 4/8 біт (експерти в 4 бітах, увага у 8), рушій oMLX 0.7.0.dev2, низький рівень міркувань, медіана трьох проходів, швидкість ураховує й токени міркувань. Результат — 41 ток/с на M5 Ultra 256 ГБ і 26 ток/с на M3 Ultra 512 ГБ. Окремий замір спільноти в llama.cpp на тому самому M5 Ultra — 39,7 ток/с (квант не вказано).
Формула для оцінки. Де заміру немає, обчислюємо так:
швидкість ≈ 0,36 × пропускна здатність (ГБ/с) ÷ гігабайти активних ваг на токен
Гігабайти на токен грубо дорівнюють розміру файлу × 18/320 (частка активних параметрів): у IQ3_XXS це 120,4 × 18/320 ≈ 6,8 ГБ, у Q4_K_XL — 199,7 × 18/320 ≈ 11,2 ГБ. Коефіцієнт 0,36 — частка теоретичної стелі, яку чипи показали в замірах MacStories, порахована тією самою мірою, що й оцінки (4-бітний файл, 11,2 ГБ на токен): у M5 Ultra 1228 ÷ 11,2 ≈ 110 ток/с стелі, а виміряно 41, тобто 0,37; у M3 Ultra 819 ÷ 11,2 ≈ 73 і 26, тобто 0,36. Збірка MacStories з увагою у 8 бітах читає на токен трохи більше, тож реальна частка радше вища.
Приклад розрахунку для Mac Studio або MacBook Pro на M5 Max зі 128 ГБ: 0,36 × 614 ÷ 6,8 ≈ 32 ток/с. LLMCheck за своєю моделлю дає для тієї самої машини близько 27: наша оцінка вища приблизно на 20%, і справжнього заміру на M5 Max поки немає ні в кого.
Що видно на графіку: заміри на Ultra й оцінки за формулою лежать в одному коридорі 26–41 ток/с, а DGX Spark зі смугою 273 ГБ/с удвічі повільніший за будь-який Mac Max. Зростання смуги на 50% (M3 Ultra → M5 Ultra) дало в замірі MacStories +58% швидкості — це узгоджується з формулою, хоча двох точок для повної перевірки замало.Машина й квант Генерація, ток/с Читання 16K-промпту, ток/с Тип даних Mac Studio M5 Ultra 256 ГБ, MLX 4/8 біт 41 1107 замір MacStories Mac Studio M5 Ultra 256 ГБ, llama.cpp 39,7 (≈61 з MTP) н/д замір спільноти Mac Studio M5 Ultra 256 ГБ, Q4_K_XL ≈ 39 (оцінка) н/д 0,36 × 1228 ÷ 11,2 Mac Studio M3 Ultra 512 ГБ, MLX 4/8 біт 26 428 замір MacStories Mac Studio M3 Ultra 256/512 ГБ, Q4_K_XL ≈ 26 (оцінка) н/д 0,36 × 819 ÷ 11,2 M5 Max 128 ГБ, IQ3_XXS ≈ 32 (оцінка) н/д 0,36 × 614 ÷ 6,8 M4 Max 128 ГБ, IQ3_XXS ≈ 29 (оцінка) н/д 0,36 × 546 ÷ 6,8 DGX Spark 128 ГБ, IQ3_XXS ≈ 14 (оцінка) н/д 0,36 × 273 ÷ 6,8 RTX 4090 24 ГБ + 128 ГБ DDR5 теоретичний пік ≈ 16 (наш розрахунок) н/д див. нижче RTX 5090 32 ГБ + 128 ГБ DDR5 теоретичний пік ≈ 18 (наш розрахунок) н/д див. нижче RTX 4090 + 64 ГБ ОЗП, RTX 3060 не вміщується — 88 ГБ < 100 ГБ мінімуму
Застереження до оцінок. Коефіцієнт 0,36 виведено на Ultra в MLX: на Max у llama.cpp реальна частка може виявитися і вищою, і нижчою. MTP (multi-token prediction — модель вгадує одразу кілька наступних токенів) у llama.cpp 0.7.0 піднімає швидкість на M5 Ultra приблизно до 61 ток/с за заміром спільноти, але це інший режим роботи, і в оцінки ми його не закладаємо.
Чому RTX тут слабший. Жодна ігрова відеокарта Flash цілком не тримає: у RTX 5090 32 ГБ відеопам’яті, у RTX 4090 — 24 ГБ, а найлегший файл — 93 ГБ. Лишається схема «частина ваг у відеокарті, решта в оперативній пам’яті», і швидкість тоді задає вже ОЗП. Дві планки DDR5-5600 у двох каналах теоретично дають 89,6 ГБ/с (5600 млн передач за секунду × 8 байт × 2 канали). Це наш розрахунок за стандартом пам’яті, а не замір, і на практиці виходить менше. Навіть теоретичний пік у 6–14 разів нижчий, ніж у Mac Max і Ultra.
Оцінка стелі для RTX 4090 зі 128 ГБ DDR5 і квантом IQ3_XXS: із 120 ГБ близько 100 ГБ лежать в ОЗП, отже, на токен звідти читається приблизно 6,8 × 100/120 ≈ 5,7 ГБ, і стеля — 89,6 ÷ 5,7 ≈ 16 ток/с. У RTX 5090 відеопам’яті 32 ГБ, в ОЗП лишається близько 90 ГБ: 6,8 × 90/120 ≈ 5,1 ГБ на токен, стеля 89,6 ÷ 5,1 ≈ 18 ток/с. Це теоретичний пік за нашим розрахунком, а не прогноз, і справжнього заміру GLM-5.3-Flash на такій збірці немає. Якщо взяти ту саму частку 0,36 від стелі, що в Mac, вийде близько 6 ток/с — але це припущення ще грубіше. Цифр із переказів для RTX 4090 з 64 ГБ ОЗП ми не наводимо: першоджерела в них немає, а 24 + 64 = 88 ГБ менше за 100 ГБ, які Unsloth називає мінімумом навіть для 1 біта.
Якщо пам’яті бракує зовсім, llama.cpp може читати відсутні ваги просто з SSD. За замірами, які зібрав Pinggy, це перетворює «не запускається» на «1–2 токени за секунду» — годиться для нічного пакетного завдання, але не для чату.
Як запустити GLM-5.3-Flash локально: llama.cpp, MLX і пастка Ollama
Звичайному користувачеві реально запустити GLM-5.3 удома лише у версії Flash. Нижче шлях для Mac через llama.cpp — безплатну програму для запуску моделей. Загальні принципи й попередні версії GLM — у нашому гайді «GLM від Z.ai на своєму ПК».
- Перевірте обсяг пам’яті. Потрібен Mac зі 128 ГБ єдиної пам’яті й більше. На 96 ГБ і менше Flash не вміщується в жодному кванті.
- Подивіться ліміт відеоядра. Команда
sysctl iogpu.wired_limit_mb— відповідь 0 означає системні ~75% пам’яті. - Підніміть ліміт, якщо у вас 128 ГБ. Для 2-бітного Q2_K_XL —
sudo sysctl iogpu.wired_limit_mb=114688(112 ГіБ). Для IQ3_XXS —sudo sysctl iogpu.wired_limit_mb=122880(120 ГіБ): це межа, системі залишиться мало пам’яті, стежте за «Тиском пам’яті» в Моніторингу системи. Після кожного перезавантаження команду треба повторити. - Встановіть свіжий llama.cpp. Підтримку архітектури Flash (вона називається glm5-next) влили 30 вересня 2026 року в PR #27773, збірка b11279. Найпростіше —
brew install llama.cpp: Homebrew ставить версію 0.7.0, у ній уже є й MTP. - Завантажте й запустіть квант.
llama-cli -hf unsloth/GLM-5.3-Flash-GGUF:UD-IQ3_XXS -c 16384. Ключ-c 16384задає контекст у 16 тис. токенів. Це обережна стартова точка, а не замір: якщо пам’яті бракує, зменште контекст або візьміть Q2_K_XL. На Mac 256 ГБ замінітьUD-IQ3_XXSнаUD-Q4_K_XLі підніміть ліміт (крок 3) під обсяг своєї пам’яті. - Якщо файли завантажено до 5 жовтня — перезавантажте перший шард. Ранні GGUF називали архітектуру
glm5nextі в штатному llama.cpp не відкриваються. Unsloth переписав перший файл кожного кванта (9 МБ) 5 жовтня, решту 100+ ГБ завантажувати наново не потрібно. - Альтернатива — MLX. Штатний mlx-lm цю архітектуру не підтримує. Працюють oMLX (збірки від ~2 біт на 110 ГБ для Mac 128 ГБ) і mlx-vlm (збірка mlx-community у 4 бітах, 204 ГБ, для Mac 256 ГБ). Перед завантаженням 200 ГБ звірте розмір збірки з обсягом пам’яті.
Пастка Ollama. Багато хто чекає, що ollama run glm-5.3-flash завантажить модель до них на комп’ютер. Це не так: офіційний запис у бібліотеці Ollama станом на 25.10.2026 — лише хмарний.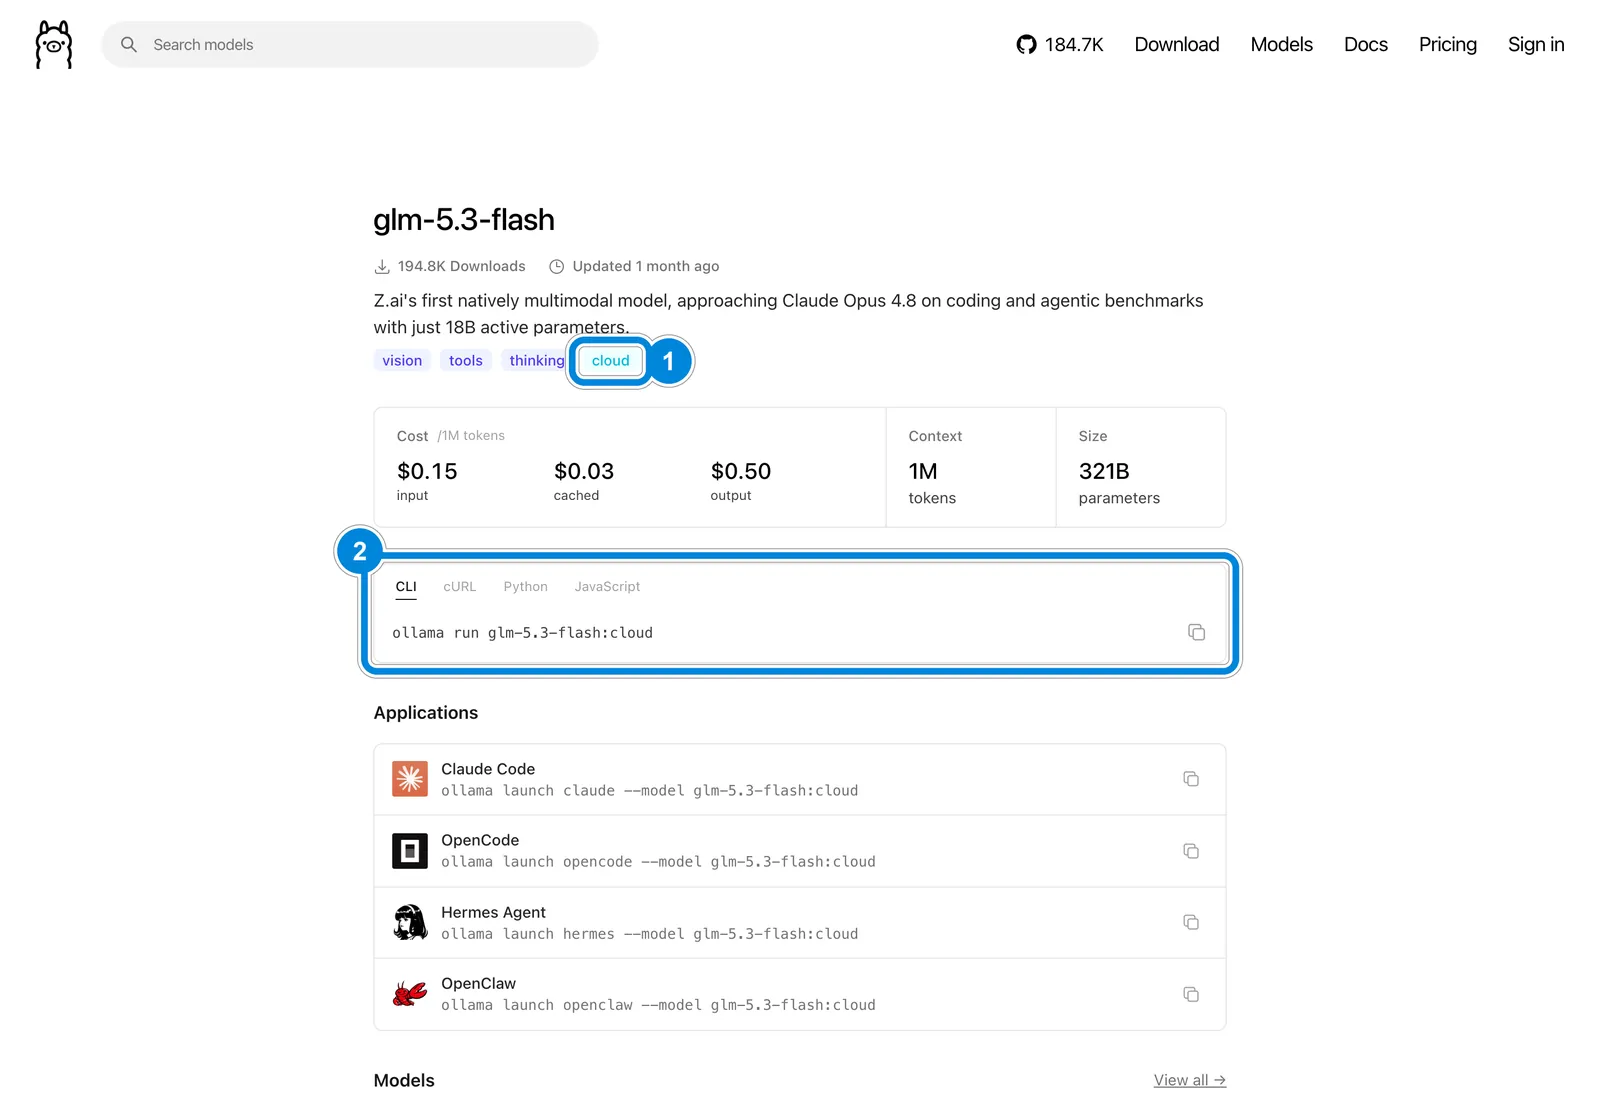
На знімку сторінки від 25.10.2026 рамка 1 показує мітку cloud, рамка 2 — команду ollama run glm-5.3-flash:cloud. Такий запуск надсилає запити на сервери Ollama, ваги не завантажуються. Для локальної роботи з GLM-5.3-Flash потрібен llama.cpp або oMLX.
Для RTX і Windows. Шлях той самий llama.cpp, але з вивантаженням експертів в оперативну пам’ять. Із 7 жовтня 2026 року в llama.cpp є ключ --moe-cache-mib (PR 29887): експерти живуть в ОЗП, а ті, що використовуються часто, кешуються на відеокарті. На GLM-5.3-Flash цей режим офіційно не вимірювали, тому швидкість лишається оцінкою з розділу вище.
Сильні й слабкі сторони двох моделей Z.ai в одній таблиці
| Плюси | Мінуси |
|---|---|
| Відкриті ваги обох моделей, у Flash — MIT без застережень | У флагмана власна ліцензія замість MIT, як було в GLM-5.2 |
| 45 балів в індексі AA — трійка найкращих відкритих моделей станом на 25.10.2026 | За зведеним балом не перша: MiMo-V2.6-Pro вище, DeepSeek V4.1 Flash 1017 нарівні й дешевша |
| Перша за Terminal-Bench 4.0 серед порівнюваних — 42% | Завдання індексу AA коштує $2,01 — у 8–15 разів дорожче, ніж у суперників того самого рівня |
| Flash уміщується в один Mac на 128–256 ГБ, 26–41 ток/с за замірами на Ultra | Флагман удома лише на Mac Studio 256–512 ГБ, в 1–2 бітах — із помітною втратою точності |
| Дешевий API Flash: $0,15 / $0,50 за мільйон токенів | Слабкий вбудований захист: обхід у 64–100% випадків за даними Anthropic |
| Підтримка в llama.cpp, oMLX і mlx-vlm | Підтримка молода: ранні GGUF несумісні, штатний mlx-lm не відкриває, Ollama лише в хмарі |
Ризики GLM-5.3: кіберможливості, слабкий захист і юрисдикція
Відкриті ваги — це свобода і для вас, і для зловмисника. У GLM-5.3 це питання гостріше, ніж у більшості моделей.
- Сильні кібернавички. NIST CAISI 17 вересня 2026 року назвав GLM-5.3 найбільш кіберспроможною відкритою моделлю на той момент. Модель завантажує будь-хто, і відкликати її вендор не має змоги.
- Слабкий вбудований захист — за даними конкурента. Оцінку обходу захисту опублікувала Anthropic 29 вересня 2026 року. Anthropic — прямий конкурент Z.ai. У тій самій статті вона пише, що ці прийоми не спрацювали проти її моделей Claude, але умови не рівні: ваги Claude закриті, їх не можна переробити, а API Anthropic не дає підставити моделі початок міркування. Оцінку кіберможливостей Anthropic дає ту саму, що й NIST. Цифри щодо обходу захисту є лише в неї. У симуляції на прямі шкідливі запити GLM-5.3 відмовляла в усіх спробах. З вигаданою легендою («ти агент червоної команди на навчаннях») вона погоджувалася в 64% випадків, із підставленим початком міркування — у 92%, після абляції — у 100%.
- Абляція — це недорого. Абляція — зміна ваг, яка прибирає в моделі звичку відмовляти. За Anthropic, вона знизила частку відмов GLM-5.3 з понад 90% приблизно до 3% у JailbreakBench і майже не зачепила здібностей моделі. Команді, яка робила це вперше, знадобилося близько 2200 GPU-годин, приблизно $4400 обчислень; досвідченій команді, за оцінкою Anthropic, вистачило б близько 600 GPU-годин (~$1200), а абляція Flash зайняла близько 600 GPU-годин. Готові «розцензуровані» версії з’явилися у відкритому доступі за кілька днів після релізу.
- Заяви вендора ≠ незалежний тест. Таблиця бенчмарків у картці — заміри Z.ai. Незалежні цифри — AA і NIST, і вони скромніші: наприклад, індекс AA станом на 25.10.2026 ставить модель не першою, а до трійки відкритих моделей, після MiMo-V2.6-Pro.
- Хмарний API — чужа інфраструктура. NIST описує Z.ai як компанію з КНР. Запити до офіційного API обробляються на її серверах за її правилами зберігання даних. Для конфіденційного коду й документів надійніший локальний запуск або провайдер зі зрозумілою політикою.
- Перевантаження провайдерів. Команда CMS Wagtail збиралася місяць писати код лише на GLM-5.3 Flash через сторонніх провайдерів. Це вдалося на першу половину місяця, і Flash вклалася в бюджет: $68. У другій половині більшість токенів пішла на інші моделі. Команда зазначила, що саме у Flash падала продуктивність у провайдерів: модель популярна, а потужностей у провайдерів менше, ніж у великих лабораторій.
- Молода підтримка софту. Штатний llama.cpp запускає Flash лише з 30 вересня 2026 року, ранні файли GGUF несумісні, штатний mlx-lm модель не відкриває. Інструкції місячної давності вже застаріли.
- Флагман удома — із втратою точності. На Mac Studio 256 ГБ GLM-5.3 працює лише в 1–2 бітах, де стиснена модель збігається з оригіналом у виборі токена в 72–79% випадків (Unsloth).
Що обрати під завдання: хмарний API, Flash на Mac чи флагман
Вибір упирається в три питання: чи потрібна приватність, скільки токенів на місяць і чи є вже Mac на 128 ГБ і більше.Ваш випадок Що брати Чому Спробувати модель, пишете код час від часу API GLM-5.3-Flash $0,15 / $0,50 за мільйон токенів станом на 25.10.2026, нічого купувати не треба Агент, який годинами працює в терміналі API GLM-5.3 42% у Terminal-Bench 4.0 проти 34–35% у суперників із тим самим балом Сильна модель для загальних завдань за менші гроші API DeepSeek V4.1 Flash 1017 або MiMo-V2.6-Pro той самий або більший бал AA, завдання за $0,26 і $0,13 проти $2,01 Код і документи не можна віддавати в хмару, є Mac 128 ГБ Flash у 2–3 бітах уміщується після підняття ліміту, ≈29–32 ток/с за оцінкою, контекст короткий Потрібні приватність і довгий контекст Flash Q4_K_XL на Mac Studio 256 ГБ 92% збігу з оригіналом, ≈39–41 ток/с, після підняття ліміту — кілька десятків гігабайтів під контекст Потрібен саме флагман локально GLM-5.3 Q4_K_XL на Mac Studio 512 ГБ файл 467 ГБ, 384 ГіБ ліміту за замовчуванням — доведеться піднімати Ігровий ПК з RTX 4090/5090 API або DeepSeek V4 Flash локально Flash упреться в оперативну пам’ять, теоретичний пік ≈16–18 ток/с (наш розрахунок)
Розрахунок: коли API вигідніший. Припустімо, ви надсилаєте 100 млн токенів запитів і отримуєте 10 млн токенів відповідей на місяць — це щільна щоденна робота агента. На Flash через API це 100 × $0,15 + 10 × $0,50 = $20 на місяць, на флагмані — 100 × $1,40 + 10 × $4,40 = $184. Зважайте, що агент повторно надсилає ту саму історію, а кешований вхід у Z.ai дешевший: $0,03 у Flash і $0,26 у флагмана за мільйон.
Безплатного доступу до GLM-5.3 і Flash у Z.ai немає. У прайсі станом на 25.10.2026 безплатні лише старі GLM-4.7-Flash, GLM-4.5-Flash і GLM-4.6V-Flash, а в GLM-5.3 безплатне лише зберігання кешу, і то «на обмежений час». Платити можна за фактом із балансу акаунта, пакетами токенів або підпискою GLM Coding Plan (особистою чи командною; із 16 жовтня 2026 року ключі для API і для підписки розділено). Які способи оплати приймаються з України, у документації Z.ai не сказано.
Тепер залізо. Станом на 25.10.2026 в українських магазинах на Hotline Mac Studio M5 Ultra в мінімальній конфігурації на 96 ГБ коштує від 273 289 грн (медіана 335 840 грн) — і Flash у таку пам’ять не вміщується. Конфігурацій на 128, 256 і 512 ГБ у базі Hotline на цю дату немає, тому їхньої ціни ми не наводимо: 273 289 грн — лише нижня межа. Навіть ця нижня межа — роки роботи Flash через API по $20 на місяць із прикладу вище. Купівля має сенс, коли приватність обов’язкова або Mac потрібен і для інших завдань. Яку конфігурацію брати під локальні моделі, розбираємо в хабі «Який Mac обрати».
Короткі сценарії:
- Новачкові — API Flash: дешево, швидко, без налаштування.
- Розробникові з Mac на 128 ГБ — Flash локально у 2–3 бітах для простих завдань, складні віддавати хмарній моделі.
- Команді з чутливими даними — Mac Studio на 256 ГБ і Flash у 4 бітах: 92% збігу з оригіналом за метрикою Unsloth і 39–41 ток/с.
- Тим, кому потрібна максимальна якість — GLM-5.3, MiMo-V2.6-Pro або DeepSeek V4.1 Flash 1017 через API: удома флагман втрачає забагато точності.
Що застаріє першим: ціни API (у Z.ai бувають промознижки), індекс AA (версії змінюються) і підтримка в програмах. Свіжі дані — на картці моделі на Hugging Face і в прайсі Z.ai.
FAQ
Чи викладено ваги GLM-5.3 — чи можна завантажити модель?
Так. Z.ai випустила GLM-5.3 в API 14 серпня 2026 року й виклала ваги через два тижні, 28 серпня. Репозиторій zai-org/GLM-5.3 на huggingface.co відкритий без заявки: за останній місяць станом на 25.10.2026 його завантажили 2 074 062 рази. Молодшу GLM-5.3-Flash опублікували 26 серпня під ліцензією MIT, і її завантажують утричі частіше.
GLM-5.3 Flash vs GLM-5.3: чим відрізняються і яку запускати вдома?
Flash — окрема модель на новій базі: 320 млрд параметрів проти 753 млрд у флагмана, 18 млрд активних проти 40 млрд, ліцензія MIT замість власної та підтримка зображень. За індексом Artificial Analysis Flash відстає на три бали (42 проти 45). Удома запускають саме Flash: їй вистачає Mac зі 128–256 ГБ, флагману потрібно 256–512 ГБ.
Скільки пам’яті потрібно, щоб запустити GLM-5.3-Flash на Mac?
Мінімум 128 ГБ єдиної пам’яті. На такому Mac уміщуються кванти у 2 біти (102–109 ГБ) і 3-бітний IQ3_XXS на 120 ГБ — останній лише після того, як ви піднімете ліміт відеоядра командою sysctl приблизно до 120 ГіБ, і контекст доведеться тримати коротким. Комфортні 4 біти (200 ГБ) потребують Mac Studio на 256 ГБ. Mac на 96 ГБ не підходить.
Чи підтримує Ollama GLM-5.3 локально?
Ні, станом на 25.10.2026 офіційні записи glm-5.3-flash і glm-5.3 в Ollama — хмарні, із суфіксом :cloud. Команда ollama run glm-5.3-flash:cloud надсилає запити на сервери Ollama й нічого не завантажує. Щоб працювати без інтернету, використовуйте llama.cpp версії b11279 або новішої з файлами GGUF від Unsloth чи oMLX на Mac.
Чи можна використовувати GLM-5.3 у комерційних проєктах?
Так. GLM-5.3-Flash випущено під MIT — комерцію, зміни й поширення дозволено із зазначенням авторства. Флагман GLM-5.3 під власною ліцензією теж дозволяє комерцію. Єдина умова стосується компаній, які продають доступ до моделі як сервіс і заробляють понад $10 млрд за 12 місяців: їм потрібна перевірка безпеки Z.ai.
Чи запуститься GLM-5.3-Flash на RTX 4090 або RTX 5090?
Цілком у відеокарту — ні: найлегший файл важить 93 ГБ, а в RTX 5090 32 ГБ пам’яті. Працюватиме зв’язка відеокарти й 128 ГБ оперативної пам’яті, але швидкість упреться в ОЗП: теоретичний пік за нашим розрахунком — близько 16–18 ток/с, на практиці помітно нижче. З 64 ГБ ОЗП не вистачить пам’яті навіть на 1-бітний квант.