Коротко (TL;DR)
Видеокарта для игр и локального ИИ на одном компьютере — это компромисс между двумя разными наборами требований. Игре нужны вычислительные блоки, трассировка лучей и апскейл, языковой модели — объём видеопамяти (VRAM) и скорость её чтения. Одна карта закрывает оба сценария, когда в её памяти хватает места и игре, и модели, а владелец умеет выгружать модель перед запуском игры.
- Коротко (TL;DR)
- Игры и локальный ИИ просят у видеокарты разное: шейдеры против VRAM
- Какая видеокарта для игр и ИИ: тиры 8, 12, 16 и 24–32 ГБ VRAM
- Сколько VRAM съедает игра, пока в видеопамяти висит LLM
- NVIDIA, AMD или Intel для игр и ИИ на одном ПК
- Как играть, когда модель в видеопамяти: Ollama, LM Studio, драйвер
- Блок питания, нагрев и шум при долгой нагрузке LLM на игровой карте
- Б/у RTX 3090 24 ГБ для игр и ИИ: уже не бюджетный компромисс
- Брать сейчас или ждать: цены 15 ноября и судьба RTX 50 Super
- Три бюджета на видеокарту для игр и ИИ: чем жертвует каждый
- Итоговая таблица: какая видеокарта закрывает игры и ИИ по бюджету
- FAQ
Цифры — из независимых тестов с указанием методики, цены — на 15 ноября 2026 года.
- 16 ГБ — нижняя граница. Тяжёлая игра в 1440p занимает 10,4–12,0 ГБ, модель Llama 3.1 8B в кванте Q4_K_M — ещё 4,92 ГБ. Вместе выходит впритык (наш расчёт).
- 12 и 8 ГБ — ловушка. На 12 ГБ рядом с игрой не встаёт даже модель 8B, на 8 ГБ игра и модель живут только по очереди.
- Ничья в играх — не ничья в ИИ. RX 9070 XT и RTX 5070 Ti равны по fps, но RTX 5070 Ti через CUDA генерирует текст примерно на 30 % быстрее.
- Цены далеки от MSRP. RTX 5070 Ti в Украине — от 70 839 ₴ на Hotline, рабочая б/у RTX 3090 на OLX — 55–80 тыс. ₴, почти столько же.
- RTX 50 Super на полках нет, а 12 ноября 2026 года появились сообщения об отмене RTX 5080 на 24 ГБ (NVIDIA их не подтверждала).
- Главный навык — знать, что лежит в VRAM. Ollama держит модель в памяти 5 минут после последнего запроса.
Игры и локальный ИИ просят у видеокарты разное: шейдеры против VRAM
Игра каждую секунду рисует десятки кадров, и нагрузка ложится на вычислительные блоки: шейдерные ядра, RT-ядра для трассировки лучей, тензорные ядра для апскейла DLSS. Видеопамять важна, пока в неё помещаются текстуры; сверх этого гигабайты fps не добавляют.
Языковая модель (LLM) пишет текст по одному токену — кусочку слова. Чтобы выдать каждый следующий токен, карта заново читает из памяти все веса модели. Поэтому скорость генерации упирается в пропускную способность памяти (ГБ/с), а размер модели, которую вообще можно запустить, — в объём VRAM. Если модель не поместилась целиком, часть её слоёв уезжает в оперативную память компьютера, и скорость падает в разы.
Генерация картинок (диффузионные модели SDXL и FLUX) стоит посередине: она много считает, как игра, и много занимает, как LLM. Файл FLUX.1-dev в формате fp8 весит 17,2 ГБ.Сценарий Что ограничивает Главная метрика Пример на цифрах Игры в 1440p и 4K шейдерные и RT-ядра, апскейл; VRAM — пока хватает под текстуры fps (средний и 1% low) RX 9070 XT — 116,5 fps, RTX 5070 Ti — 116,8 fps в 1440p (Tom’s Hardware) Генерация текста LLM объём VRAM (что поместится) и ГБ/с (как быстро) токенов в секунду (ток/с) RTX 3090 при 936 ГБ/с — 158,16 ток/с, RTX 5060 Ti при 448 ГБ/с — 90,94 ток/с Чтение длинного промпта вычислительные блоки ток/с обработки промпта (pp512) RTX 5070 Ti — 6952, RX 9070 XT — 5202, Arc B580 — 621 Генерация картинок и вычисления, и VRAM секунд на кадр 1024×1024 FLUX.1-dev fp8: RTX 3090 — 23,23 с, RTX 5060 Ti 16 ГБ — 37,02 с
Пример — RTX 3090 и RTX 5070. В играх новая карта чуть быстрее (96,4 против 91,5 fps в 1440p по Tom’s Hardware, 53 против 49 fps в Gears of War: E-Day по TechSpot), но у RTX 3090 вдвое больше памяти: в её 24 ГБ помещается Qwen3 32B, в 12 ГБ — нет.
Отсюда порядок выбора: сначала объём VRAM (какие модели встанут рядом с игрой), затем пропускная способность и софт — CUDA у NVIDIA, Vulkan и ROCm у AMD (скорость генерации), и только потом игровой fps (разрешение и настройки).
Какая видеокарта для игр и ИИ: тиры 8, 12, 16 и 24–32 ГБ VRAM
Для игр и локального ИИ на одной карте нужен минимум 16 ГБ видеопамяти: это RTX 5060 Ti 16 ГБ, RX 9060 XT 16 ГБ, RX 9070 XT, RTX 5070 Ti и RTX 5080. 12 ГБ хватает играм, но не игре вместе с моделью. На 8 ГБ всё работает только по очереди. 24 ГБ (б/у RTX 3090) и 32 ГБ (RTX 5090) дают запас под модели 14–32B рядом с игрой.
Вопрос «сколько ГБ должно быть у видеокарты» в двойном сценарии решает не игра, а модель, поэтому в таблице fps и токены стоят рядом.
Откуда цифры. Игровые fps — из иерархии видеокарт Tom’s Hardware от 24 июня 2026 года: средний fps по набору игр, пресет Ultra, растеризация без трассировки лучей, процессор Ryzen 7 9800X3D. Скорость генерации — из скорбордов сообщества llama.cpp: модель Llama 2 7B в кванте Q4_0, тест llama-bench, вся модель в видеопамяти, без flash attention. Для каждой карты взят основной бэкенд в скорборде: CUDA у NVIDIA, Vulkan у AMD и Intel.Карта VRAM ГБ/с fps 1440p fps 4K ток/с, 7B Q4_0 Рядом с игрой в 1440p (наш расчёт) Intel Arc B580 12 ГБ GDDR6 456 50,7 27,6 70,14 (Vulkan) только по очереди RTX 5070 12 ГБ GDDR7 672 96,4 54,3 н/д только по очереди RX 9060 XT 16 ГБ 16 ГБ GDDR6 320 67,3 н/д 71,07 (Vulkan) модель 8B впритык RTX 5060 Ti 16 ГБ 16 ГБ GDDR7 448 73,4 40,2 90,94 (CUDA) модель 8B впритык RX 9070 XT 16 ГБ GDDR6 640 116,5 65,8 136,56 (Vulkan) модель 8B впритык RTX 5070 Ti 16 ГБ GDDR7 896 116,8 68,6 176,85 (CUDA) модель 8B впритык RTX 5080 16 ГБ GDDR7 960 128,3 77,4 181,99 (CUDA) модель 8B впритык RTX 3090 (б/у) 24 ГБ GDDR6X 936 91,5 53,1 158,16 (CUDA) модель 14B RTX 5090 32 ГБ GDDR7 1792 167,3 110,8 290,02 (CUDA) модель 32B впритык 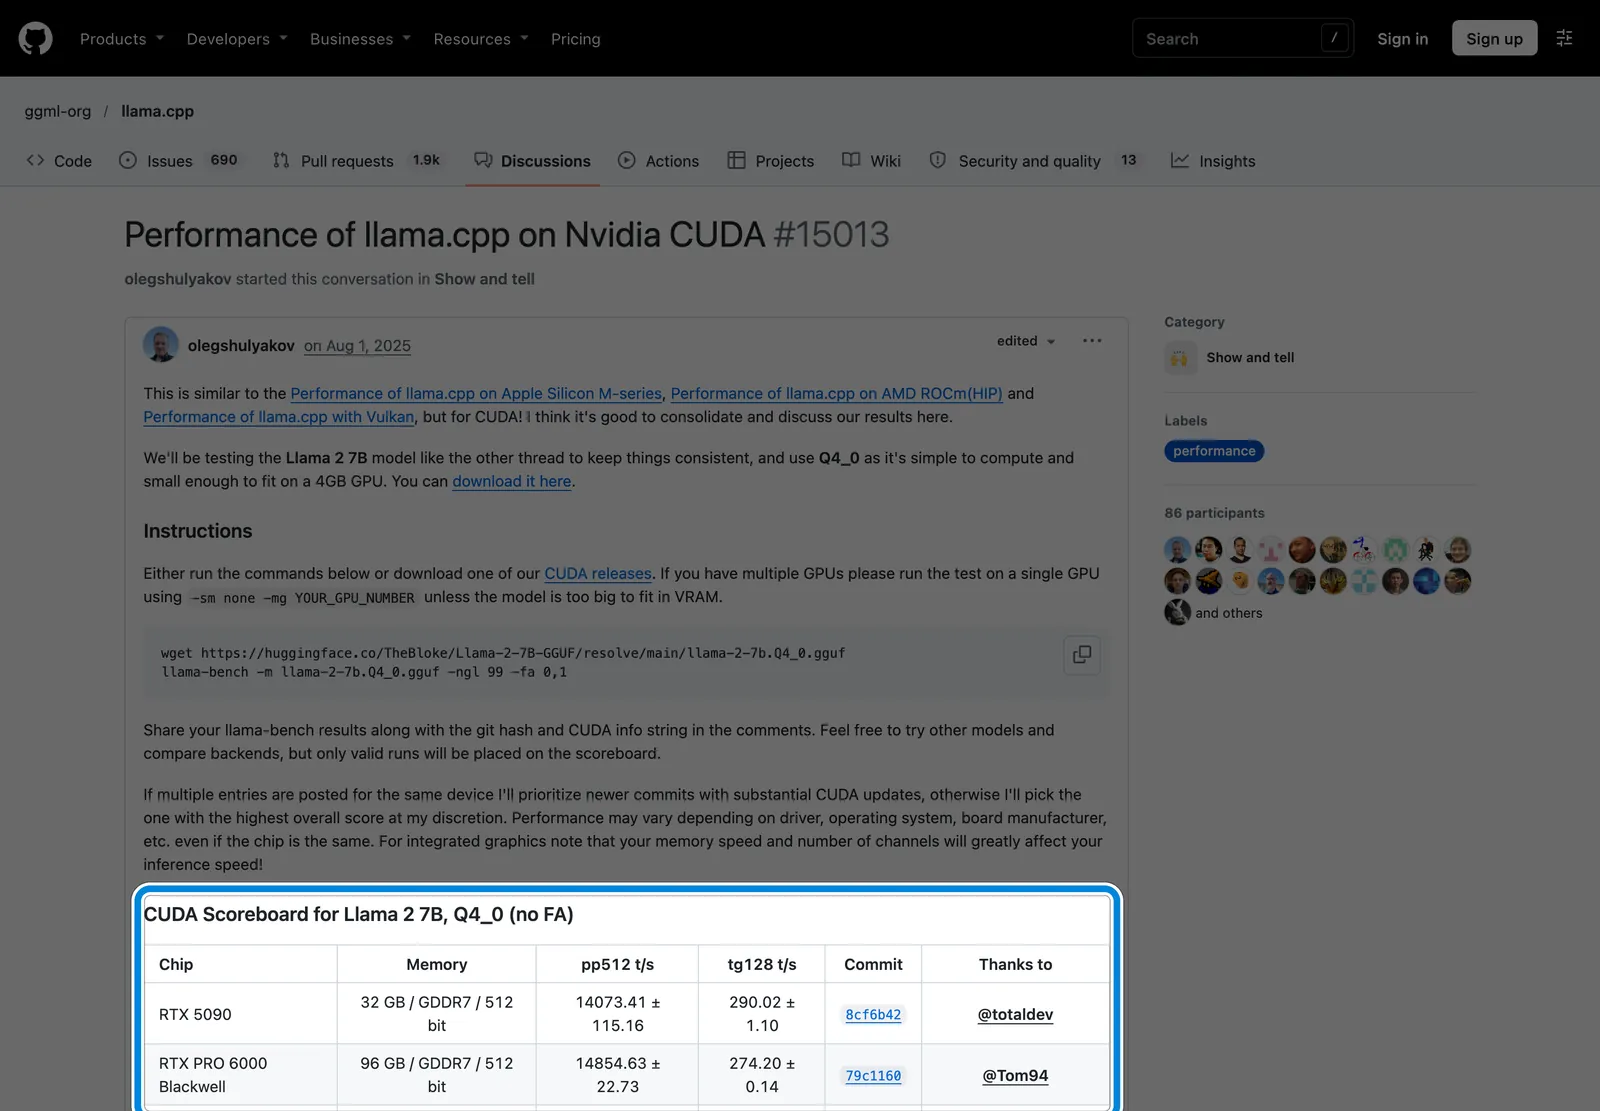
На снимке — первоисточник столбца с токенами: обсуждение llama.cpp №15013, открытое 15 ноября 2026 года. Рамкой выделен скорборд CUDA: в столбце tg128 — скорость генерации, сверху RTX 5090 с 290,02 ток/с. Это воспроизводимые замеры сообщества с версией сборки, а не лаборатории.
8 ГБ — тупик для игры и модели одновременно
Карты на 8 ГБ в играх по замерам PC Gamer держатся около 7 ГБ занятой памяти, почти под потолком: даже модели 8B (4,92 ГБ) рядом с игрой места нет. И в играх 8 ГБ уже тесно: на 4K RTX 5060 Ti 8 ГБ даёт 28,1 fps против 40,2 у версии на 16 ГБ (Tom’s Hardware), а в Cyberpunk 2077 в 1440p с трассировкой 1% low — 34 против 41 fps (PC Gamer).
12 ГБ — ловушка: играет хорошо, модели тесно
RTX 5070 12 ГБ в 1440p быстрее RTX 5060 Ti 16 ГБ на 31 % (96,4 против 73,4 fps; наш расчёт). Но игра в 1440p занимает 10–12 ГБ, и модель 14B (9,00 ГБ) рядом уже не встанет. Та же история у Intel Arc B580. В Украине ловушка ещё и дорогая: на 15 ноября 2026 года RTX 5070 на Hotline дороже RTX 5060 Ti 16 ГБ и стоит почти как RX 9070 XT 16 ГБ.
16 ГБ — минимальный баланс игры и модели
На 16 ГБ игра в 1440p и модель 8B помещаются вместе, но без запаса. Модели 14B и gpt-oss 20B работают в одиночку, без игры. По тесту Hardware Corner (рейтинг обновлён в декабре 2025 года, контекст 16 тыс. токенов) RTX 5070 Ti выдаёт 57,98 ток/с на Qwen3 14B и 133,05 ток/с на gpt-oss 20B, а RTX 5060 Ti 16 ГБ — 32,91 и 82,42 ток/с. Qwen3 32B в 16 ГБ не помещается ни у одной карты.
24–32 ГБ — запас под модели 14–32B
RTX 3090 на 24 ГБ держит игру в 1440p вместе с моделью 14B, а без игры — Qwen3 32B: 30,28 ток/с при контексте 16 тыс. токенов. RTX 5090 на 32 ГБ с той же моделью выдаёт 50,92 ток/с, а игру в 1440p вместе с моделью 32B вмещает впритык.
Сколько VRAM съедает игра, пока в видеопамяти висит LLM
Игра в 1440p на карте с 16 ГБ занимает от 6 до 12 ГБ видеопамяти. По замерам PC Gamer (март 2026 года) Cyberpunk 2077 с трассировкой лучей держит 10,4 ГБ, The Last of Us Part 1 — до 12,0 ГБ, Arc Raiders — 6,0–7,4 ГБ. Модели 8B в 4-битном кванте нужно ещё 4,92 ГБ под веса, поэтому на 16 ГБ вместе они помещаются только впритык.
Замеры сделаны программой CapFrameX с апскейлом в режиме Quality на RTX 5060 Ti и RX 9060 XT. Сам PC Gamer делает вывод, что на 8 ГБ играть в 2026 году ещё можно, но версии на 16 ГБ заметно лучше по 1% low. ComputerBase считает достаточными 12 ГБ для максимальных настроек с трассировкой в 1440p, а 8 ГБ — нет. Значит, видеокарта для игр в 2K (так часто называют 1440p) с трассировкой — от 12 ГБ, а под игру вместе с моделью — от 16.Игра Пресет (1440p) Занято VRAM, ГБ Cyberpunk 2077 Ultra + трассировка лучей 10,4 The Last of Us Part 1 Ultra 10,4–12,0 Resident Evil Requiem High 10,2–11,2 Kingdom Come: Deliverance II Ultra 8,5–10,1 Arc Raiders Epic 6,0–7,4
Меньшее значение — на RTX 5060 Ti, большее — на RX 9060 XT. Оговорка PC Gamer: при 16 ГБ движки занимают памяти столько, сколько им дали, так что это верхняя оценка, а не минимум.
С 4K источники расходятся. ComputerBase считает достаточными 12 ГБ и на 4K с трассировкой (Resident Evil Requiem, Gears of War: E-Day). BGR 7 ноября 2026 года насчитал до 14,5 ГБ в Control Resonant с трассировкой и шестикратной генерацией кадров и около 15 ГБ в Resident Evil Requiem. ComputerBase смотрит, когда падает производительность, BGR — сколько памяти занято. Поэтому, выбирая видеокарту для игр в 4K под двойной сценарий, закладывайте 12–15 ГБ только под игру. Вместе с моделью 8B выходит 17–20 ГБ (наш расчёт), и такая пара помещается только на картах с 24–32 ГБ.
Утверждение продавца сборок Arsenal PC, что игры с текстур-паками «тянут 18–22 ГБ», независимые замеры не подтверждают.
Сложим игру в 1440p (по PC Gamer) и файл модели в кванте Q4_K_M (по Hugging Face) — наш расчёт:Модель (Q4_K_M) Веса, ГБ Игра + модель, ГБ 12 ГБ 16 ГБ 24 ГБ 32 ГБ Llama 3.1 8B 4,92 15,3–16,9 нет впритык да да Qwen3 14B 9,00 19,4–21,0 нет нет да да Qwen3 32B 19,76 30,2–31,8 нет нет нет впритык
Это арифметика на средних замерах, а не гарантия. Сверх весов нужна память под контекст (KV-кэш): Qwen3 32B на RTX 3090 при контексте около 16 тыс. токенов занимает в пике 19 214 МиБ из 24 576. Как считать память под свою задачу — в материале о том, сколько VRAM нужно для локальных LLM.
NVIDIA, AMD или Intel для игр и ИИ на одном ПК
Если спросить, какая видеокарта лучше для игр — AMD или NVIDIA, в среднем ценовом классе ответ почти ничья: RX 9070 XT даёт 116,5 fps в 1440p, RTX 5070 Ti — 116,8 fps. Разница появляется, когда на той же карте запускают нейросеть, и она больше про программы, чем про железо. На одинаковом бэкенде Vulkan в llama.cpp карты идут вровень: 136,56 ток/с у RX 9070 XT против 135,63 у RTX 5070 Ti. Через CUDA — родной программный интерфейс NVIDIA — RTX 5070 Ti выдаёт 176,85 ток/с, на 30 % больше, а промпт читает на 34 % быстрее (наш расчёт).Вендор Игры Программы для LLM Сильная сторона Слабое место NVIDIA (RTX 50) паритет с AMD в своём классе, DLSS CUDA во всех программах: Ollama, LM Studio, llama.cpp, ComfyUI +30 % к генерации на CUDA у RTX 5070 Ti дороже: в Украине RTX 5070 Ti на 47 % дороже RX 9070 XT AMD (RX 9000) RX 9070 XT наравне с RTX 5070 Ti Ollama на Linux через ROCm, на Windows RX 9000 — через Vulkan дешевле за те же fps и 16 ГБ GDDR6 вместо GDDR7, ниже скорость генерации Intel (Arc B580) 50,7 fps в 1440p, уровень входа llama.cpp через SYCL или Vulkan; в Ollama — через общий Vulkan-бэкенд, в списке поддерживаемых GPU Arc нет самая низкая цена входа 12 ГБ, медленное чтение промпта, IPEX-LLM в архиве
У AMD важна система: по документации Ollama RX 9070 XT и RX 9060 XT на Linux работают через ROCm, а на Windows — через Vulkan (ROCm там покрывает серию RX 7000). Где Radeon уже догнал GeForce, а где нет, — в разборе ROCm против CUDA.
Arc B580 генерирует текст на уровне RX 9060 XT (70,14 ток/с), но промпт читает в 6 раз медленнее RTX 5060 Ti — 621 против 3737 ток/с, что заметно на длинных документах. IPEX-LLM, библиотека Intel для LLM, в январе 2026 года ушла в архив, а потребительской Arc B770 нет: крупный Battlemage вышел как профессиональная Arc Pro B70.
Как играть, когда модель в видеопамяти: Ollama, LM Studio, драйвер
Играть, пока модель загружена в видеопамять, можно, если обоим хватает места. Если не хватает, игра не вылетает: Windows уводит часть данных в общую системную память, и появляются фризы и недогруженные текстуры. Проще всего этого избежать, выгрузив модель перед запуском игры. Порядок действий такой:
- Посмотрите, что сейчас в памяти. В Ollama это команда
ollama ps: она показывает загруженные модели и то, на GPU они или на процессоре. Общую занятость памяти на NVIDIA показываетnvidia-smi, на любой карте — диспетчер задач Windows, вкладка «Производительность», раздел графического процессора. - Выгрузите модель из Ollama. По умолчанию Ollama держит модель в памяти 5 минут после последнего запроса. Выгрузить сразу можно командой
ollama stop <имя модели>. - Настройте время жизни модели. Через API параметр
keep_alive: 0выгружает модель сразу после ответа, отрицательное значение держит её бессрочно. Переменная окруженияOLLAMA_KEEP_ALIVEменяет это время для всех моделей разом. - Проверьте LM Studio. Автовыгрузка через 60 минут простоя работает только для моделей, которые сервер подгрузил сам по запросу через API. Модель, загруженная вручную в интерфейсе или командой
lms load, остаётся в памяти до выгрузки: кнопкой Eject или командойlms unload --all. - Выберите драйвер. Game Ready от NVIDIA выходит чаще и несёт поддержку новых игр в день релиза, Studio — примерно раз в месяц и рассчитан на творческие программы. Оба взаимозаменяемы: на Studio можно играть, на Game Ready — запускать модели.
- Решите, нужен ли модели перенос в системную память. С драйвера 536.40 NVIDIA при нехватке видеопамяти уводит данные CUDA-программ (в том числе LLM) в оперативную память: программа не падает, но работает медленнее. С драйвера 546.01 этот режим можно отключить в панели управления NVIDIA (параметр CUDA Sysmem Fallback Policy). На игры настройка не влияет. Отключают её, чтобы LLM сразу сообщала о нехватке памяти, а не тихо замедлялась.
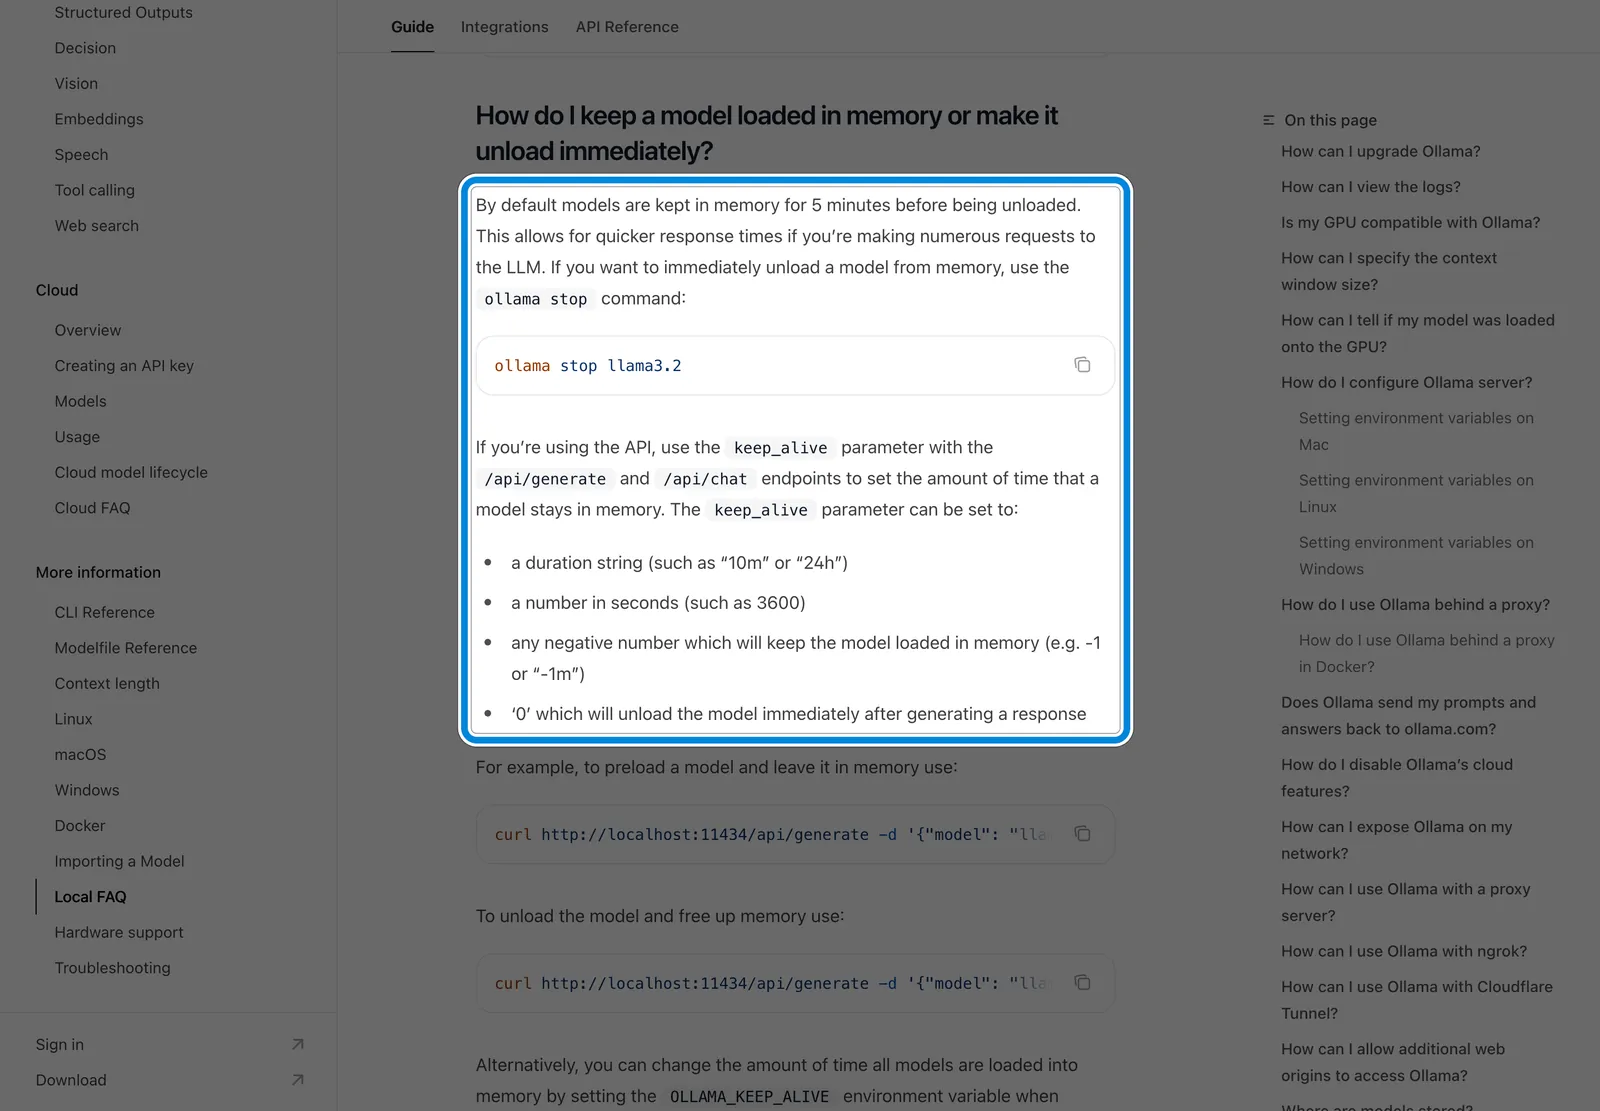
На снимке — FAQ документации Ollama, открытый 15 ноября 2026 года. Рамкой выделен ответ про 5 минут по умолчанию, команду ollama stop и значения keep_alive, включая 0. Как Ollama, LM Studio и llama.cpp отличаются по скорости, мы сравнивали в разборе Ollama, LM Studio и llama.cpp.
Держать модель на процессоре, а играть на видеокарте можно только с маленькими моделями (цифры — в FAQ). Другой путь — вторая карта только под модель, но для неё нужны слот PCIe, более мощный блок питания и запас по охлаждению.
Блок питания, нагрев и шум при долгой нагрузке LLM на игровой карте
Игры и модели вместе — это много часов нагрузки, поэтому блок питания берём по рекомендации производителя, а не по минимуму. Мощность — потребление самой карты, рекомендация по БП — на весь компьютер.Карта Мощность карты, Вт Рекомендованный БП, Вт RX 9060 XT 16 ГБ 160 450 RTX 5060 Ti 16 ГБ 180 600 Intel Arc B580 190 600 RTX 5070 250 650 RTX 5070 Ti 300 750 RX 9070 XT 304 750 RTX 3090 350 750 RTX 5080 360 850 RTX 5090 575 1000
Для LLM у игровой карты есть почти бесплатная настройка — ограничение мощности. Генерация текста упирается в память, а не в вычисления, поэтому скорость почти не падает. RTX 3090 Ti при снижении лимита с 450 до 300 Вт потеряла 2,9 % скорости генерации (52,6 → 51,1 ток/с) при минус 23 % энергии на токен (замер Chrystian Schutz). RTX 5090 при 600 → 400 Вт — минус 1,4 % к генерации, но минус 13,8 % к чтению промпта (GPUWerk). Это одиночные замеры, но направление совпадает: меньше ватт — меньше нагрев и шум вентиляторов. Лимит задают в MSI Afterburner или командой nvidia-smi -pl с правами администратора; после перезагрузки он сбрасывается. Для игр лимит лучше вернуть: там вычисления как раз решают.
Риск оплавления разъёма 12V-2×6 у карт RTX 50
По сводке VideoCardz, которую 14 ноября 2026 года пересказал iXBT, за первые две недели ноября появилось больше 10 новых случаев оплавления кабелей и 16-контактных разъёмов 12V-2×6. Среди пострадавших не только RTX 5090 D и RTX 4090, но и RTX 5080, RTX 5070 Ti и RTX 5070 с её 250 Вт. Причину по каждому случаю установить нельзя, а сколько случаев осталось незамеченными — неизвестно. Что на практике снижает риск:
- вставлять разъём до щелчка, без зазора между вилкой и гнездом;
- не перегибать кабель сразу у разъёма карты;
- использовать родной кабель блока питания, а не цепочку переходников.
Как устроен этот разъём и почему он плавится, мы разбирали в статье про разъём 12V-2×6 на RTX 5090.
Б/у RTX 3090 24 ГБ для игр и ИИ: уже не бюджетный компромисс
Б/у RTX 3090 привыкли советовать как самый дешёвый путь к 24 ГБ видеопамяти. На 15 ноября 2026 года дешёвым его не назовёшь: в играх карта идёт на уровне RTX 5070, а стоит как новая RTX 5070 Ti.Параметр б/у RTX 3090 RTX 5070 Ti RTX 5070 VRAM 24 ГБ GDDR6X 16 ГБ GDDR7 12 ГБ GDDR7 fps 1440p / 4K (Tom’s Hardware) 91,5 / 53,1 116,8 / 68,6 96,4 / 54,3 Мощность карты 350 Вт 300 Вт 250 Вт Цена в Украине, 15.11.2026 55 000–79 999 ₴ (OLX, рабочие) от 70 839 ₴ (Hotline) от 46 535 ₴ (Hotline) Цена в США ≈ $1 300 (Jawa, 5 ноября) $1 339,99 (самая дешёвая, 6 ноября) н/д
На моделях до 16 ГБ RTX 3090 и RTX 5070 Ti генерируют почти одинаково, и свои 24 ГБ старая карта отрабатывает только на 32B без игры или 14B рядом с игрой (сравнение по токенам — в материале о выборе видеокарты для локального ИИ). В играх она уступает RTX 5070 Ti около 22 % (наш расчёт по 1440p) и потребляет на 50 Вт больше.
На первой странице выдачи OLX 15 ноября 2026 года большинство рабочих карт стоит 55–80 тыс. ₴, типично 60–70 тыс. ₴, новая в коробке — 88 000 ₴. Это выборка одной площадки на одну дату, а не рыночная статистика. По нашему срезу OLX на 25 октября 2026 года рабочие карты стоили 25–50 тыс. ₴. В США, по данным Jawa, цена за три месяца выросла примерно на 30 % — до $1 300 на 5 ноября, почти до стартовых $1 499.
Риски б/у RTX 3090: что проверить перед покупкой
Экономия на б/у карте почти исчезла, а риски остались прежними:
- Нет гарантии. Новая RTX 5070 Ti за те же деньги приходит с гарантией магазина.
- Неизвестная история. Карта могла годами работать круглосуточно — на майнинге или под той же LLM.
- Подозрительно низкие цены. На OLX есть объявления за 16 500–35 000 ₴. При рыночных 55–80 тыс. ₴ это повод насторожиться.
- Нерабочие карты. Карты «под ремонт» продают за 8 500–15 000 ₴ — описание объявления читайте до конца.
- Проверка. Берите карту только после запуска под нагрузкой и с контролем температуры памяти.
Вывод по цифрам: б/у RTX 3090 оправдана, если вам действительно нужны 24 ГБ. Если ваши модели помещаются в 16 ГБ, за те же деньги новая RTX 5070 Ti быстрее в играх, равна в генерации и приходит с гарантией.
Брать сейчас или ждать: цены 15 ноября и судьба RTX 50 Super
Видеокарты в ноябре 2026 года стоят заметно выше рекомендованных цен: по данным Tom’s Hardware на 3 ноября, из-за огромных заказов памяти для дата-центров ИИ. О пересмотре MSRP ни NVIDIA, ни AMD не заявляли (Digital Citizen, 4 октября).
Методики цен разные, мы их не усредняем: в США — самая дешёвая карта или медиана по магазинам с датой, в Украине — минимальная цена «от» на Hotline.ua по нашему запросу 15 ноября 2026 года.Карта MSRP США: цена, дата, метод Украина: Hotline «от», 15.11.2026 США к MSRP (наш расчёт) Intel Arc B580 $249 $329 (Tom’s Hardware, 3 ноября) 23 895 ₴ ×1,32 RX 9060 XT 16 ГБ $349 н/д 34 685 ₴ н/д RTX 5060 Ti 16 ГБ $429 $819,99 (медиана, 10 ноября) 40 364 ₴ ×1,91 RTX 5070 $549 н/д 46 535 ₴ н/д RX 9070 XT $599 $919 (Tom’s Hardware, 3 ноября) 48 171 ₴ ×1,53 RTX 5070 Ti $749 $1 339,99 (самая дешёвая, 6 ноября) 70 839 ₴ ×1,79 RTX 5080 $999 н/д ≈ 94 500 ₴ н/д RTX 5090 $1 999 от $6 249,99 (Newegg, 14 ноября) 399 999 ₴ ×3,13
Подробнее о рынке США и выборе на фоне дефицита — в гайде о том, какую видеокарту купить, пока RTX 5090 у перекупщиков.
Что известно о RTX 50 Super на 15 ноября 2026 года:
- Серия на полках так и не появилась; в феврале 2026 года The Information сообщало, что её отложили из-за нехватки памяти без нового срока.
- 12 ноября 2026 года TechPowerUp со ссылкой на Board Channels написал, что NVIDIA предупредила партнёров об отмене RTX 5080 на 24 ГБ, которую ждали в январе 2027 года. Версия на 16 ГБ остаётся.
- NVIDIA эти сообщения не подтверждала и не опровергала — это слухи из цепочки поставок.
От Super ждали прежде всего 24 ГБ у новой карты с гарантией, а на 15 ноября об отмене сообщали именно для RTX 5080 на 24 ГБ. Если нынешняя карта справляется, отложить покупку можно, но снижения цен в дефицит памяти не обещает ни один из источников. Если карта нужна сейчас — ориентир по-прежнему 16 ГБ в своём бюджете.
Три бюджета на видеокарту для игр и ИИ: чем жертвует каждый
Бюджет — это цена самой видеокарты на Hotline на 15 ноября 2026 года; процессор и память подбираются как для обычного игрового ПК. Fps и токены — в таблице тиров выше, здесь — что вы получаете и чем платите.
Вход за 35–41 тыс. ₴: RTX 5060 Ti 16 ГБ или RX 9060 XT 16 ГБ
- Что получаете: 16 ГБ памяти за наименьшие деньги и около 70 fps в 1440p на Ultra (73,4 у RTX 5060 Ti, 67,3 у RX 9060 XT).
- Какие модели: в одиночку — до gpt-oss 20B, рядом с игрой — модель 8B впритык.
- Чем жертвуете: 4K на Ultra (40,2 fps у RTX 5060 Ti), тяжёлой трассировкой лучей и моделями крупнее 20B. FLUX на 16 ГБ идёт с подгрузкой весов по частям: 37,02 с на кадр у RTX 5060 Ti.
- Блок питания: 600 Вт для RTX 5060 Ti, 450 Вт для RX 9060 XT.
- Между ними: RX 9060 XT дешевле на 5 679 ₴, RTX 5060 Ti быстрее в генерации на 28 % и работает с CUDA (наш расчёт).
Баланс за 48–71 тыс. ₴: RX 9070 XT или RTX 5070 Ti
- Что получаете: 1440p выше 110 fps и уверенный 4K, в генерации — в 1,5–2 раза быстрее входного уровня.
- Какие модели: те же, что на входе, потолок памяти тот же — 16 ГБ.
- Чем жертвуете: у RX 9070 XT — скоростью генерации и ROCm на Windows. У RTX 5070 Ti — деньгами: она на 22 668 ₴ (47 %) дороже RX 9070 XT.
- Блок питания: 750 Вт для обеих карт.
- Между ними: за 47 % доплаты RTX 5070 Ti даёт примерно 30 % к генерации и CUDA при равных fps. ИИ как эксперимент на выходные — хватит RX 9070 XT, работа с моделями каждый день — доплата окупается временем.
Запас VRAM: б/у RTX 3090 за 55–80 тыс. ₴ или RTX 5090
- Что получаете: у RTX 3090 — 24 ГБ, модель 14B рядом с игрой или 32B в одиночку. У RTX 5090 — 32 ГБ и самые высокие fps из всех карт статьи.
- Чем жертвуете: с RTX 3090 — гарантией и игровой скоростью уровня RTX 5070. С RTX 5090 — деньгами: от 399 999 ₴, примерно в 5,6 раза дороже RTX 5070 Ti (наш расчёт). Это уже не компромисс, а флагман.
- Блок питания: 750 Вт для RTX 3090, 1000 Вт для RTX 5090.
- Почему здесь нет RTX 5080: она стоит от 94 500 ₴ — на 33 % дороже RTX 5070 Ti, — а даёт около 10 % fps в 1440p и около 3 % к генерации (наш расчёт). Память те же 16 ГБ, потолок моделей не меняется.
Итоговая таблица: какая видеокарта закрывает игры и ИИ по бюджету
Игры и локальный ИИ на одной карте закрывают модели с 16 ГБ: RX 9060 XT и RTX 5060 Ti на входе, RX 9070 XT и RTX 5070 Ti в балансе. Б/у RTX 3090 нужна, только если ваши модели не помещаются в 16 ГБ. Карты на 12 ГБ хороши для игр, но не для игры и модели одновременно. Ниже — сколько fps и токенов в секунду даёт каждая тысяча гривен.Карта Hotline «от», 15.11.2026 VRAM fps 1440p на 1000 ₴ ток/с (7B) на 1000 ₴ Кому подходит Intel Arc B580 23 895 ₴ 12 ГБ 2,12 2,94 (Vulkan) недорогие игры и маленькие модели по очереди RX 9060 XT 16 ГБ 34 685 ₴ 16 ГБ 1,94 2,05 (Vulkan) самый дешёвый вход в 16 ГБ RTX 5060 Ti 16 ГБ 40 364 ₴ 16 ГБ 1,82 2,25 (CUDA) вход в 16 ГБ с CUDA RTX 5070 46 535 ₴ 12 ГБ 2,07 н/д игры без ИИ рядом RX 9070 XT 48 171 ₴ 16 ГБ 2,42 2,83 (Vulkan) больше всего fps за гривну в 16 ГБ RTX 5070 Ti 70 839 ₴ 16 ГБ 1,65 2,50 (CUDA) ежедневная работа с моделями и игры в 4K RTX 5080 ≈ 94 500 ₴ 16 ГБ 1,36 1,93 (CUDA) двойному сценарию переплата без пользы RTX 3090 (б/у) ≈ 60 000 ₴ (типично на OLX) 24 ГБ 1,53 2,64 (CUDA) модели 14–32B, если готовы к рискам б/у
«На 1000 ₴» — наш расчёт: fps в 1440p (Tom’s Hardware) и ток/с llama.cpp, делённые на цену в тысячах гривен; у каждой карты — основной бэкенд в скорборде, на одинаковом Vulkan разницы между RX 9070 XT и RTX 5070 Ti почти нет. Для RTX 3090 — условные 60 000 ₴, типичная цена по выборке OLX.
Короткий алгоритм: выберите самую большую модель рядом с игрой (8B — 16 ГБ, 14B — 24 ГБ, 32B — 32 ГБ), затем вендора (NVIDIA — скорость и софт, AMD — цена за fps), и только потом класс карты под своё разрешение.
FAQ
Можно ли играть, пока в видеопамяти загружена локальная LLM?
Можно, если игре и модели вместе хватает памяти. На 16 ГБ тяжёлая игра в 1440p (10,4–12,0 ГБ по замерам PC Gamer) уживается с моделью 8B в кванте Q4 (4,92 ГБ) только впритык. Если памяти мало, система уводит часть данных игры в общую оперативную память, и появляются фризы. Надёжнее выгрузить модель перед запуском игры.
Хватит ли 16 ГБ видеопамяти для игр в 1440p и модели одновременно?
Хватит для модели 8B, без запаса: по нашему расчёту игра в 1440p вместе с Llama 3.1 8B в кванте Q4_K_M занимает 15,3–16,9 ГБ, плюс память под контекст. Модель 14B (9,00 ГБ) рядом с игрой в 16 ГБ уже не помещается — для неё нужно 24 ГБ. Без игры на 16 ГБ работают модели до gpt-oss 20B.
Как выгрузить модель из видеопамяти перед игрой в Ollama и LM Studio?
В Ollama выполните ollama stop <имя модели> — модель выгрузится сразу; без этого она держится в памяти 5 минут после последнего запроса. В LM Studio модель, загруженная вручную или командой lms load, остаётся в памяти, пока вы её не выгрузите кнопкой Eject или командой lms unload --all. Автовыгрузка через 60 минут касается только моделей, подгруженных через API.
Нужна ли карта NVIDIA, если я хочу и играть, и запускать ИИ?
Не обязательно, но с NVIDIA проще. В играх RX 9070 XT и RTX 5070 Ti равны, а в llama.cpp RTX 5070 Ti через CUDA генерирует текст примерно на 30 % быстрее, чем RX 9070 XT. На Windows карты RX 9000 работают в Ollama через Vulkan, на Linux — через ROCm. Если вас это устраивает, AMD даёт те же 16 ГБ дешевле.
Стоит ли брать б/у RTX 3090 вместо новой RTX 5070 Ti?
Только если вам нужны 24 ГБ — модель 14B рядом с игрой или 32B в одиночку. На 15 ноября 2026 года рабочая RTX 3090 на OLX стоит 55–80 тыс. ₴, почти как новая RTX 5070 Ti от 70 839 ₴. При этом RTX 5070 Ti быстрее в играх, равна в генерации на моделях до 20B и продаётся с гарантией.
Можно ли запускать LLM на процессоре, а играть на видеокарте?
Можно, но только с маленькими моделями и без требований к скорости. Даже частичный вынос модели в оперативную память резко замедляет её: Llama 3.3 70B с 15 из 80 слоёв в RAM выдаёт 3,4 ток/с против 52,8 ток/с целиком на RTX 5090. Для 70B с выносом на процессор типичны 2–5 ток/с — для живого диалога это слишком медленно.
Хватит ли 16 ГБ видеопамяти для генерации картинок FLUX?
Хватит, но с компромиссом. Файл FLUX.1-dev в формате fp8 весит 17,2 ГБ, поэтому на карте с 16 ГБ ComfyUI подгружает веса по частям: RTX 5060 Ti 16 ГБ тратит 37,02 с на кадр 1024×1024. RTX 3090 с 24 ГБ держит модель целиком и укладывается в 23,23 с. Для SDXL 16 ГБ хватает с запасом — 11,34 с на кадр.