

Коротко (TL;DR)
DeepSeek V4.1 Flash у версії 1017 (вийшла 17 жовтня 2026 року) — відкрита модель на 763,2 млрд параметрів під ліцензією MIT. Оригінальні ваги важать 510 ГБ, і все ж на ПК з 64 ГБ оперативної пам’яті й однією відеокартою на 12 ГБ її можна запустити. Шлях поки один: рушій Strata і стиснені DeepSeek V4.1 Flash GGUF від лабораторії ISTA-DASLab, а розплачуватися за це доводиться диском, швидкістю й частиною якості.
- Коротко (TL;DR)
- Словник
- DeepSeek V4.1 Flash на 64 ГБ RAM і RTX 3060: що запуститься, а що ні
- Чому 763 млрд параметрів ідуть на малій пам’яті: Engram на SSD
- Квантизації DeepSeek V4.1 Flash GGUF: IQ1_M, IQ2_XXS чи IQ2_XS
- Встановлення DeepSeek V4.1 Flash через Strata: команди покроково
- Швидкість DeepSeek V4.1 Flash на RTX 3060 і 5070: 4–11 ток/с
- Чому не llama.cpp, Ollama і DeepInfer: що працює вдома сьогодні
- Якість 2-бітних квантів V4.1 Flash: що втрачено за замірами
- Ризики запуску DeepSeek V4.1 Flash: диск, чужий софт, uncensored-ваги
- Коли простіше API: DeepSeek V4.1 Flash за $0,15 замість 265 ГБ диска
- FAQ
- Що працює станом на 25 жовтня 2026 року: Strata 0.2.5 і 2-бітний набір IQ2_XXS. Потрібні відеокарта NVIDIA RTX 30/40/50 з 12 ГБ, від 40 ГБ RAM і NVMe-диск, на якому вільно близько 265 ГБ.
- Яка швидкість: автор Strata виміряв 4–6 токенів на секунду на RTX 5070 з 64 ГБ RAM і 9–11 ток/с на RTX 3060 з 46 ГБ RAM (таблиця замірів у README Strata). Незалежних замірів поки немає.
- Що не працює: основна гілка llama.cpp, Ollama й LM Studio цю модель локально не запускають. DeepInfer — рушій самої DeepSeek для датацентрових прискорювачів, вдома він не ставиться.
- Чим платите за компроміс: за трьома бенчмарками ISTA 2-бітний квант дорівнює оригіналу, але perplexity у нього на 15,5% вища. На картах до 16 ГБ Strata за замовчуванням задіює 5 експертів із 6.
- Що не підтверджено: допис про «510 ГБ оригінальних ваг на 64 ГБ RAM і RTX 3060 за 7,4 ток/с» ніхто не відтворив. До цифр статті він не входить.
- Коли простіше хмара: API DeepSeek коштує $0,15 за мільйон вхідних і $0,60 за мільйон вихідних токенів поза піковими годинами (тариф на 25 жовтня 2026 року).
Словник
- MoE (суміш експертів) — модель із безлічі невеликих підмереж-«експертів», з яких на кожне слово працюють лише кілька. Зберігати доводиться всі, обчислювати — малу частину.
- Квантизація і bpw — стискання ваг до меншої кількості біт. 2.00 bpw означає в середньому 2 біти на вагу замість 4–8 в оригіналі DeepSeek V4.1 Flash (і 16 у типових відкритих моделей).
- GGUF — формат файлу стисненої моделі, який розуміють llama.cpp і сумісні рушії.
- Engram — таблиці n-грам усередині DeepSeek V4.1: це не обчислення, а довідник, з якого на кожне слово читається кілька рядків.
- Ток/с — токенів на секунду, швидкість видачі відповіді. Токен — шматок слова.
- Perplexity і KL — міри того, наскільки стиснена модель розходиться з оригіналом. Що більше число, то далі від оригіналу.
DeepSeek V4.1 Flash на 64 ГБ RAM і RTX 3060: що запуститься, а що ні
Запуститься 2-бітна версія моделі через Strata. Вона займе 12 ГБ відеопам’яті, всю вільну оперативну пам’ять і близько 257 ГБ на диску, а те, що не вмістилося в пам’ять, рушій читатиме з NVMe під час відповіді. Швидкість — однозначні числа токенів на секунду. Замірів оригінальних 510 ГБ на такому ПК не опубліковано, є лише неперевірений допис на Reddit (про нього нижче).
Модель свіжа. Базова V4.1 Flash вийшла 10 вересня 2026 року з контекстом на 1 млн токенів, а 17 жовтня DeepSeek виклала оновлення 1017, яке сама називає «minor update».
За бенчмарками вендора версія 1017 підняла Terminal-Bench 4.0 з 31,2 до 42,3, а DeepSWE v1.1 — з 74,2 до 77,0. Це цифри DeepSeek на її власних тестових стендах, а не незалежний тест.
Якщо ви користувалися попередньою V4 Flash 0731, врахуйте: V4.1 — інша й помітно важча модель, досвід запуску старої версії сюди не переноситься.
Що ви отримаєте на домашньому ПК з 64 ГБ RAM і однією картою на 12 ГБ:
- Текстовий чат і агентну роботу через OpenAI- та Anthropic-сумісний API на localhost: Claude Code, Codex CLI, OpenCode і власні скрипти.
- Контекст 8192 токени за замовчуванням. Strata перевіряла модель саме на такому розмірі, більший задається прапорцем
--context. Мільйон токенів із картки моделі — це можливість моделі, а не домашнього ПК. - Один запит за раз: паралельних запитів версія Strata 0.2.5 не підтримує.
- Без зображень: модель уміє працювати з картинками, але Strata цей режим поки ігнорує.
Чому тоді у видачі пишуть, що на 64 ГБ модель не запускається? Джерела розійшлися за датами й методикою. ModemGuides 20 жовтня прямо писав, що ПК з 64 ГБ пам’яті або 24 ГБ відеопам’яті її «не запускає взагалі». Unsloth для свого 1-бітного кванта називає поріг у 128 ГБ RAM і більше, а Kingy AI 22 жовтня оцінив варіант «24 ГБ GPU + 64 ГБ RAM» як «ні» — за розмірами файлів, без запуску. Підтримка ISTA-DASLab і Strata, у якій експерти постійно підвантажуються з SSD, з’явилася пізніше, 23–25 жовтня. Unsloth виходить із того, що в RAM і відеопам’ять мають вміститися всі ваги, крім Engram (її він теж тримає на SSD), — без підвантаження експертів із диска. Звідси й різниця в порозі.
Чому 763 млрд параметрів ідуть на малій пам’яті: Engram на SSD
Модель, оригінал якої важить 510 ГБ, у 2-бітній збірці (249 ГБ) працює на 76 ГБ пам’яті (12 ГБ відеокарти плюс 64 ГБ RAM), бо цілком майже ніколи не потрібна. Вона має два «зайві» для оперативної пам’яті шари зберігання: величезну таблицю Engram, яку можна тримати на диску, і сотні експертів, з яких на кожне слово працюють одиниці.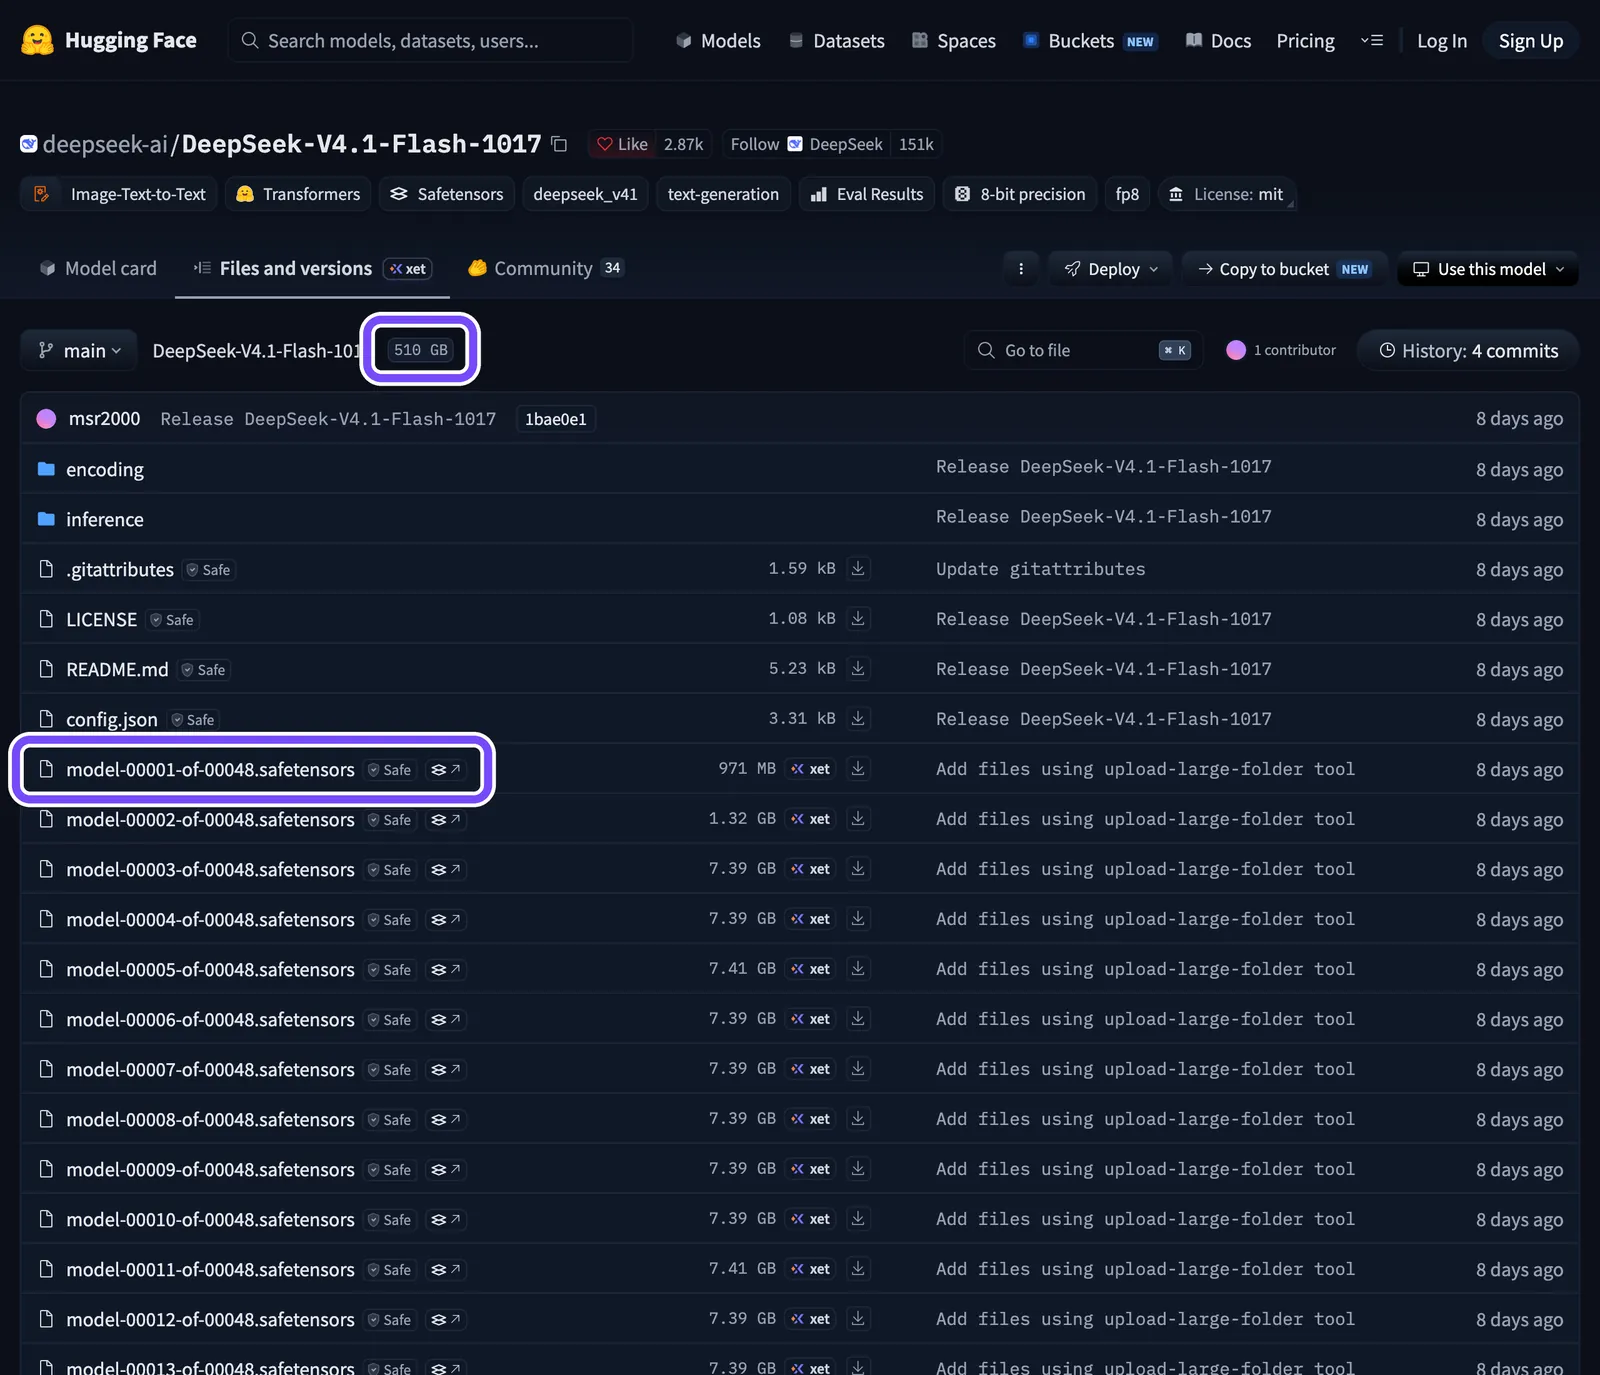
На кадрі — репозиторій deepseek-ai/DeepSeek-V4.1-Flash-1017 на Hugging Face, знятий 25 жовтня 2026 року. Верхня рамка виділяє загальний розмір (510 ГБ), нижня — перший із 48 файлів ваг safetensors. API Hugging Face дає точне значення — 510,3 ГБ. В оригіналі щільні шари зберігаються у FP8, а експерти — у FP4.
З чого складаються параметри і де кожна частина живе під час запуску через Strata:Частина моделі Параметри Розмір у наборі 2.00 bpw Де лежить під час роботи Основа (увага, спільні шари, експерти) 551,9 млрд 138 ГБ відеокарта і RAM, те, що не вмістилося, читається з SSD Таблиці Engram 196,6 млрд 111 ГБ (спільний файл IQ4_NL) SSD, кілька рядків на кожне слово Драфтер DSpark н/д 8 ГБ відеокарта, якщо увімкнений Решта, зокрема блок зору близько 15 млрд (різниця, наш розрахунок) н/д у Strata 0.2.5 не використовується
Дані таблиці — з картки ISTA-DASLab (23 жовтня 2026 року) і документації Strata. Загалом картка налічує 763,2 млрд параметрів; рядок «Решта» — наш розрахунок як різниця від загального числа.
Перший механізм — Engram. Близько чверті параметрів (196,6 млрд із 763,2) — це не ваги для множення матриць, а таблиця пошуку. На кожне слово модель читає з неї кілька рядків. Тому файл можна не завантажувати в RAM, а відобразити з диска (mmap), і він не займе ні відеопам’ять, ні оперативну пам’ять. Зворотний бік у тому, що диск бере участь у генерації кожного токена. Документація Strata попереджає: повільний диск гальмує кожне слово, тримайте файли на NVMe.
Другий механізм — розрідженість експертів. За config.json модель має 40 шарів, у кожному 384 маршрутизовані експерти, і на одне слово працюють 6 із них. Це близько 1,6% експертів шару на токен. Strata тримає у відеопам’яті й RAM стільки експертів, скільки вміститься, починаючи з найзатребуваніших (до пакета кладеться готовий профіль «гарячих» експертів), а решту читає просто з файлів моделі.
Наш грубий розрахунок для набору 2.00 bpw: основа важить 138 ГБ, а пам’яті у вас 76 ГБ, і частину її займають система та кеш контексту. Отже, щонайменше 55–60 ГБ ваг експертів у будь-який момент лишаються на диску й підвантажуються за потреби. Класична формула «модель має вміститися у відеопам’ять» тут не працює: обмеження зміщується з VRAM на швидкість SSD і обсяг RAM під кеш експертів.
Квантизації DeepSeek V4.1 Flash GGUF: IQ1_M, IQ2_XXS чи IQ2_XS
Для домашнього ПК беріть IQ2_XXS (2.00 bpw): ISTA-DASLab називає його рекомендованим і найближчим до базової моделі, а Strata ставить за замовчуванням. IQ1_M на 1.75 bpw потрібен, лише якщо бракує диска або пам’яті. IQ2_XS на 2.25 bpw якісніший, але вимагає близько 280 ГБ вільного місця.
Усі три набори зроблено методами GSQ і RCO: точність розподіляється не однаково на всю модель, а для кожного тензора окремо, за його чутливістю. Докладніше про те, чому якість падає саме нижче 4 біт, — у нашому розборі квантизації локальних LLM.Набір bpw Основа Engram Усього в ISTA Завантаження в Strata Вільно на диску Кому підходить IQ1_M 1.75 120,7 ГБ 110,6 ГБ 231,3 ГБ 239 ГБ близько 245 ГБ диск або RAM на межі IQ2_XXS 2.00 138,2 ГБ 110,6 ГБ 248,8 ГБ 257 ГБ близько 265 ГБ вибір за замовчуванням IQ2_XS 2.25 155,2 ГБ 110,6 ГБ 265,8 ГБ 274 ГБ близько 280 ГБ важливіша якість, є місце
Розміри — з картки GGUF ISTA-DASLab станом на 23 жовтня 2026 року і README Strata на 25 жовтня. Стовпець «Завантаження в Strata» більший за «Усього в ISTA», бо Strata докачує драфтер DSpark на 8 ГБ. Файл Engram у всіх трьох наборів спільний: завантаживши його один раз, можна пробувати різні варіанти основи.
Для порівняння: Unsloth має власну лінійку. Її 1-бітний UD-IQ1_M важить 250,4 ГБ і за тестом Unsloth у 88,2% позицій тексту обирає той самий найімовірніший токен, що й оригінал (top-1, тест long17k). Unsloth розраховує його на системи зі 128 ГБ RAM і більше, а запускати пропонує через свій чорновий PR #30817 до llama.cpp. Це інша лінійка з іншими типами тензорів, зокрема в Engram, тож файли двох лінійок не взаємозамінні.
У спільноті ходять і урізані версії. Наприклад, на r/LocalAIServers автор стиснув uncensored-варіант 1017 до 256 ГБ методом REAP. Такі файли — це вже відредаговані ваги з неперевіреною якістю, до офіційних наборів вони стосунку не мають.
Встановлення DeepSeek V4.1 Flash через Strata: команди покроково
Strata — безплатна програма з відкритим кодом (ліцензія MIT): вона завантажує модель, ставить окремий рушій для DeepSeek і піднімає локальний сервер. Усі команди нижче взято з README Strata станом на 25 жовтня 2026 року, версія 0.2.5. Команди llama.cpp для цих файлів не наводимо: ISTA-DASLab сама позначила їх як «коли з’явиться підтримка».
Крок 1. Перевірте відеокарту, пам’ять і диск
- Відеокарта: NVIDIA RTX 30, 40 або 50 серії (Windows і Linux) чи AMD Radeon AI PRO R9700 (лише Linux). ISTA-DASLab пише, що всі три набори працюють на одній карті з 12 ГБ відеопам’яті.
- Оперативна пам’ять: 64 ГБ — наша рекомендація як комфортний мінімум. За документацією Strata, нижче приблизно 40 ГБ запуск не тестувався й іде повільно; інсталятор про це попередить, але все одно встановить.
- Диск: NVMe-SSD з вільними 265 ГБ під набір 2.00 bpw. Замір на 64 ГБ RAM зроблено з диском на 3,6 ГБ/с.
- Інтернет і час: 257 ГБ на каналі 100 Мбіт/с завантажуються близько 5,7 години, на гігабітному — близько 34 хвилин. Завантаження відновлюється після обриву, а кожен файл звіряється за SHA-256.
Крок 2. Встановіть Strata
Є настільний застосунок (інсталятори для Windows, Linux і Mac на сторінці релізів) і версія для термінала. Для термінала на Linux або Mac:
curl -fsSL https://github.com/Niko1221/Strata/releases/latest/download/install.sh -o install.sh && sh install.sh
На Windows у PowerShell:
irm https://github.com/Niko1221/Strata/releases/latest/download/install.ps1 | iex
На Windows після встановлення відкрийте нове вікно термінала: інакше команда strata може не знайтися. Скрипт з інтернету перед запуском варто відкрити й прочитати — про це докладніше в розділі про ризики.
Крок 3. Перегляньте план розміщення до завантаження
strata launch --family deepseek41 --model ist-das-2.00bpw --plan
Прапорець --plan нічого не завантажує і не змінює. Strata розраховує, скільки експертів вміститься у відеопам’ять і RAM саме вашого ПК, скільки піде на диск і який режим швидкості ви отримаєте. А якщо для вашої відеокарти немає пакета рушія, про це скаже інсталятор — ще до того, як почне завантажувати 257 ГБ.
Крок 4. Запустіть завантаження і модель
strata launch
Майстер проведе крок за кроком: оберіть DeepSeek V4.1 Flash і набір 2.00 bpw. Strata завантажить файли й рушій, запакує модель, перевірить її коротким тестовим запитанням і запустить. Перше завантаження моделі в пам’ять триває кілька хвилин.
У майстрі є крок Speed. «Faster» задіює 5 експертів із 6 і вмикається сам на ПК, де відеопам’яті 16 ГіБ або менше. «Full quality» задіює всі 6. Автор Strata описує втрату якості як «невелику, зазвичай непомітну», але це його оцінка.
Крок 5. Підключіть чат, Claude Code або власний скрипт
strata connect
Команда покаже налаштування для вашого інструмента: Claude Code, Codex CLI, OpenCode, Hermes Agent та інших, що працюють через OpenAI- та Anthropic-сумісний API. Міркування («thinking») у моделі увімкнені за замовчуванням. Для швидких коротких відповідей їх можна вимкнути параметром запиту reasoning_effort: "none". Температура і top_p за замовчуванням — 1.0, як рекомендує DeepSeek.
Типові проблеми:
- Рушій не завантажується (немає доступу до стрічки оновлень або ПК без інтернету). Пакет
strata-dsv41можна завантажити зі сторінки релізів вручну, звірити зSHA256SUMS.txtі передати Strata — так описано в документації. - Відповіді йдуть дуже повільно. Перевірте, що файли моделі лежать на NVMe, а не на SATA-SSD чи HDD: Engram читається на кожному токені.
- Замало оперативної пам’яті. Закрийте браузер і важкі програми: Strata сама вирішує, скільки RAM віддати під кеш експертів, і що більше RAM зайняли інші програми, то більше експертів Strata читатиме з диска.
Швидкість DeepSeek V4.1 Flash на RTX 3060 і 5070: 4–11 ток/с
На ПК з 64 ГБ RAM і картою на 12 ГБ чекайте близько 5 токенів на секунду: це єдиний опублікований замір саме на 64 ГБ (RTX 5070, NVMe 3,6 ГБ/с). Усі заміри Strata зробив автор самого рушія, і ніхто незалежно їх поки не повторив.Конфігурація Рушій і набір Видача Читання промпту Хто міряв RTX 3060 12 ГБ, 46 ГБ RAM Strata 0.2.5, 2.00 bpw 9–11 ток/с (у docs — 8–10) близько 155 ток/с (4K) автор Strata RTX 5070 12 ГБ, 64 ГБ RAM, NVMe 3,6 ГБ/с Strata 0.2.5, 2.00 bpw 4–6 ток/с (у docs — близько 4,7) близько 110 ток/с (4K) автор Strata 1× Radeon AI PRO R9700, 251 ГБ RAM Strata 0.2.5, 2.00 bpw 21–25 ток/с 320–360 ток/с (8K) автор Strata 4× Radeon AI PRO R9700 Strata 0.2.5, 2.00 bpw 74–77 ток/с (у docs — близько 48 на коді) 400–450 ток/с (8K) автор Strata 2× RTX 3090, 128 ГБ RAM dsx (Rust + CUDA), власний квант T16 40+ ток/с н/д автор dsx
Дані — README і документація Strata станом на 25 жовтня 2026 року і репозиторій lxe/dsx на ту саму дату. Для чотирьох R9700 README і документація розходяться найбільше: 74–77 проти приблизно 48 ток/с.
Три застереження, без яких таблицю легко прочитати неправильно:
- RTX 3060 швидша за RTX 5070, хоча стенд із нею має менше оперативної пам’яті (46 проти 64 ГБ). README причини не пояснює. Конфігурації відрізняються не лише картою: диск у стенда з 3060 не вказано, а цифри README і документації всередині одного репозиторію розходяться (9–11 і 8–10 ток/с).
- Режим заміру не названо. На картах до 16 ГіБ Strata за замовчуванням вмикає «Faster» (5 експертів із 6). Найімовірніше, цифри для 3060 і 5070 знято саме в ньому, але джерело цього не уточнює.
- Читання промпту теж забирає час. Зі швидкістю 110 ток/с промпт на 4000 токенів читається близько 36 секунд, і лише потім починається відповідь.
Що це означає на практиці. Відповідь на 1000 токенів зі швидкістю 4,7 ток/с пишеться приблизно 3,5 хвилини. У режимі міркувань модель спершу генерує «думки», і вони теж ідуть по 4–5 токенів на секунду. Для листування в чаті це терпимо, для агента, який робить десятки кроків, — дуже повільно.
Допис про 510 ГБ і 7,4 ток/с: чому це поки не факт
На Reddit (r/LLMDevs) вийшов допис із заголовком про повну модель 1017 на 510 ГБ з оригінальними вагами на ПК з 64 ГБ RAM і RTX 3060: «до 7,4 ток/с, 98,3% збігу з повною моделлю», рушій викладено. Відкрити допис нам не вдалося (Reddit блокував запити), а пошук за цифрами 25 жовтня не знайшов ні повторів, ні розборів. Тому це заява автора допису, яку ніхто незалежно не перевіряв.
Що в ній насторожує, якщо зіставити з опублікованими даними:
- Швидкість. Оригінал більш ніж удвічі важчий за 2-бітний набір (510 ГБ проти 249 ГБ), тож на кожен токен із диска доведеться читати помітно більше, а заявлена швидкість вища, ніж у 2-бітного набору на 64 ГБ RAM (4–6 ток/с). Для набору Unsloth UD-Q8_K_XL на 508 ГБ документація Strata пише коротко: за нестачі пам’яті він «працює, повільно».
- Збіг 98,3%. За тих самих ваг і того самого режиму збіг має бути близьким до 100%: розходитися результат може хіба що через числові відмінності обчислювальних ядер. Розрив в 1,7% радше свідчить про те, що рушій щось спрощує — наприклад, задіює менше експертів на токен, як режим Faster у Strata. Це наша гіпотеза, а не дані автора: на якому наборі текстів і в якому режимі обчислювався збіг, із заголовка не зрозуміти.
Як перевіряти подібні заяви: точний конфіг (RAM, модель і швидкість диска, контекст), режим експертів, на якому наборі текстів обчислювався збіг, чи є команди й логи для повтору і чи повторив хтось результат. Поки на ці запитання немає відповіді, цифра лишається рекламою, а не заміром.
Чому не llama.cpp, Ollama і DeepInfer: що працює вдома сьогодні
Звичні домашні інструменти DeepSeek V4.1 Flash поки не вміють. Станом на 23 жовтня 2026 року ISTA-DASLab прямо пише, що llama.cpp не підтримує DeepSeek-V4.1, а за даними ModemGuides на 20 жовтня нічого не влито ні в llama.cpp, ні в Ollama, ні в LM Studio. Ollama й LM Studio побудовані поверх llama.cpp, тож без підтримки в його основній гілці їм нічого запускати.Рушій Статус для V4.1 Flash Залізо Для дому Strata 0.2.5 запускає набори ISTA і UD-Q8_K_XL (25.10) RTX 30/40/50, R9700 так, єдиний опублікований шлях llama.cpp, основна гілка не підтримує (23.10) — чекати злиття llama.cpp, PR #30817 Unsloth чернетка, власний формат Engram — для експериментів Ollama лише хмарні теги (20.10) — локально ні LM Studio підтримки немає (20.10) — ні DeepInfer офлайн-інференс, лише V4.1 Flash (20.10) NVIDIA SM100, Huawei Ascend 950 ні dsx (спільнота) власний рушій на Rust і CUDA 2× RTX 3090, 128 ГБ RAM для ентузіастів
Статуси рушіїв застарівають раніше за будь-які інші дані цієї статті. Перш ніж чекати чи ставити, перевірте картку ISTA-DASLab і релізи llama.cpp: підтримка в основній гілці одразу відкриє дорогу Ollama й LM Studio.
DeepInfer: рушій для стійок, а не для домашнього ПК
DeepInfer — це високопродуктивний рушій, на якому працюють продакшн-сервіси DeepSeek. Компанія відкрила його 20 жовтня 2026 року під ліцензією Apache 2.0, і на Hacker News обговорення зібрало 2347 очок і 891 коментар. Початково він побудований на vLLM і підтримує рівно одну модель — DeepSeek-V4.1-Flash.
Для дому він не підходить із трьох причин:
- Залізо. Підтримуються лише датацентрові прискорювачі NVIDIA SM100 і Huawei Ascend 950. Ігрових GeForce у списку немає.
- Масштаб. Опубліковані бенчмарки знято на 4 GPU для обробки промпту і 64 GPU для генерації. Це стійка, а не робоча станція.
- Комплектація. У відкритій версії немає системи KV-кешу, розділення prefill і decode та балансувальника навантаження — усього, що потрібно для повноцінного сервісу. Вимоги: Linux, CUDA 13, Python 3.12.
Користь DeepInfer інша: з коду видно, як DeepSeek побудувала свій продакшн, і провайдери зможуть обслуговувати модель так само ефективно, як сама DeepSeek. Його варто читати, а не ставити. Тон обговорення на HN такий самий: у коментарях його називають інструментом для провайдерів, а не для домашнього заліза.
Якість 2-бітних квантів V4.1 Flash: що втрачено за замірами
Два джерела дають дві різні картини, і обидві правильні. ISTA-DASLab пише, що IQ2_XXS зберігає 100% якості базової моделі. Strata виміряла в того самого набору perplexity на 15,5% вищу за оригінал. Суперечності немає: вони міряють різне.Набір Recovery в ISTA (3 бенчмарки) KL у Strata Perplexity у Strata Код Агентні завдання Інше IQ1_M, 1.75 bpw 98,7% 0,217 +21% +8,9% +10,2% проза англійською +53%, багатомовні тексти +14% IQ2_XXS, 2.00 bpw 100,0% 0,170 +15,5% +8,6% +5,3% н/д IQ2_XS, 2.25 bpw н/д (ISTA не публікує) 0,107 +7,3% +3,2% +2,2% н/д
Дані — картка ISTA-DASLab (23 жовтня 2026 року) і документація Strata (25 жовтня, 4995 позицій тексту).
Чому 100% і +15,5% сумісні. Recovery в ISTA — це середнє за трьома завданнями (AIME25, GPQA-Diamond і LiveCodeBench v6) за reasoning effort 50: олімпіадна математика, наукові запитання і код. Модель із 2-бітними вагами розв’язує їх так само, як оригінал. Perplexity і KL у Strata показують, наскільки розподіл імовірностей слів відрізняється від оригіналу на кожній позиції тексту. Відповідь на завдання може збігтися, навіть якщо шлях до неї і формулювання змістилися.
Що з цього випливає для практики:
- Для коду й агентів 2-бітний набір втрачає найменше: +8,6% і +5,3% за perplexity.
- Для текстів не англійською чекайте більших втрат: в IQ1_M багатомовні тексти гірші на 14%, а англійська проза — на 53%. Для IQ2_XXS окремої цифри за мовами немає.
- Режим Faster (5 експертів із 6) додає до цього ще трохи втрат. Замірів цієї різниці Strata не публікує.
Обидві оцінки зроблено в одній екосистемі: ISTA-DASLab оптимізувала набори разом зі Strata, і проєкти посилаються один на одного. Це не означає, що цифрам не можна вірити, але незалежної перевірки поки немає.
Ризики запуску DeepSeek V4.1 Flash: диск, чужий софт, uncensored-ваги
- Молодий софт, по суті проєкт одного автора. Strata створена 24 вересня 2026 року, і майже всі коміти (3183 станом на 25 жовтня 2026 року) — від власника репозиторію, решта учасників внесли по кілька десятків правок. Рушій для DeepSeek (
strata-dsv41, портований із MIT-проєкту Project Maya) ставиться готовим бінарним пакетом із підписаної стрічки оновлень. Strata перевіряє підпис і хеші кожного файлу, але довіряєте ви зрештою автору. Скрипт встановлення перед запуском варто прочитати. - Швидкість і диск. Заміри з розділу про швидкість закладайте із запасом, особливо якщо диск повільніший за 3,6 ГБ/с. Щоб тримати на диску всі три набори одночасно, потрібно 533 ГБ.
- Втрата якості найбільше б’є по довгих текстах природною мовою, менше — по коду (цифри — у розділі про якість).
- Відредаговані ваги. За даними ModemGuides на 20 жовтня, чимало завантажень 1017 на Hugging Face — abliterated- та uncensored-версії, тобто ваги змінено. Їхні автори повідомляють про малу втрату якості, але незалежно її ніхто не міряв. Разом із моделями спільнота роздає Docker-образи й завантажувачі з виконуваним кодом — запускайте лише те, що прочитали.
- Обмеження DeepSeek у США. 21 жовтня 2026 року на HN обговорювали наказ DHS, що виключає DeepSeek із федеральних цивільних відомств США. Для читача з України це не заборона. Але якщо ви працюєте на американського замовника з такими вимогами, це варто врахувати, хоча локальний запуск нікуди дані не надсилає.
- Швидке застарівання. Підтримка в llama.cpp, нові версії Strata й оновлення моделі можуть змінити картину за тижні. Що застаріє першим — статуси рушіїв і заміри швидкості.
Коли простіше API: DeepSeek V4.1 Flash за $0,15 замість 265 ГБ диска
Якщо вам не потрібні приватність чи робота без інтернету, API майже завжди дешевший і швидший. За тарифом DeepSeek на 25 жовтня 2026 року модель deepseek-flash (це і є V4.1-Flash-1017) коштує $0,15 за 1 млн вхідних токенів без кешу і $0,60 за 1 млн вихідних поза піковими годинами. У пік ціни вдвічі вищі: $0,30 і $1,20. Пікові години — з 01:00 до 04:00 і з 06:00 до 10:00 UTC у будні.
Порівняймо на однаковому обсязі роботи. Локальну швидкість узято із заміру на RTX 5070 з 64 ГБ RAM: близько 4,7 ток/с на видачі і 110 ток/с на читанні промпту.Обсяг Локально (RTX 5070, 64 ГБ RAM) API поза піком 1 млн вихідних токенів близько 59 годин генерації $0,60 1 млн вхідних токенів близько 2,5 години читання промпту $0,15 Підготовка 257 ГБ завантаження: 5,7 год на 100 Мбіт/с, 34 хв на 1 Гбіт/с реєстрація і ключ Контекст 8192 токени за замовчуванням до 1 млн токенів Зображення й паралельні запити ні є
Розрахунок наш: час = обсяг ÷ швидкість. До локальної колонки не входить електрика за 59 годин роботи ПК під навантаженням — сума залежить від тарифу й заліза.
Коли локальний запуск виправданий:
- Приватність. Код чи документи, які не можна надсилати на чужий сервер.
- Робота без інтернету після того, як модель завантажено.
- Експерименти: розібратися, як влаштовані MoE і Engram, перевірити кванти, підключити свого агента без лімітів API.
Коли краще хмара: вам важлива швидкість, потрібні довгий контекст чи зображення, а залізо доведеться докуповувати. Якщо вдома потрібна саме модель DeepSeek, але 265 ГБ диска шкода, подивіться на дистиляти DeepSeek-R1 — вони йдуть на одній відеокарті без підвантаження з диска. А чи можна вдома запустити старшу DeepSeek V4 Pro, розібрано в тому самому огляді, де ми описували DSpark.
FAQ
Скільки оперативної пам’яті потрібно для DeepSeek V4.1 Flash?
З рушієм Strata і 2-бітним набором ISTA-DASLab — від 40 ГБ RAM: нижче цього порогу запуск, за документацією Strata, не тестувався й іде повільно. 64 ГБ — розумний мінімум, на ньому автор рушія виміряв 4–6 ток/с. Unsloth для свого 1-бітного кванта через llama.cpp називає 128 ГБ і більше: там інша методика, без постійного підвантаження експертів з SSD.
Що таке DeepInfer і чи можна запустити його на домашньому ПК?
DeepInfer — рушій, на якому працюють продакшн-сервіси DeepSeek. Його відкрили 20 жовтня 2026 року під ліцензією Apache 2.0. На домашньому ПК він не запуститься: підтримує лише датацентрові прискорювачі NVIDIA SM100 і Huawei Ascend 950, а бенчмарки знято на 4 і 64 GPU. Для дому потрібна Strata, DeepInfer корисний як відкритий код продакшн-інференсу.
Чи є DeepSeek V4.1 Flash в Ollama і LM Studio?
Станом на 25 жовтня 2026 року — ні. За даними ModemGuides на 20 жовтня, в Ollama є лише хмарні теги цієї моделі, а в LM Studio підтримки немає взагалі. Обидва інструменти побудовані на llama.cpp, а його основна гілка DeepSeek-V4.1 не підтримує (ISTA-DASLab, 23 жовтня). Коли підтримку вліють у llama.cpp, Ollama й LM Studio, найімовірніше, підтягнуться слідом.
Чи вмістяться 510 ГБ оригінальних ваг DeepSeek V4.1 Flash у 64 ГБ RAM?
Ні, цілком 510 ГБ у 64 ГБ RAM не вміщаються: запустити їх можна лише з постійним читанням експертів і таблиць Engram з SSD. Найближчий задокументований випадок — набір Unsloth UD-Q8_K_XL на 508 ГБ: для ПК з нестачею пам’яті документація Strata пише «працює, повільно», без цифр швидкості. Допис на Reddit про 7,4 ток/с поки ніхто не відтворив.
Чи можна запустити DeepSeek V4.1 Flash на RTX 3060 без SSD?
Практично ні. Таблиця Engram на 111 ГБ читається з диска на кожному токені, а частина експертів за 64 ГБ RAM теж підвантажується з накопичувача. На HDD кожне слово чекатиме диска. Strata прямо радить тримати файли моделі на NVMe: опублікований замір на 64 ГБ RAM зроблено з диском на 3,6 ГБ/с, і навіть на ньому швидкість — 4–6 ток/с.