Qwen 3.6 35B-A3B коротко: вердикт, пам’ять і швидкість
Qwen 3.6 35B-A3B — відкрита MoE-модель Alibaba, яку виклали у квітні 2026 року під ліцензією Apache 2.0. Головне, що про неї треба знати до завантаження: обчислює вона як маленька модель на 3 млрд параметрів, а зберігає в пам’яті всі 35 млрд. Тому питання «чи потягне моє залізо» тут зводиться не до потужності, а до обсягу пам’яті.
- Qwen 3.6 35B-A3B коротко: вердикт, пам’ять і швидкість
- Що таке Qwen 3.6 35B-A3B і чим MoE відрізняється від звичайної моделі
- Версії, розміри й ліцензія Qwen 3.6: що завантажувати
- Бенчмарки Qwen 3.6 35B-A3B: цифри Alibaba і незалежні перевірки
- Скільки пам’яті потрібно MoE-моделі на 35B: вага файлу за квантами
- Як запустити Qwen 3.6 вдома: Ollama, LM Studio, llama.cpp і MLX
- Швидкість генерації на RTX і Apple M: заміри та оцінки
- Чому MoE швидка на Mac і слабкій карті: розрахунок за пам’яттю
- Qwen 3.6 35B-A3B проти Qwen 3.8 27B, gpt-oss-20b і Gemma 4
- Коли Qwen 3.6 35B-A3B не підійде: петлі, інструменти, мова
- Яку збірку Qwen 3.6 вибрати: код, агент, ноутбук, слабка карта
- FAQ
Самі ми модель не запускали. Цифри швидкості нижче — заміри інших людей, у кожного вказано джерело, метод і дату. Де заміру немає, стоїть оцінка за відкритою формулою, і її так і підписано.
- Що це. Модель із «сумішшю експертів» (MoE): 35 млрд параметрів загалом, з них на кожен токен працюють близько 3 млрд. Розуміє текст, зображення й відео, контекст — 262 144 токени.
- Пам’ять. 4-бітний файл важить 21,2–24 ГБ залежно від збірки. Відеокарті на 24 ГБ вистачає впритул, Mac потрібен від 32 ГБ. Mac на 24 ГБ 4-бітну версію за замовчуванням не тягне: відеоядру macOS віддає близько 3/4 пам’яті, це приблизно 19,3 ГБ, а модель на піку займає 18,3–19,3 ГБ уже на короткому запиті — місця під контекст не лишається.
- Швидкість за чужими замірами. RTX 5090 — 183 токени за секунду (Zenn, UD-Q4_K_M, llama.cpp b8870, 22.04.2026), RTX 3090 — 158, Mac на M4 Max — 109–121, на M4 Pro — 86. RTX 3060 на 12 ГБ видає 38–47 токенів за секунду, якщо частину моделі тримати в оперативній пам’яті.
- Якість. У незалежному індексі Artificial Analysis у неї 18 балів, у щільної Qwen3.8-27B — 34. За даними самої Alibaba щільна Qwen3.6-27B сильніша в усіх основних тестах. Зате MoE-версія у 3–5 разів швидша.
- Кому брати. Тим, кому потрібна швидка локальна модель для чату, коду й простих агентів на відеокарті 24–32 ГБ, на Mac від 32 ГБ або навіть на 12-гігабайтній карті. Кому якість відповіді важливіша за швидкість — щільна Qwen 3.8 27B.
| Qwen 3.6 35B-A3B | Qwen 3.8 27B | gpt-oss-20b | |
|---|---|---|---|
| Будова | MoE, активних 3B із 35B | щільна, 27B | MoE, активних 3,6B із 21B |
| Індекс Artificial Analysis v4.3.2 | 18 | 34 | н/д |
| Швидкість через API (Artificial Analysis) | 131 ток/с | 44 ток/с | н/д |
| RTX 3090, llama-bench | 157,7 ток/с | н/д | 161,8 ток/с |
| Ліцензія | Apache 2.0 | Apache 2.0 | Apache 2.0 |
Що таке Qwen 3.6 35B-A3B і чим MoE відрізняється від звичайної моделі
Qwen 3.6 35B-A3B — перша модель покоління Qwen 3.6 з відкритими вагами: файли моделі можна завантажити й запустити в себе, а не лише звертатися до неї через чужий сервер. Так її називає сама Alibaba в картці моделі на Hugging Face. Попереднє покоління Qwen 3.5 вийшло в лютому 2026-го, а як розвивалася лінійка Qwen для локального запуску до цього, ми розбирали окремо.
Назва читається так: 35B — 35 млрд параметрів (точніше, 35 951 822 704 за даними Hugging Face API), A3B — близько 3 млрд активних параметрів на кожен токен. Токен — шматочок слова, з яких модель збирає відповідь.

MoE (Mixture of Experts, «суміш експертів») — будова, за якої модель складається з багатьох невеликих блоків-«експертів», і на кожен токен вмикається лише кілька з них. Зручна аналогія — клініка з 256 вузькими фахівцями. На кожен токен диспетчер (роутер) кличе 8 профільних лікарів і одного терапевта загального профілю, решта 247 у цей момент не працюють. У звичайній, щільній моделі на кожен токен працюють усі параметри одночасно.
Що ще вказано в картці:
- 40 шарів, у кожному — блок із 256 експертів, з яких активні 8 маршрутизованих і 1 спільний.
- Гібридна увага. Три шари з чотирьох використовують Gated DeltaNet — спрощену «лінійну» увагу, дешевшу на довгому тексті. Кожен четвертий шар — звичайна увага (Gated Attention). Схема: 10 × (3 × Gated DeltaNet → 1 × Gated Attention).
- Зір. Це мовна модель з енкодером зображень: вона читає картинки, скани документів і відео. За даними Alibaba, у VideoMMMU в неї 83,7.
- Режим міркування ввімкнений за замовчуванням: перед відповіддю модель пише чернеткові міркування. Його вимикають параметром
enable_thinking: False.
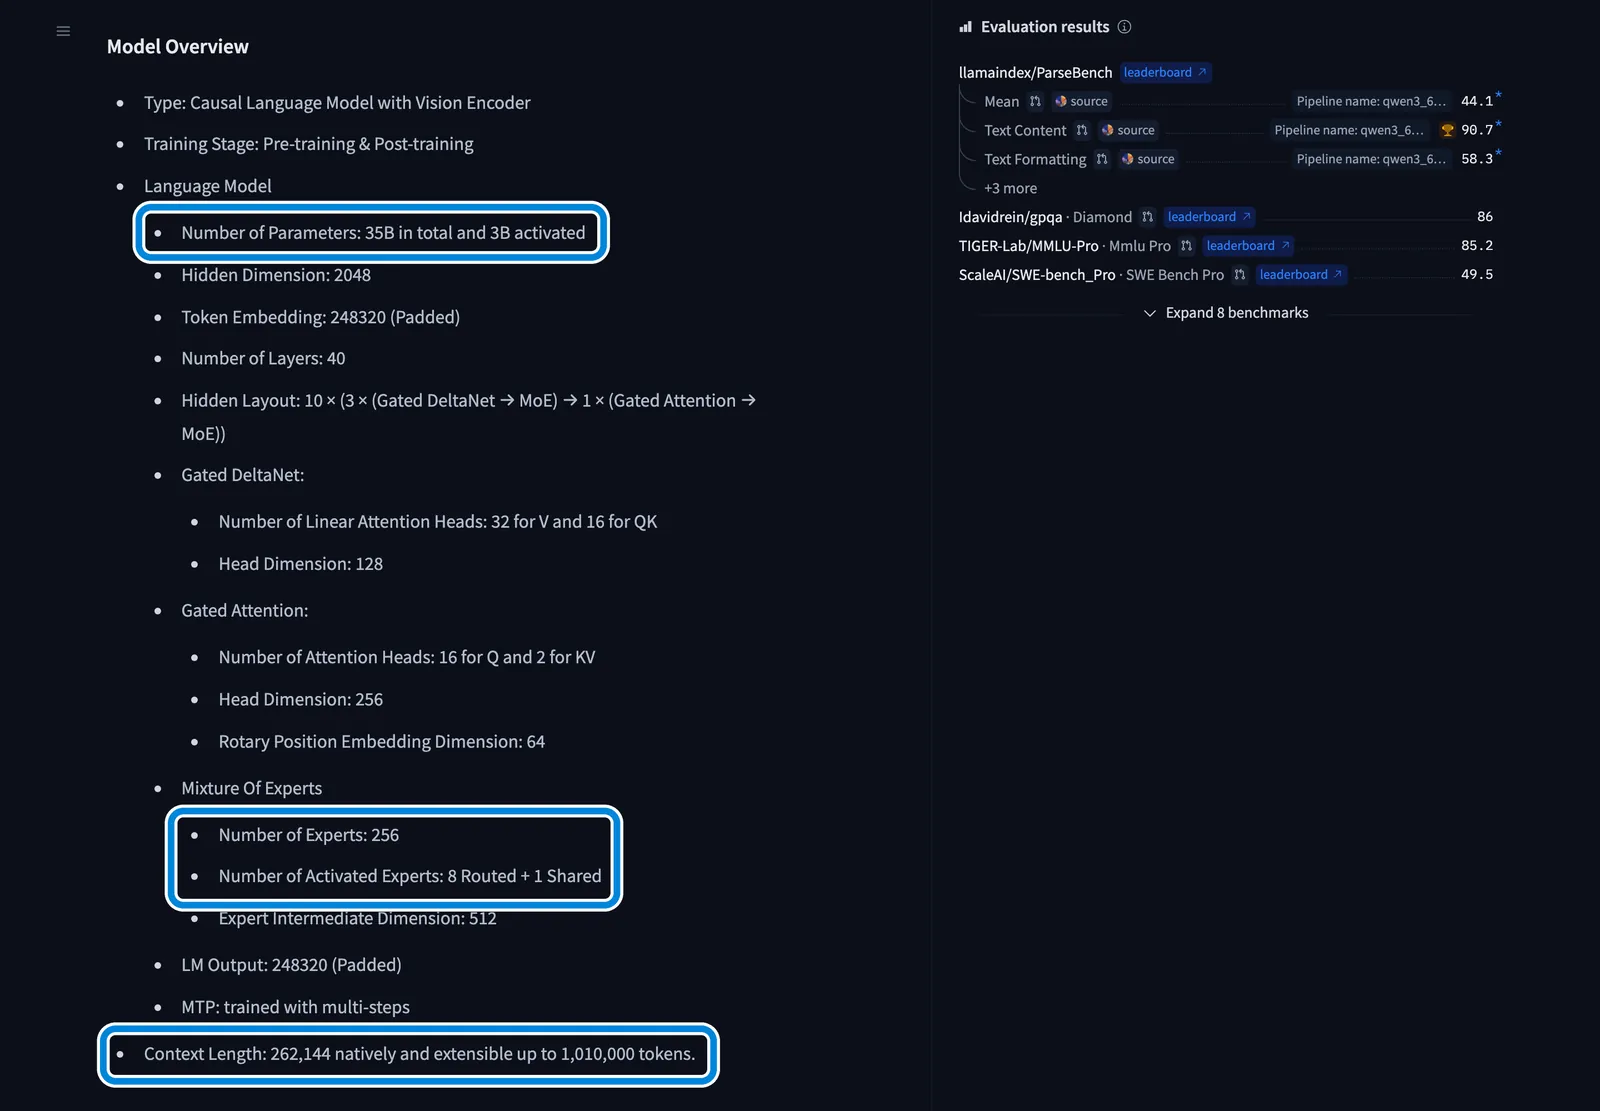
Скриншот картки моделі знято 25.10.2026. Рамки показують три рядки, на яких тримається весь цей розбір: 35B параметрів загалом і 3B активних, 256 експертів (8 + 1 активні) та нативний контекст 262 144 токени з розтягненням до 1 010 000.
З цієї будови випливають два висновки, які пояснюють майже все далі. Обчислень на токен стільки ж, скільки в моделі на 3B, тому вона швидка. А пам’яті потрібно стільки ж, скільки моделі на 35B: наступний токен може покликати будь-яких експертів, і всі вони мають лежати в пам’яті заздалегідь.
Більшість сторінок, які пошук видає за запитом «Qwen 3.6 35B A3B review», — агрегатори зі специфікаціями й цінами API. Замірів на домашньому залізі та відповіді на питання «кому її брати» там немає. Саме на ці два питання відповідають розділи нижче.
Версії, розміри й ліцензія Qwen 3.6: що завантажувати
Сама Alibaba викладає ваги у вихідному форматі BF16 — 16 біт на число, близько 70 ГБ. Удома їх майже ніхто не завантажує: спільнота одразу випускає стиснені збірки. Формат GGUF — файл для llama.cpp і програм на його основі (Ollama, LM Studio), у якому модель уже квантована, тобто стиснута до 2–8 біт на число. Готові GGUF-збірки Qwen 3.6 35B A3B є в Unsloth, у LM Studio Community і в бібліотеці Ollama.Варіант Що це Де взяти Вага Qwen3.6-35B-A3B, BF16 вихідні ваги від Alibaba Hugging Face, Qwen ≈70 ГБ GGUF Unsloth (UD-Q3…UD-Q6) стиснені збірки для llama.cpp і LM Studio Hugging Face, unsloth 16,6–29,3 ГБ GGUF LM Studio Community Q4_K_M, Q6_K, Q8_0 Hugging Face, lmstudio-community 21,2 / 28,5 / 36,9 ГБ Ollama qwen3.6:35bготовий тег, він же latestollama.com 23–24 ГБ MLX 4-біт формат для Mac (Apple MLX) Hugging Face, Unsloth UD-MLX-4bit ≈20 ГБ NVFP4 (Unsloth, з 10.07.2026) 4-бітний формат для RTX 50-ї серії Hugging Face, unsloth н/д Qwen3.6-27B щільна модель того самого покоління Ollama qwen3.6:27b18–19 ГБ
Ліцензія — Apache 2.0. Модель можна використовувати в комерційних продуктах, змінювати й донавчати без обмежень за кількістю користувачів і географією. Це видно і в картці Hugging Face, і в прогоні MERA.
Контекст — скільки тексту модель тримає в голові за раз — 262 144 токени нативно й до 1 010 000 з розтягненням YaRN. Тег Ollama підписано як 256K.
Дата виходу. За Epoch AI модель вийшла 14 квітня 2026 року, репозиторій на Hugging Face створено 15 квітня. Агрегатори у видачі називають 2, 16, 17 і 27 квітня і навіть 30 липня — це дати їхніх власних сторінок, а не релізу. Не плутайте з Qwen 3.6 Plus: це закрита хмарна модель того самого покоління, вийшла в березні, і її ваги не публікували.
Бенчмарки Qwen 3.6 35B-A3B: цифри Alibaba і незалежні перевірки
Бенчмарк — стандартний набір завдань, на якому моделі порівнюють за часткою правильних відповідей. Майже всі цифри нижче взято з карток Alibaba, тобто їх вимірював сам розробник. Незалежно перевірено лише одну: GPQA Diamond.
На графіку видно, що MoE-версія помітно випередила попереднє покоління (Terminal-Bench: 51,5 проти 40,5), але поступається щільній Qwen3.6-27B в усіх чотирьох тестах. Найбільший розрив — в агентних завданнях у терміналі: 51,5 проти 59,3.Тест (дані Alibaba) Qwen3.6-35B-A3B Qwen3.6-27B Qwen3.5-35B-A3B Gemma 4 31B Gemma 4 26B-A4B SWE-bench Verified 73,4 77,2 70,0 52,0 17,4 (імовірно, інша обв’язка) Terminal-Bench 2.0 51,5 59,3 40,5 42,9 34,2 GPQA Diamond 86,0 (Epoch AI: 85) 87,8 84,2 84,3 82,3 LiveCodeBench v6 80,4 83,9 74,6 80,0 77,1 SWE-bench Pro 49,5 н/д 44,6 35,7 13,8
Що підтверджено незалежно, на 25.10.2026:
- GPQA Diamond — Epoch AI наміряла 85% проти 86,0 в Alibaba. Розбіжність в 1 пункт: тут вендору можна вірити.
- Зведений рейтинг Epoch (ECI) — 144 бали, 99-те місце з 253 моделей. На момент виходу було 42-ге зі 193: за пів року модель помітно змістилася вниз, бо вийшли нові.
- Індекс Artificial Analysis v4.3.2 — 18 балів. У Qwen3.8-27B у режимі максимального міркування — 34 (порівняння на Artificial Analysis), у Gemma 4 26B-A4B — 17, причому це оцінка самої Artificial Analysis, повного прогону ще немає. У видачі трапляються й інші цифри індексу, 32 і 52, — найімовірніше, це старі версії шкали, і порівнювати їх із поточною не можна.
- Російська мова — у бенчмарку MERA загальний бал 0,792 і 11-те місце, ruMMLU 0,872 (прогін від 3 травня 2026 року). Важливе застереження: MERA запускала повну BF16-версію на восьми серверних A100, а не 4-бітний файл на домашній карті.
- Українська мова — незалежних тестів для цієї моделі немає.
Для SWE-bench Verified, головного тесту на програмування, незалежного прогону ми не знайшли: 73,4 — це цифра Alibaba. Окремо про Gemma 4 26B-A4B: 17,4 у SWE-bench виглядає аномально низько поруч із 77,1 у LiveCodeBench, найімовірніше, Alibaba запускала її в невідповідній обв’язці.
Ще одне обмеження: усі бенчмарки знято на повній версії моделі. Квантування до 4 біт трохи знижує якість, хоча в акуратних збірок втрати малі: за заміром Unsloth, їхня 4-бітна NVFP4 дає 85,85 у MMLU-Pro проти 85,75 у вихідної BF16.
Скільки пам’яті потрібно MoE-моделі на 35B: вага файлу за квантами
Квантування — стиснення ваг моделі: замість 16 біт на кожне число зберігають 2–8. Що менше біт, то менший файл і нижча якість, але до 4 біт втрати зазвичай невеликі. Скільки важить Qwen 3.6 35B-A3B у Q4_K_M та інших 4-бітних збірках, залежить від автора: 21,2 ГБ у Q4_K_M від LM Studio, 22,1–22,4 ГБ в Unsloth і 23–24 ГБ у тегу Ollama. Різниця — у тому, які шари стиснено сильніше, і в тому, чи рахують автори гігабайти десятковими чи двійковими.
Графік показує головну особливість MoE: навіть у 4 бітах модель важить 21–24 ГБ, стільки ж, скільки щільна модель такого самого розміру. MoE заощаджує обчислення, але не пам’ять.Квант Вага, ГБ Відеокарта (уся модель у VRAM) Mac (відеоядру ≈3/4 пам’яті) Q2_K ≈13 (з кешем 8k, за bestllmfor) 16 ГБ 24 ГБ (≈ оцінка) UD-Q3_K_M 16,6 24 ГБ; на 16 ГБ — лише з вивантаженням 24 ГБ — впритул (≈ оцінка) Q4_K_M / UD-Q4_K_XL 21,2–22,4 24 ГБ, короткий контекст від 32 ГБ Ollama qwen3.6:35b23–24 24 ГБ — впритул від 32 ГБ UD-Q5_K_S 24,9 32 ГБ (RTX 5090) від 36 ГБ (≈ оцінка) Q6_K 28,5–29,3 32 ГБ від 48 ГБ Q8_0 36,9 одна карта не вміщує 48 ГБ — впритул, комфортно 64 ГБ BF16 ≈70 одна карта не вміщує 128 ГБ (пік 65,6 ГБ)
VRAM — власна пам’ять відеокарти; модель працює швидко, лише коли повністю лежить у ній. Єдина пам’ять Mac — спільна для процесора й відеоядра, але відеоядру macOS за замовчуванням віддає лише частину: на 16 ГБ — 12,7 ГБ, на 48 ГБ — 40,2 ГБ, на 128 ГБ — близько 96 ГіБ. Чому так і як цей ліміт підняти, докладно розібрано в матеріалі про те, скільки пам’яті потрібно Mac для ШІ.
Звідси історія з Mac на 24 ГБ. За правилом 3/4 відеоядру дістається близько 18 ГіБ, це приблизно 19,3 десяткового гігабайта. 4-бітна MLX-версія на піку займає 18,3–19,3 ГБ уже на запиті в 1 000 токенів, а підняти ліміт відеоядра можна лише за рахунок пам’яті системи й браузера. На практиці це означає, що 4 біти на 24 ГБ за замовчуванням не помістяться, і лишаються тільки 2–3-бітні збірки.
Понад ваги росте кеш контексту. На M3 Max пік пам’яті зростає з 19,0 ГБ на 1k токенів до 26,4 ГБ на 128k і 29,4 ГБ на 195k. На відеокартах та сама проблема: у Giles Thomas на RTX 3090 файл UD-Q4_K_XL на 22,4 ГіБ не залишив місця під робочий контекст, а трохи сильніше стиснутий UD-IQ4_NL_XL на 19,5 ГіБ дав 89 600 токенів. Якщо важливий довгий контекст, розумно взяти квант на сходинку менший. Як при цьому змінюється якість, видно в замірах квантування Q4 проти Q8.
Як запустити Qwen 3.6 вдома: Ollama, LM Studio, llama.cpp і MLX
Три популярні програми працюють з одними й тими самими GGUF-файлами, але дають різну швидкість і різний рівень контролю. Чим вони відрізняються на одній моделі, розібрано в порівнянні Ollama, LM Studio і llama.cpp. Нижче — порядок дій для Qwen 3.6 35B-A3B.
Крок 1. Ollama: одна команда в терміналі
Qwen 3.6 35B в Ollama ставиться однією командою: ollama run qwen3.6:35b. Ollama сама завантажить тег на 23–24 ГБ і відкриє чат. Тег qwen3.6 без уточнення теж веде на 35B-версію — це latest.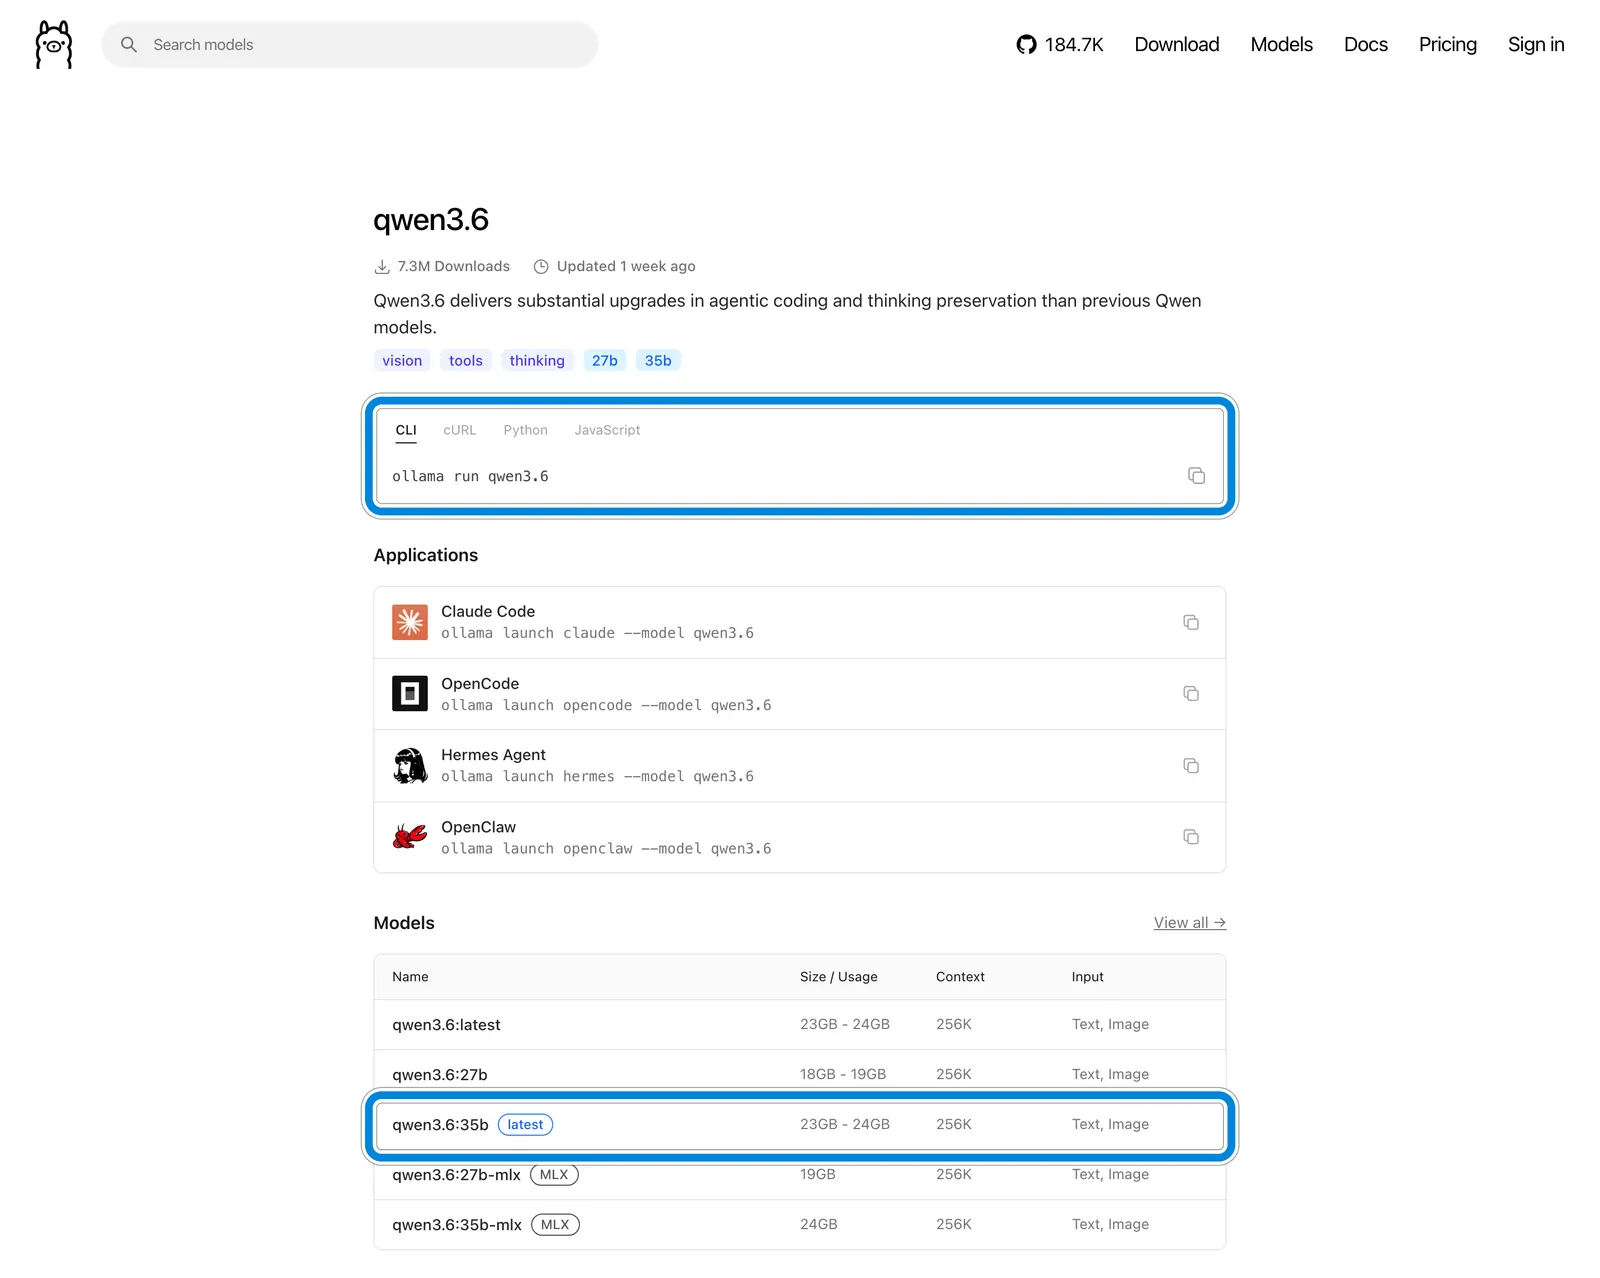
На скриншоті бібліотеки Ollama від 25.10.2026 виділено команду запуску й рядок потрібного тегу: 23–24 ГБ, контекст 256K, вхід — текст і зображення.
Дві речі варто перевірити одразу. Перша — розмір контексту: його задає параметр num_ctx, і краще виставити його явно під своє завдання. Alibaba радить тримати щонайменше 128K токенів, щоб модель не губила нитку міркувань, але на 24-гігабайтній карті такий контекст разом із вагами не поміститься, і доведеться шукати компроміс. Друга — картинки. Бібліотека Ollama позначає тег як «текст і зображення», а InsiderLLM в оновленні від 16.10.2026 пише, що введення картинок в Ollama не працює: вона не підключає окремий файл енкодера зображень (mmproj). Якщо аналіз зображень важливий, надійніше llama.cpp з файлом mmproj, а на Mac — mlx-vlm.
Крок 2. LM Studio: модель мишкою, без термінала
У пошуку LM Studio наберіть Qwen3.6-35B-A3B і виберіть збірку під свою пам’ять: Q4_K_M на 21,2 ГБ для карти на 24 ГБ, 3-бітну для 16 ГБ, MLX-версію для Mac. Якщо підключаєте модель до агента чи редактора коду через сервер LM Studio, перевірте, що клієнт передає preserve_thinking: true у параметрах шаблону чату (chat_template_kwargs). Без нього шаблон Qwen 3.6 викидає попередні міркування, і вже на другому-третьому ході модель починає викликати інструменти з порожніми аргументами. Так сталося в агента pi (GitHub, issue #3325 від 17.04.2026), там це виправили того самого дня.
Крок 3. llama.cpp: максимум швидкості й вивантаження експертів
llama.cpp — рушій, на якому побудовано Ollama і LM Studio; безпосередньо він дає і найвищу швидкість, і всі параметри налаштування. Базова команда з документації Unsloth:
./llama.cpp/llama-cli -hf unsloth/Qwen3.6-35B-A3B-GGUF:UD-Q4_K_XL --temp 1.0 --top-p 0.95 --top-k 20 --min-p 0.00
Для карти на 12 ГБ додають -ngl 999 -ncmoe 18 -fa on. Прапорець -ncmoe N залишає експертів із N шарів в оперативній пам’яті комп’ютера, а все інше — на відеокарті. Саме цей прапорець дає змогу запускати 4-бітну модель на карті з 12 ГБ; докладніше про те, чому це працює, — у розділі з розрахунком.
Важлива пастка: на CUDA 13.2 низькобітні кванти видають нісенітницю, про це попереджають і Unsloth, і InsiderLLM. Беріть 13.1 або 13.3.
Крок 4. Mac: MLX замість Metal у llama.cpp
На Mac краще працювати через MLX — фреймворк Apple для машинного навчання. Його підтримують LM Studio, oMLX і mlx-lm. На M1 Max із 64 ГБ одна й та сама модель у MLX видала 54,4 токени за секунду, а в Ollama — 26,6, тобто вдвічі менше (lilting.ch, 23.04.2026). InsiderLLM пояснює це тим, що ядра Metal у llama.cpp для шарів Gated DeltaNet ще наздоганяють.
Крок 5. Налаштування генерації з картки
| Режим | temperature | top_p | top_k | presence_penalty |
|---|---|---|---|---|
| З міркуванням, загальні завдання | 1.0 | 0.95 | 20 | 1.5 |
| З міркуванням, точний код | 0.6 | 0.95 | 20 | 0.0 |
| Без міркування | 0.7 | 0.80 | 20 | 1.5 |
Перемикачі /think і /nothink із Qwen 3 тут офіційно не підтримуються — режим змінюється лише параметром enable_thinking.
Швидкість генерації на RTX і Apple M: заміри та оцінки
Швидкість генерації вимірюють у токенах за секунду (ток/с): скільки шматочків слів модель видає у відповіді. Для комфортного чату вистачає 20–30 ток/с, для агентів, які пишуть довгі відповіді й багато міркують, що більше, то краще.
На графіку видно три рівні. Карти на 24–32 ГБ тримають усю модель і видають 140–183 ток/с. На 12 ГБ і менше частина експертів переїжджає в оперативну пам’ять, швидкість падає в 3–9 разів, але лишається робочою. RTX 4090 на графіку немає: прямого заміру для неї не знайшлося, а оцінка надто широка, щоб малювати її смугою, — вона в таблиці. Останній рядок — та сама RTX 5090, коли її відеопам’ять займала інша програма.Відеокарта Квант і умови ток/с Замір чи оцінка Джерело, дата RTX 5090 32 ГБ UD-Q4_K_M (Unsloth), llama-bench tg128, збірка b8870 183 замір Zenn, 22.04.2026 RTX 4090 24 ГБ прямого заміру немає ≈144–216 ≈ оцінка, низька точність insidepc: перерахунок замірів 5090 і 3090 за співвідношенням карт на gpt-oss-20b RTX 3090 24 ГБ UD-Q4_K_M, tg128, до 8K контексту 157,7 замір InsiderLLM, липень 2026 (збірка b10088) RTX 3090 24 ГБ UD-IQ4_NL_XL, CUDA, контекст 89 600 139,6 замір Giles Thomas, 24.07.2026 RTX 3090 24 ГБ ncmoe 10, повний контекст 262 144 89,1 замір Giles Thomas, 24.07.2026 RTX 3060 12 ГБ + 32 ГБ RAM IQ4_XS, ncmoe 18, tg128 46,8 замір r/LocalLLaMA, 15.05.2026 RTX 3060 12 ГБ + 32 ГБ RAM ncmoe 24 ≈38 замір InsiderLLM, сторінка від 16.10.2026 GTX 1650 4 ГБ ncmoe 40 ≈20,2 замір InsiderLLM, 11.09.2026 RTX 5090, відеопам’ять зайнята Q5_K_S, відкат на процесор 18 замір Zenn, 22.04.2026
Прямого заміру для RTX 4090 у відкритих джерелах немає, тому в таблиці стоїть діапазон-оцінка. Рахували так: у gpt-oss-20b в одному й тому самому тесті llama.cpp 4090 дає 222 ток/с, 5090 — 282,5, а 3090 — 161,8. Переносимо ці співвідношення на заміри Qwen: 183 × 222 / 282,5 ≈ 144 і 157,7 × 222 / 161,8 ≈ 216. Межі так далеко одна від одної, бо вихідні заміри знято на різних збірках llama.cpp: 183 на 5090 — квітнева b8870, через тиждень після виходу моделі, а 157,7 на 3090 — липнева b10088. Свіжий замір 3090 майже збігається з gpt-oss-20b на тій самій карті (157,7 проти 161,8), тому верхня межа, найімовірніше, ближча до правди — але тоді й квітневі 183 на 5090 уже не стеля. Поки прямого заміру немає, точна цифра для 4090 невідома; ясно лише, що повільнішою за 3090 вона не буде. Зведення замірів усіх трьох карт на інших моделях дивіться в матеріалі RTX 5090, 4090 і 3090 у локальних LLM.
Чому цифри у видачі так розходяться. Сайт bestllmfor пише для цієї моделі 110–125 ток/с на RTX 5090 і 55–70 на RTX 3090, але в ці цифри входить і обробка запиту, а програму й збірку сайт не називає. InsiderLLM оцінює 4090 у 120–140 ток/с — нижче за власний замір на старішій 3090: за її ж словами, оцінку перераховували зі старого заміру 3090 на ~101 ток/с. Чисті прогони llama-bench від Zenn і InsiderLLM дають у 1,5–2,5 раза більше. Є й зворотний ефект: на тій самій RTX 5090 попередня Qwen3.5-35B-A3B видавала 214 ток/с проти 183 у нової. Збірки llama.cpp у цих прогонів різні, але висновок простий: новіша не означає швидша, і швидкість Qwen 3.6 ще зростатиме з оновленнями рушія.
Окрема пастка — тихий відкат на процесор. Автор тесту на Zenn отримав 18 ток/с замість 180 на кванті Q5_K_S, бо у фоні Ollama тримала у відеопам’яті ту саму модель на 22,7 ГБ, а ще 7 ГБ займала друга модель. llama.cpp не повідомив про помилку, а просто перейшов на процесор. Перед запуском однієї програми закривайте іншу.
Швидкість на Mac зростає разом із пропускною здатністю пам’яті, але не пропорційно: M4 Max із 546 ГБ/с видає 108,8–121,3 ток/с, а версія з 410 ГБ/с — 109,9: приріст від нуля до 10%. Заштриховані смуги — наша оцінка для чипів, на яких замірів цієї моделі немає.Mac Смуга пам’яті ток/с (1k) Замір чи оцінка Джерело, дата M4 Max 40c, 64 ГБ 546 ГБ/с 121,3 замір oMLX, 26.04.2026 M4 Max 32c, 36 ГБ 410 ГБ/с 109,9 замір oMLX, 25.04.2026 M4 Max 40c, 48 ГБ 546 ГБ/с 108,8 замір oMLX, 20.04.2026 M3 Max 40c, 64 ГБ 400 ГБ/с 102,8 замір oMLX, 24.04.2026 M5 Max 40c, 128 ГБ, 8 біт 614 ГБ/с 96,0 замір, інший квант oMLX, 24.04.2026 M4 Pro 20c, 48 ГБ 273 ГБ/с 85,9 замір oMLX, 18.05.2026 M4 Max 40c, 128 ГБ, BF16 546 ГБ/с 62,2 замір, без стиснення oMLX, 19.05.2026 M1 Max, 64 ГБ 400 ГБ/с 54,4 замір, інша методика lilting.ch, 23.04.2026 M5 Max 40c, 4 біти 614 ГБ/с ≈116–137 ≈ оцінка insidepc, формула нижче M5 Pro 20c, 48 ГБ 307 ГБ/с ≈81–96 ≈ оцінка insidepc, формула нижче M5, 32 ГБ 153 ГБ/с ≈41–48 ≈ оцінка insidepc, формула нижче M4, 32 ГБ 120 ГБ/с ≈32–37 ≈ оцінка insidepc, формула нижче
Усі заміри oMLX зробили учасники спільноти на oMLX 0.3.6–0.3.9 з 4-бітною моделлю й запитом в 1 000 токенів, якщо не вказано інше. Рядок M1 Max знято іншим способом — як загальний час відповіді разом із читанням запиту, тому він нижчий, ніж дав би той самий чип в oMLX.
З довгим контекстом швидкість падає сходинкою. Замір на M3 Max 40c із 64 ГБ (oMLX, 24.04.2026):Контекст 1k 8k 32k 64k 128k 195k ток/с 102,8 90,5 90,0 81,1 40,6 43,9 Пік пам’яті, ГБ 19,0 20,1 21,9 23,8 26,4 29,4
До 64k токенів модель втрачає близько 20% швидкості, а далі — удвічі. Якщо плануєте давати їй великі кодові бази чи довгі документи, орієнтуйтеся на правий край таблиці, а не на рекламні цифри для короткого запиту.
Чому MoE швидка на Mac і слабкій карті: розрахунок за пам’яттю
Під час генерації кожного токена модель має прочитати з пам’яті всі задіяні ваги. Тому стелю швидкості задає не потужність чипа, а пропускна здатність пам’яті — скільки гігабайтів за секунду вона встигає віддати. Звідси проста формула:
швидкість ≈ смуга пам’яті ÷ обсяг ваг на один токен × ККД
У Qwen 3.6 35B-A3B на токен працюють близько 3 млрд параметрів. У 4 бітах зі службовими даними це приблизно 4,5 біта на параметр, тобто 3 млрд × 4,5 / 8 ≈ 1,7 ГБ на токен. У щільної моделі на 27B у тих самих 4 бітах — близько 15 ГБ на токен, майже в 9 разів більше. Це і є відповідь на питання, чому MoE швидка.
ККД — яку частку теоретичної стелі чип реально видає. Його можна порахувати із замірів:Чип Смуга, ГБ/с Стеля, ток/с (смуга ÷ 1,7) Замір, ток/с ККД M4 Pro 20c 273 ≈161 85,9 ≈0,53 M4 Max 32c 410 ≈241 109,9 ≈0,46 M3 Max 40c 400 ≈235 102,8 ≈0,44 M4 Max 40c, 64 ГБ 546 ≈321 121,3 ≈0,38 M4 Max 40c, 48 ГБ 546 ≈321 108,8 ≈0,34
Що ширша пам’ять, то нижчий ККД. За нашим розрахунком, причина — сталі накладні витрати на кожен токен, які від смуги не залежать. Їх можна прикинути за двома замірами одного чипа, знятими на різних комп’ютерах і версіях oMLX: на M4 Max 40c 4 біти (≈1,7 ГБ на токен) дають 121,3 ток/с, тобто 8,2 мс на токен, а BF16 (≈6 ГБ на токен) — 62,2 ток/с, 16,1 мс. Зайві 4,3 ГБ додали 7,8 мс — це читання на повній смузі близько 550 ГБ/с, а решта ≈5 мс на токен іде на накладні витрати. Коли ваг на токен мало, як у MoE, ці 5 мс і з’їдають ККД.
Тому для чипів без заміру ми беремо ККД із діапазону, який спостерігали в сусідів: 0,45–0,53 для M4, M5 і M5 Pro (як у M4 Pro та M3 Max) і 0,32–0,38 для M5 Max (як у M4 Max 40c). Найменш надійні рядки — базові M4 і M5 з 10-ядерним відеоядром: замірів у цьому класі немає жодного. Оцінку M5 Max підтверджує і його власний замір у 8 бітах: 96 ток/с на ≈3,2 ГБ на токен дають ті самі ≈5 мс накладних витрат, і для 4 біт із цього виходить близько 125 ток/с — у межах діапазону. Так вийшли заштриховані рядки в таблиці швидкості на Mac. Це оцінка, а не замір.
Та сама логіка пояснює, як модель працює на слабких картах. На RTX 3090 уся модель у відеопам’яті дає 157,7 ток/с, тобто близько 6,3 мс на токен. За заміром InsiderLLM, кожен шар експертів, винесений в оперативну пам’ять, додає приблизно 0,53 мс. Усі 40 шарів в оперативці: 6,3 + 40 × 0,53 ≈ 27,5 мс, або близько 36 ток/с, і це збігається із заміром InsiderLLM для повного вивантаження.
Вивантаження має обрив. На RTX 3060 з 12 ГБ із -ncmoe 17 швидкість 46,6 ток/с, а з -ncmoe 16 — уже 25,8 (r/LocalLLaMA, 15.05.2026). Найімовірніше, на цьому кроці у відеопам’ять перестає поміщатися все інше, і драйвер починає ганяти дані туди й назад. Підбирайте N згори вниз і зупиняйтеся на крок раніше за обрив.
А от «прискорювачі» майже не допомагають. Спекулятивна генерація MTP, коли модель вгадує кілька токенів наперед, у MoE дає 15–25% за даними Unsloth і лише 2% в автора тесту на RTX 3060. Швидкість дають правильний квант, прапорець -ncmoe і свіжа збірка рушія.
Qwen 3.6 35B-A3B проти Qwen 3.8 27B, gpt-oss-20b і Gemma 4
Головний вибір тут — між швидкістю та якістю. MoE-моделі (Qwen 3.6 35B-A3B, gpt-oss-20b, Gemma 4 26B-A4B) швидкі, щільні (Qwen 3.8 27B, Qwen3.6-27B) розумніші, але повільніші.Qwen 3.6 35B-A3B Qwen 3.8 27B Qwen 3.6 27B gpt-oss-20b Gemma 4 26B-A4B Будова MoE, 35B / 3B активних щільна, 27B щільна, 27B MoE, 21B / 3,6B активних MoE, 26B / ≈4B активних Вихід квітень 2026 серпень 2026 квітень 2026 серпень 2025 н/д Пам’ять, 4 біти 21,2–24 ГБ н/д 18–19 ГБ (Ollama) до 16 ГБ (OpenAI) н/д RTX 3090, llama-bench 157,7 ток/с н/д н/д 161,8 ток/с н/д RTX 5090, llama-bench 183 ток/с н/д н/д 282,5 ток/с н/д M4 Max 32c, 36 ГБ 109,9 ток/с (MLX) н/д н/д 92,4 ток/с (llama.cpp) н/д Індекс Artificial Analysis v4.3.2 18 34 н/д н/д 17 (оцінка AA) GPQA Diamond (картки розробників; Gemma — за таблицею Alibaba) 86,0 89,2 87,8 66 82,3 Швидкість API, Artificial Analysis 131 ток/с 44 ток/с н/д н/д 91 ток/с Ціна API за 1М токенів, вхід / вихід $0,375 / $2,25 $0,50 / $3,00 н/д н/д $0,10 / $0,34 Ліцензія Apache 2.0 Apache 2.0 Apache 2.0 Apache 2.0 н/д Контекст 262 144 262 144 262 144 н/д 256K
Ціни й індекси — на 25.10.2026, за даними Artificial Analysis; в окремих провайдерів ціна буває і нижчою, і вищою за медіану.
Qwen 3.6 35B vs Qwen 3.8 27B: швидкість проти якості
Qwen 3.8 27B — щільна модель наступного покоління, вийшла в серпні 2026 року, теж під Apache 2.0 і з тим самим контекстом 262 144. У незалежному індексі Artificial Analysis вона набирає 34 бали проти 18 у Qwen 3.6 35B-A3B, тобто майже вдвічі більше. Ціна — швидкість: через API 44 ток/с проти 131. На домашньому залізі розрив схожий: на M1 Max щільна Qwen3.6-27B видавала 11,5 ток/с проти 54,4 у MoE-версії (lilting.ch), це в 4,7 раза. Якщо модель пише код в агенті й помилка коштує дорожче за очікування, беріть Qwen 3.8 27B. Якщо важливо, щоб модель швидко відповідала в чаті, або треба запустити модель на 12-гігабайтній карті, лишається Qwen 3.6 35B-A3B.
Qwen 3.6 35B vs gpt-oss-20b: хто швидший на тій самій карті
gpt-oss-20b — відкрита модель OpenAI, теж MoE і теж під Apache 2.0. Вона легша: OpenAI заявляє, що вона працює в 16 ГБ пам’яті, а отже, поміщається туди, куди Qwen 3.6 35B-A3B не влазить. На потужних картах gpt-oss-20b швидша: 282,5 проти 183 ток/с на RTX 5090. На RTX 3090 вони майже рівні — 161,8 проти 157,7. Застереження: заміри gpt-oss зроблено в серпні 2025 року на ранній збірці llama.cpp, у Qwen — у 2026-му на інших, тож порівняння орієнтовне. За вендорським GPQA Diamond Qwen помітно сильніша: 86,0 проти 66.
Qwen 3.6 35B vs Gemma 4 26B-A4B: два MoE одного класу
Gemma 4 26B-A4B від Google — найближчий за будовою суперник: теж MoE, близько 4 млрд активних параметрів. В індексі Artificial Analysis вони майже рівні — 18 проти 17, але в Gemma це поки оцінка, а не повний прогін. За даними Alibaba Qwen попереду в Terminal-Bench (51,5 проти 34,2) і в LiveCodeBench (80,4 проти 77,1). Через API Gemma дешевша в кілька разів: $0,10 / $0,34 проти $0,375 / $2,25 за мільйон токенів, але повільніша — 91 ток/с проти 131. У Gemma 4 26B-A4B менше параметрів загалом — 26 млрд проти 35, тому й файл у неї легший: для карти на 16 ГБ це аргумент на її користь.
Коли Qwen 3.6 35B-A3B не підійде: петлі, інструменти, мова
Слабкі місця моделі, відомі на 25.10.2026, зібрано нижче разом із тим, що їх урівноважує.
Ризики в агентах, Ollama і на CUDA 13.2
- Петлі в агентах. InsiderLLM в оновленні від 16.10.2026 пише про повторні невдалі виклики інструментів і про те, що щільна 27B «стабільніша». На r/LocalLLaMA скаржаться, що після довгого контексту модель зациклюється й забуває інструкції. Для серйозної агентної роботи це головний мінус.
- Порожні аргументи інструментів. Без
preserve_thinking=trueшаблон чату відкидає попередні міркування, і виклики інструментів надходять порожніми (GitHub pi #3325, 17.04.2026). Це не дефект ваг, а налаштування, але новачки на нього натрапляють. - Тихий відкат на процесор. Якщо відеопам’ять зайнята іншою моделлю, швидкість падає зі 180 до 18 ток/с без жодного попередження (Zenn, 22.04.2026).
- CUDA 13.2. На низькобітних квантах видає нісенітницю (Unsloth, InsiderLLM).
- Картинки в Ollama. Джерела розходяться: бібліотека Ollama позначає тег як «текст і зображення», а InsiderLLM (16.10.2026) пише, що введення картинок там не працює, бо Ollama не підключає файл mmproj.
- Пам’ять на довгому контексті. На 128k швидкість на Mac падає вдвічі, а пік пам’яті зростає на 7 ГБ.
- Мови. Російську перевірено в MERA на повній версії моделі, українську не перевіряв ніхто. Якість 4-бітної версії обома мовами невідома.
- Вік. Модель квітнева. У рейтингу Epoch AI вона опустилася з 42-го місця на 99-те, наступне покоління Qwen 3.8 уже вийшло.
Плюси для балансу: GPQA Diamond підтверджено незалежно, ліцензія Apache 2.0 без географічних обмежень, на RTX 3090 модель видає 140–158 ток/с, а 12-гігабайтні карти тягнуть її на 38–47 ток/с. Ще один плюс локального запуску — приватність: запити й файли не йдуть на чужий сервер. Під час роботи через API дані отримує провайдер, і умови зберігання в кожного свої.
Чого ми не знаємо: реальної швидкості на RTX 4090, незалежного результату в SWE-bench і якості українською. Першим застаріє блок про швидкість — з кожною збіркою llama.cpp і MLX цифри змінюються, свіжі заміри варто дивитися в таблицях oMLX і обговореннях llama.cpp.
Яку збірку Qwen 3.6 вибрати: код, агент, ноутбук, слабка карта
- RTX 3090 або 4090, 24 ГБ. Q4_K_M або UD-IQ4_NL_XL у llama.cpp — на 3090 140–158 ток/с за замірами; на 4090 заміру немає, за нашою оцінкою не менше. Якщо потрібен увесь контекст 262 144, винесіть експертів із 10 шарів (
-ncmoe 10): у Giles Thomas це дало 89 ток/с на повному вікні. - RTX 5090, 32 ГБ. Можна взяти більший квант, Q5 або Q6 на 25–29 ГБ, або формат NVFP4: за даними Unsloth, на 32 ГБ він пришвидшує цю модель в 1,7 раза.
- 12 ГБ, наприклад RTX 3060. IQ4_XS і
-ncmoe 17–20з 32 ГБ оперативної пам’яті — 38–47 ток/с. - 4–8 ГБ. Працює і на GTX 1650 з 4 ГБ, близько 20 ток/с за майже повного вивантаження. Але тут уже варто дивитися на gpt-oss-20b, якій вистачає 16 ГБ спільної пам’яті.
- Mac на 16–24 ГБ. Не та модель: 4 біти не поміщаються, на 24 ГБ лишаються тільки 2–3-бітні збірки впритул. Якщо вибираєте комп’ютер під локальний ШІ, почніть із гіда який Mac вибрати.
- Mac на 32–48 ГБ. 4-бітна MLX-версія: близько 86 ток/с на M4 Pro і 109–121 на M4 Max.
- Mac на 64–128 ГБ. 8 біт (96 ток/с на M5 Max) або навіть вихідна BF16 (62 ток/с на M4 Max зі 128 ГБ): у 8 бітах втрати від стиснення мінімальні, у BF16 їх немає зовсім.
- Агент і серйозний код. Щільна Qwen 3.8 27B або Qwen3.6-27B: повільніші в 3–5 разів, але помиляються рідше.
- Без власного заліза. Через API за даними Artificial Analysis на 25.10.2026 — $0,375 за мільйон вхідних токенів і $2,25 за мільйон вихідних (медіана провайдерів).
FAQ
Скільки пам’яті потрібно, щоб запустити Qwen 3.6 35B-A3B?
У 4 бітах сам файл важить 21,2–24 ГБ залежно від збірки, плюс 1–7 ГБ на контекст. Мінімальний комфортний варіант — відеокарта на 24 ГБ з коротким контекстом або Mac із 32 ГБ єдиної пам’яті. Повна версія BF16 важить близько 70 ГБ і потребує Mac на 128 ГБ. На менших картах модель працює, якщо частину експертів винести в оперативну пам’ять.
Чи запуститься модель на RTX 3060 12 ГБ або Mac із 16 ГБ?
На RTX 3060 — так: з вивантаженням експертів в оперативну пам’ять (прапорець -ncmoe у llama.cpp) і 32 ГБ RAM вона видає 38–47 токенів за секунду за замірами InsiderLLM і r/LocalLLaMA. На Mac із 16 ГБ — ні: відеоядру дістається близько 12,7 ГБ, а навіть 2-бітній збірці потрібно близько 13 ГБ разом із контекстом.
Чим Qwen 3.6 35B-A3B краща за Qwen 3.8 27B і чим гірша?
Краща — швидкістю: через API 131 токен за секунду проти 44, на домашньому залізі розрив у 3–5 разів. Гірша — якістю: у незалежному індексі Artificial Analysis v4.3.2 у неї 18 балів проти 34. Для чату й швидких завдань підходить Qwen 3.6 35B-A3B, для складного коду й агентів — щільна Qwen 3.8 27B.
Чи можна використовувати Qwen 3.6 у комерційних проєктах?
Так. Ваги викладено під ліцензією Apache 2.0: модель можна вбудовувати в платні продукти, змінювати й донавчати без обмежень за кількістю користувачів і країною. Ліцензію вказано в картці моделі на Hugging Face, і її підтверджує прогін MERA. Відповідати за те, що модель згенерує у вашому продукті, доведеться вам самим.
Чому модель на 35B генерує так швидко?
Бо це MoE: на кожен токен працюють лише близько 3 млрд параметрів із 35 — вісім експертів із 256 і один спільний. З пам’яті на токен читається близько 1,7 ГБ ваг, а не понад 20. Але зберігати в пам’яті доводиться всі 35 млрд, тому пам’яті вона потребує як велика модель.
Чи вміє модель працювати із зображеннями й відео локально?
Так, модель має енкодер зображень: вона читає фото, скани й відео, за даними Alibaba — на рівні 83,7 у VideoMMMU. Але локально це працює не скрізь: Ollama позначає тег як такий, що підтримує зображення, а InsiderLLM пише, що в неї введення картинок не працює. Для зображень надійніше llama.cpp з файлом mmproj або mlx-vlm на Mac.