

Коротко (TL;DR)
- Max — это не пять чипов, а десять версий. У каждого поколения есть младшая и старшая версия с разным числом ядер, а начиная с M3 — ещё и с разной пропускной способностью памяти и разным потолком объёма; по всем десяти версиям полоса — от 300 до 614 ГБ/с.
- Для локальных нейросетей решают память и её полоса, а не поколение. Генерация текста у M5 Max быстрее, чем у M4 Max, примерно на те же 9–12%, на которые выросла полоса памяти (546 → 614 ГБ/с).
- Настоящий прирост M5 Max — чтение промпта. В одном и том же тесте llama.cpp M5 Max обрабатывает запрос примерно втрое быстрее M4 Max даже после поправки на новую версию программы.
- Модель 70B на любом Max — 4–12 токенов в секунду. Потолок даже у старшего M5 Max — 14,4 ток/с; обещания «20–30 ток/с» для плотной 70B пока не подтверждены ни одним замером.
- Самый большой скачок в истории Max — M3, а не M5: аппаратная трассировка лучей подняла рендер Blender на GPU в 2,5 раза.
- Бюджетный вариант для ИИ — б/у M1 Max или M2 Max на 64 ГБ: у них та же полоса 400 ГБ/с, что у старшего M3 Max, а цена в Украине на 25 октября 2026 года — от 95 550 грн с гарантией магазина.
Словарь: пять терминов, без которых сравнение не читается
- Бин (версия чипа) — один и тот же чип с частью отключённых ядер. Apple продаёт M4 Max в двух бинах: 14 ядер CPU и 32 ядра GPU или 16 и 40. Начиная с M3 Max, бины отличаются не только ядрами, но и шириной шины памяти; у M1 Max и M2 Max шина в обоих бинах одинаковая.
- Пропускная способность памяти (полоса, memory bandwidth) — сколько гигабайт в секунду чип может прочитать из памяти. Для генерации текста нейросетью это главный параметр.
- Токен — кусок слова, которым оперирует модель. Скорость меряют в токенах в секунду (ток/с).
- Генерация и prompt processing. Генерация — скорость, с которой модель печатает ответ. Prompt processing (prefill, чтение промпта) — скорость, с которой она прочитывает ваш запрос, файлы и историю диалога до первого слова ответа.
- Квантование — сжатие весов модели: Q4 хранит каждый параметр примерно в 4 битах вместо 16, и модель 70B помещается в 42,5 ГБ вместо 140. Чем ниже квант, тем меньше файл и тем сильнее потери качества — подробно в разборе квантования Q4 против Q8.
Чипы Max M1–M5: бины ядер, тип памяти и полоса в одной таблице
Если коротко сравнить M2 Max vs M3 Max vs M4 Max vs M5 Max и их предшественника M1 Max, то за пять лет у Max выросли три вещи: потолок памяти (с 64 до 128 ГБ), пропускная способность (с 400 до 614 ГБ/с) и графика. Но рост был неровным, и внутри каждого поколения есть «облегчённая» версия, которая по части параметров уступает старшей версии прошлого года.
- Коротко (TL;DR)
- Словарь: пять терминов, без которых сравнение не читается
- Чипы Max M1–M5: бины ядер, тип памяти и полоса в одной таблице
- Что влезает в память Max: модели от 27B до 120B в 36–128 ГБ
- Скорость LLM: генерацию определяет полоса памяти
- Чтение промпта у Max: M5 Max втрое быстрее M4 Max
- Генерация картинок и транскрипция: что измерено, а что оценка
- CPU и GPU Max в тестах: Blender, Geekbench и Cinebench
- Монтаж, 3D и игры: где M5 Max не обгоняет M4 Max
- Слабые места Max: корпус 14 дюймов, шина M3 Max и цена памяти
- Б/у M1 Max и M2 Max против нового M4 и M5 Max для ИИ
- Цены в Украине на 25 октября 2026: новые и б/у Mac с Max
- Какой Max выбрать: M1, M2, M3, M4 или M5 под вашу задачу
- FAQ
Эта статья — часть гида «Какой Mac выбрать»: там карта всех чипов M1–M6 с тестами, подбор конфигурации под вашу задачу и калькулятор «какая нейросеть влезет».
Последнее поколение — M5 Max, который Apple представила 3 марта 2026 года, — получил новую память LPDDR5X-9600 и нейроускоритель в каждом ядре GPU. Apple заявляет для ИИ «более 4x пиковых вычислений GPU» против M4 Max — это заявка производителя, а не независимый замер; что из неё подтверждается тестами, разберём ниже.Чип и бин Год CPU GPU Память Тип памяти Полоса Где стоит M1 Max 2021 10 (8P + 2E) 24 32 / 64 ГБ LPDDR5-6400 400 ГБ/с MacBook Pro 14/16, Mac Studio (2022) M1 Max 2021 10 (8P + 2E) 32 32 / 64 ГБ LPDDR5-6400 400 ГБ/с MacBook Pro 14/16, Mac Studio M2 Max 2023 12 (8P + 4E) 30 32 / 64 ГБ LPDDR5-6400 400 ГБ/с MacBook Pro 14/16, Mac Studio M2 Max 2023 12 (8P + 4E) 38 32 / 64 / 96 ГБ LPDDR5-6400 400 ГБ/с MacBook Pro 14/16, Mac Studio M3 Max 2023 14 (10P + 4E) 30 36 / 96 ГБ LPDDR5-6400 300 ГБ/с MacBook Pro 14/16 M3 Max 2023 16 (12P + 4E) 40 48 / 64 / 128 ГБ LPDDR5-6400 400 ГБ/с MacBook Pro 14/16 M4 Max 2024 14 (10P + 4E) 32 36 ГБ LPDDR5X-8533 410 ГБ/с MacBook Pro 14/16, Mac Studio (2025) M4 Max 2024 16 (12P + 4E) 40 48 / 64 / 128 ГБ LPDDR5X-8533 546 ГБ/с MacBook Pro 14/16, Mac Studio (2025) M5 Max 2026 18 (6 супер + 12) 32 36 ГБ LPDDR5X-9600 460 ГБ/с MacBook Pro 14/16, Mac Studio (2026) M5 Max 2026 18 (6 супер + 12) 40 48 / 64 / 128 ГБ LPDDR5X-9600 614 ГБ/с MacBook Pro 14/16, Mac Studio (2026)
Откуда берётся полоса, проще всего показать на M1 Max: шина 512 бит × 6400 миллионов передач в секунду ÷ 8 бит в байте ≈ 409,6 ГБ/с — это и есть «400 ГБ/с» из спецификации. Поэтому у M1 Max и M2 Max полоса одинаковая: тип памяти и ширина шины не менялись. У M4 Max и M5 Max её подняли более быстрой памятью LPDDR5X.
На графике видно главное: старшая версия M3 Max по полосе не обогнала M1 Max пятилетней давности (те же 400 ГБ/с), а младшая и вовсе отстала — 300 ГБ/с. Ощутимый рост начался только с M4 Max. Таблица выше дублирует эти цифры.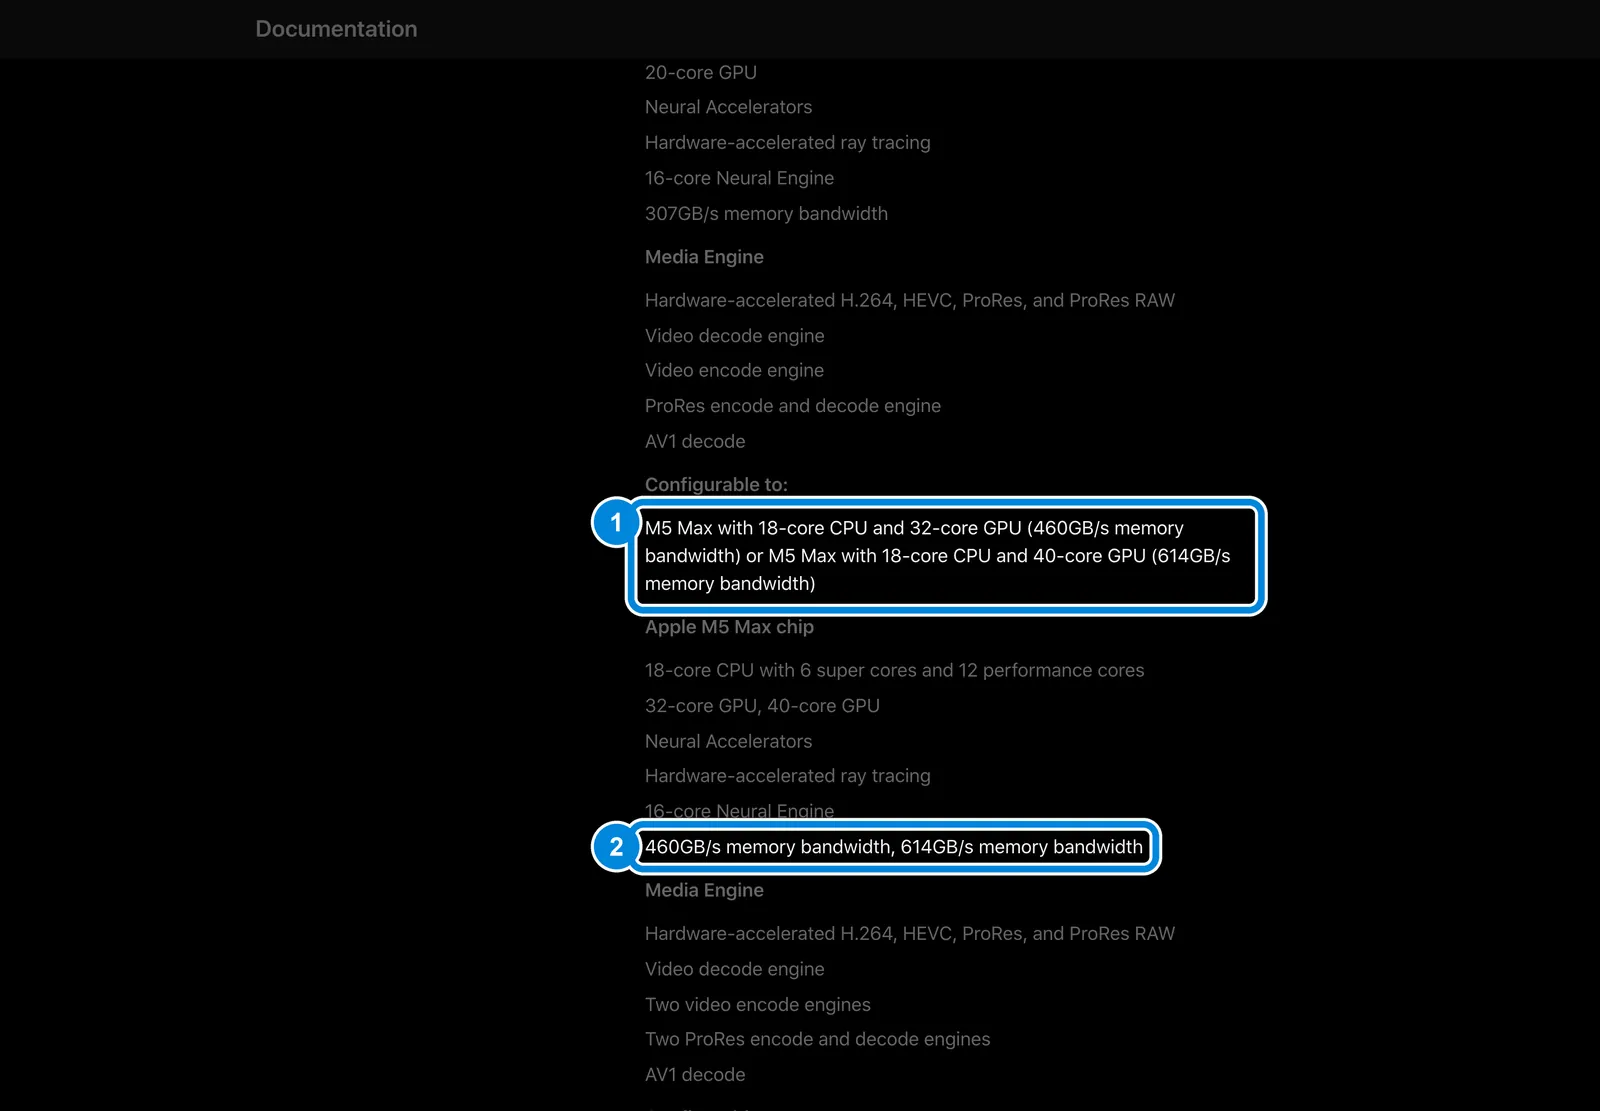
На скриншоте страницы характеристик MacBook Pro 16 с M5 Max на сайте поддержки Apple (снято 25 октября 2026 года) рамка 1 показывает две конфигурации чипа — 32-ядерный GPU с полосой 460 ГБ/с и 40-ядерный с 614 ГБ/с, а рамка 2 — те же две цифры в описании самого чипа. Обе версии получили одинаковый 18-ядерный процессор; различаются графика, шина памяти и максимальный объём.
Ещё две вещи, которых нет в таблице, но которые важны дальше. Аппаратная трассировка лучей (ускоритель расчёта света в 3D-сценах) появилась только в M3 — у M1 Max и M2 Max её нет. А 18-ядерный процессор M5 Max устроен иначе, чем у предшественников: шесть «супер-ядер» — так Apple теперь называет свои самые быстрые ядра — и 12 новых производительных ядер, настроенных на экономичную многопоточную работу. Энергоэффективных ядер в прежнем виде в M5 Max нет.
Что влезает в память Max: модели от 27B до 120B в 36–128 ГБ
Память у Mac общая для процессора и графики, поэтому модель «видит» не весь объём. По данным, которые приводит независимый набор тестов на GitHub со ссылкой на Apple, GPU может занять около 70% памяти на Mac с 32 ГБ и около 78% на конфигурациях больше. Остальное держит система и программы.
Отсюда простой расчёт: доступно модели ≈ объём памяти × 0,70–0,78. Это оценка, а не гарантия: под длинный диалог модели нужен ещё кэш контекста (KV-кэш), и он растёт с длиной разговора — как его посчитать, разобрано в материале о том, сколько видеопамяти нужно модели.Объём памяти Доступно GPU (≈ оценка) Qwen 27B Q4, 17 ГБ MoE 35B-A3B, 23 ГБ 70B Q4_K_M, 42,5 ГБ gpt-oss 120B, 65 ГБ 70B Q8_0, 75 ГБ 32 ГБ ≈ 22 ГБ да на грани, нет нет нет нет 36 ГБ ≈ 27 ГБ да да нет нет нет 48 ГБ ≈ 37 ГБ да да нет нет нет 64 ГБ ≈ 50 ГБ да да да нет нет 96 ГБ ≈ 75 ГБ да да да да впритык, нет 128 ГБ ≈ 100 ГБ да да да да да
Вес моделей в таблице — реальные файлы: 70B Q4_K_M — 42,5 ГБ, 70B Q8_0 — около 75 ГБ (по файлам на Hugging Face), gpt-oss 120B в формате MXFP4 — 65 ГБ, Qwen 3.8 27B в 4 битах — 17 ГБ.
Из таблицы следует важное для покупки. Для локального AI в паре M4 Max vs M5 Max объём решает больше поколения: младшие версии обоих чипов продаются только с 36 ГБ, и модель 70B в них не помещается вообще. Для 70B в 4 битах нужно минимум 64 ГБ, для MoE-модели на 120 миллиардов параметров — 96 ГБ, для 70B в 8 битах — 128 ГБ. Значит, M2 Max с 96 ГБ закрывает больше сценариев, чем новый M5 Max с 36 ГБ.
MoE (Mixture of Experts, «смесь экспертов») — модель, в которой на каждый токен работает лишь малая часть параметров. У Qwen 3.6 35B-A3B активны около 3 миллиардов из 35, поэтому она быстрая, как маленькая модель, но в памяти занимает место большой.
Скорость LLM: генерацию определяет полоса памяти
Чтобы напечатать каждый следующий токен, чип прочитывает из памяти все веса плотной модели целиком. Поэтому скорость генерации упирается не в ядра, а в то, как быстро память отдаёт данные. В сравнении M4 Max vs M5 Max это видно по одному числу: memory bandwidth (пропускная способность памяти) выросла с 546 до 614 ГБ/с, то есть на 12,5%, — и генерация выросла примерно на столько же.
Где реального замера нет, ниже мы считаем оценку по одной открытой формуле:
скорость генерации ≈ полоса памяти ÷ вес модели × η, где η (эта) — доля полосы, которая реально доходит до модели. По замерам η обычно 0,6–0,8; у старого M1 Max на сборке llama.cpp 2024 года вышло около 0,43.
Без множителя η формула даёт потолок — скорость, выше которой обычная генерация физически не поднимется. Все числа с пометкой «оценка» в этой статье посчитаны так.
Реальные замеры llama.cpp на девяти версиях чипа
Самый полный открытый замер — таблица разработчиков llama.cpp в обсуждении #4167 на GitHub: одна модель (Llama 2 7B), один квант Q4_0, одинаковые параметры теста на всех чипах. В ней есть девять из десяти версий Max; младшего M5 Max с 32-ядерным GPU там нет.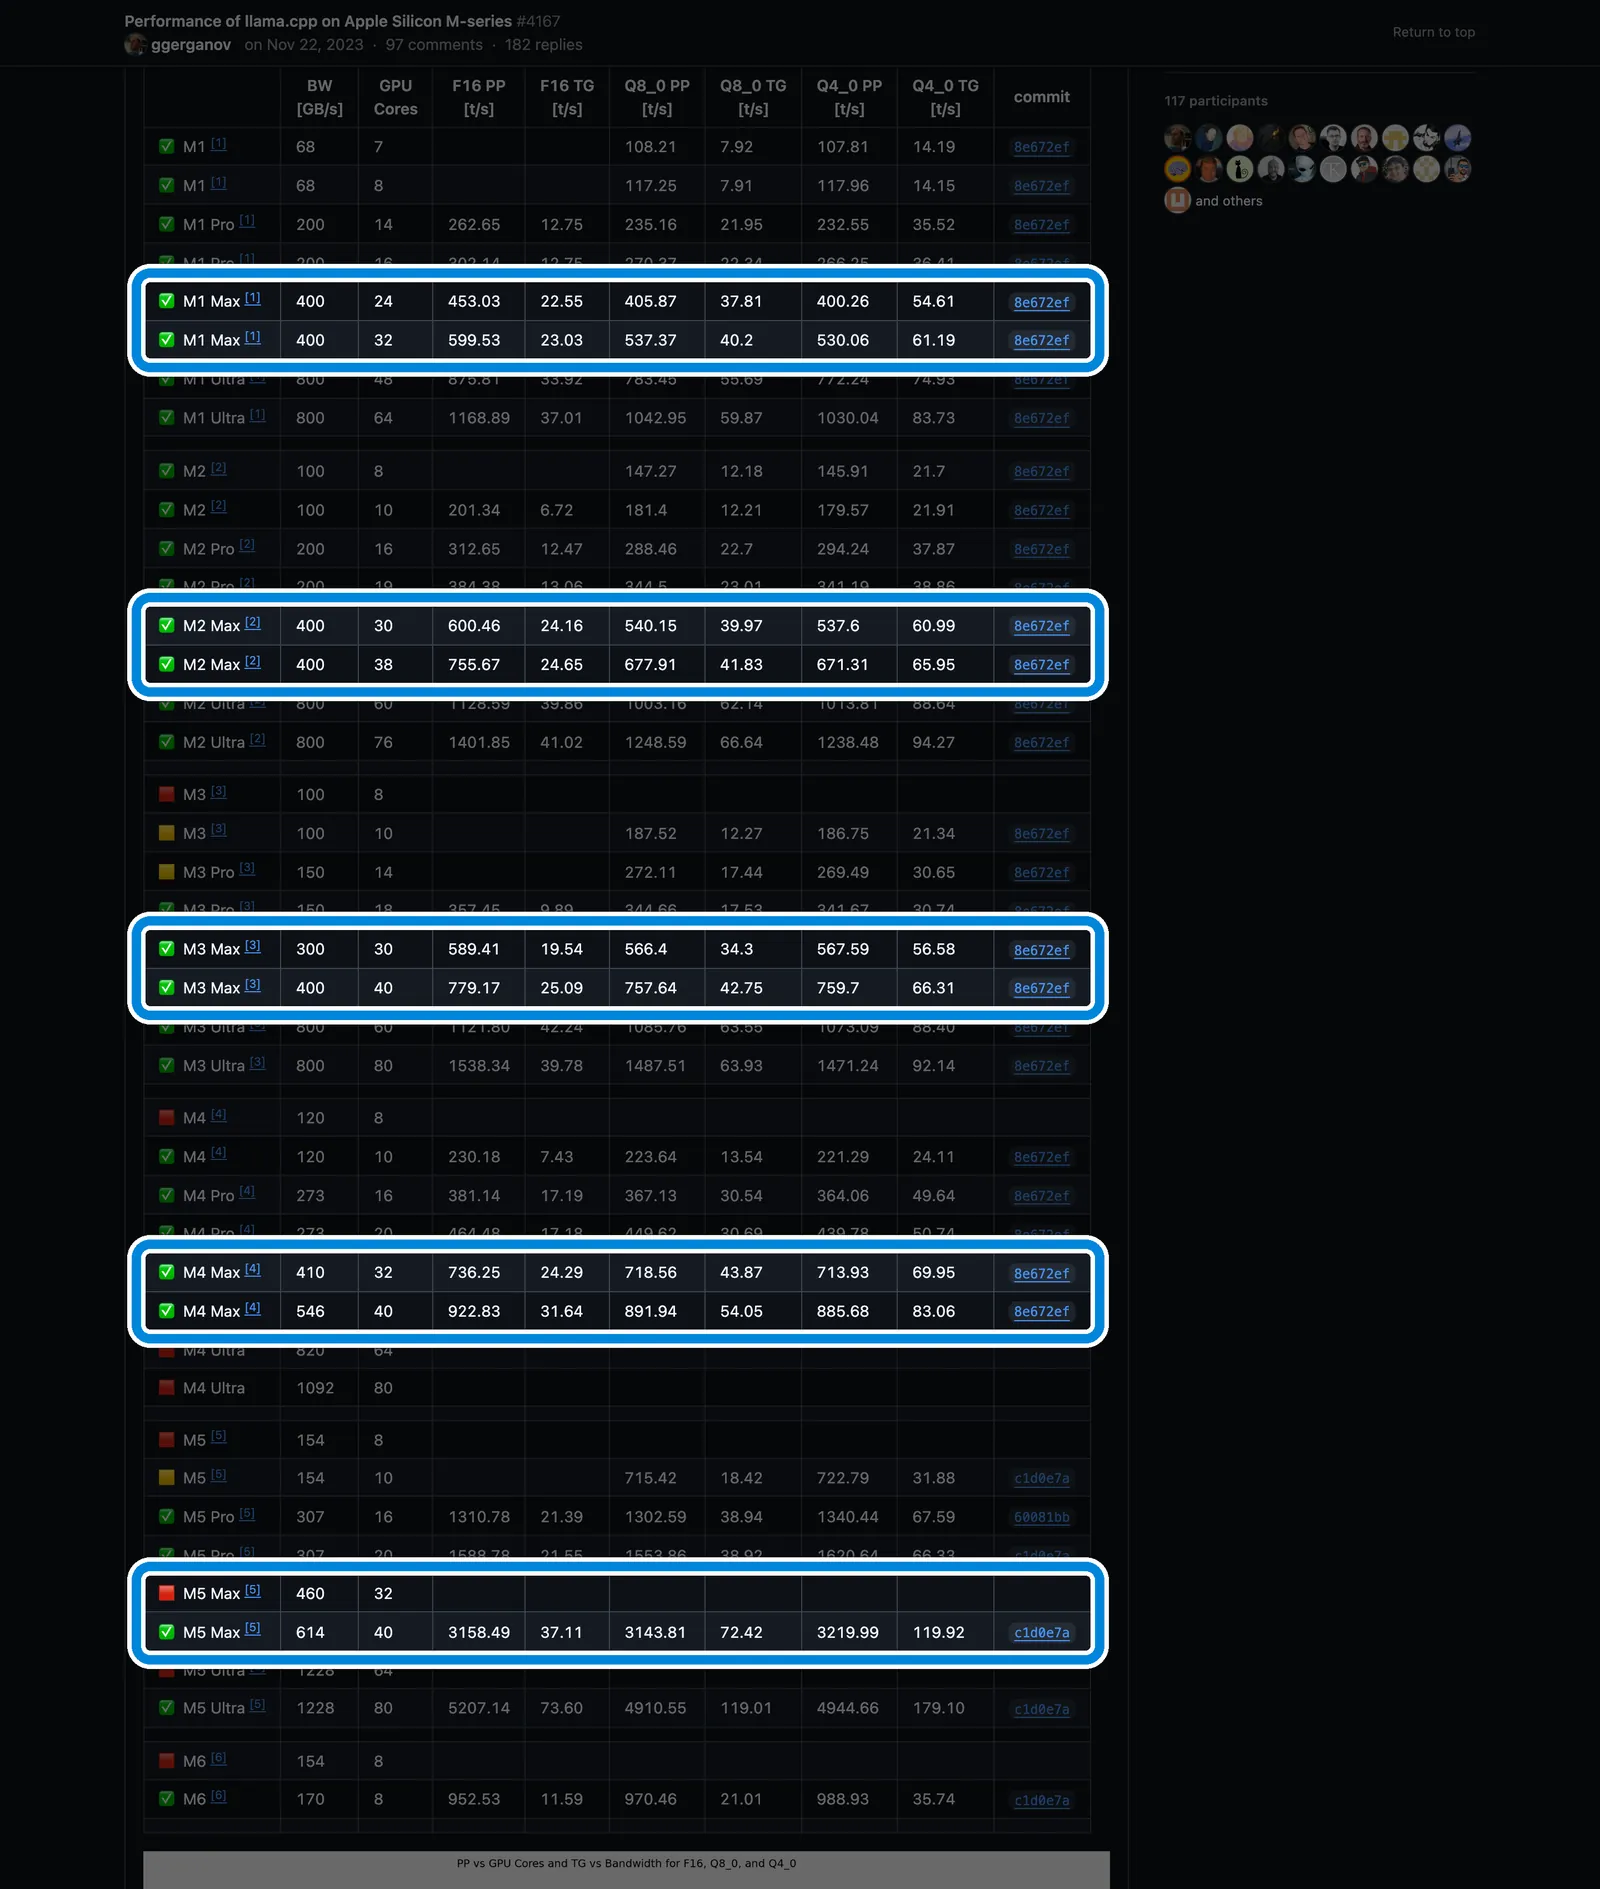
На скриншоте таблицы (снято 25 октября 2026 года) рамками выделены строки Max. Обратите внимание на последнюю колонку commit: у M1–M4 Max стоит сборка 8e672ef 2023 года, а у M5 Max — c1d0e7a 2026 года. Сравнивать эти строки напрямую нельзя: новая программа сама по себе быстрее.
Насколько — видно по M2 Ultra, который замерили на обеих сборках: генерация на одном и том же железе выросла с 94,27 до 125,21 ток/с, то есть в 1,33 раза, чтение промпта — в 1,20 раза. Если убрать этот софтовый прирост, сырые +44% у M5 Max над M4 Max превращаются в +9%. Поправка грубая: новую сборку на M2 Ultra гоняли с ускорением внимания Flash Attention, и неизвестно, совпадают ли настройки в строке M5 Max.
Вывод по графику: от M1 Max до M4 Max генерация на маленькой модели выросла всего с 61 до 83 ток/с, а младшая версия M3 Max (300 ГБ/с) даже медленнее M1 Max с 32-ядерным GPU. После поправки на версию программы M5 Max даёт около 90 ток/с — прирост к M4 Max соответствует росту полосы.Версия Max Полоса Генерация 7B Q4_0, ток/с (замер) С поправкой на сборку, ток/с M1 Max 24 GPU 400 ГБ/с 54,61 54,61 M1 Max 32 GPU 400 ГБ/с 61,19 61,19 M2 Max 30 GPU 400 ГБ/с 60,99 60,99 M2 Max 38 GPU 400 ГБ/с 65,95 65,95 M3 Max 30 GPU 300 ГБ/с 56,58 56,58 M3 Max 40 GPU 400 ГБ/с 66,31 66,31 M4 Max 32 GPU 410 ГБ/с 69,95 69,95 M4 Max 40 GPU 546 ГБ/с 83,06 83,06 M5 Max 32 GPU 460 ГБ/с н/д ≈ 76 (оценка) M5 Max 40 GPU 614 ГБ/с 119,92 (новая сборка) ≈ 90,3 (оценка)
Модель 70B: замеры, оценки и физический потолок
На маленькой модели все Max быстрые. Разница становится болезненной на больших моделях. Для Llama 70B в кванте Q4_K_M (42,5 ГБ) есть два реальных замера мая 2024 года: M1 Max с 32-ядерным GPU и 64 ГБ — 4,09 ток/с, M3 Max с 40-ядерным GPU — 7,53 ток/с. Для остальных версий — оценка по формуле.
| Версия Max | Память | Потолок, ток/с (оценка) | Скорость 70B Q4_K_M, ток/с |
|---|---|---|---|
| M1 Max 32 GPU | 64 ГБ | 9,4 | 4,09 (замер) |
| M2 Max 38 GPU | 64 / 96 ГБ | 9,4 | ≈ 5,6–7,5 (оценка) |
| M3 Max 30 GPU | 96 ГБ | 7,1 | ≈ 4,2–5,6 (оценка) |
| M3 Max 40 GPU | 64 / 128 ГБ | 9,4 | 7,53 (замер) |
| M4 Max 32 GPU | 36 ГБ | — | не влезает |
| M4 Max 40 GPU | 64 / 128 ГБ | 12,8 | ≈ 7,7–10,3 (оценка) |
| M5 Max 32 GPU | 36 ГБ | — | не влезает |
| M5 Max 40 GPU | 64 / 128 ГБ | 14,4 | ≈ 8,7–11,6 (оценка) |
В обзорах M5 Max встречаются цифры «22–32 ток/с» и «18–28 ток/с» для 70B в 4 битах. Это не замеры, а расчёты, и при обычной генерации они выше физического потолка: 614 ГБ/с ÷ 42,5 ГБ = 14,4 ток/с. Чтобы выйти за этот предел, программа должна выдавать больше одного токена за один проход по весам — так работает, например, спекулятивное декодирование, когда маленькая модель-помощник угадывает слова, а большая их проверяет.
В независимом замере на MacBook Pro 16 с M5 Max и 128 ГБ (BestLLMfor, 16 сентября 2026 года) плотная Qwen 3.8 27B в формате GGUF дала 36,6 ток/с — у самого потолка 614 ÷ 17 ≈ 36 (часть файла, например таблица словаря, на каждом токене целиком не читается, поэтому замер может вплотную подойти к расчёту). Та же модель в MLX, библиотеке Apple для своих чипов, по данным источника показала 68,0 ток/с — вдвое выше потолка: чтобы прочитывать 18 ГБ весов на каждый токен с такой скоростью, нужна полоса около 1,2 ТБ/с, а у чипа 614 ГБ/с. Так бывает, только если программа выдаёт больше одного токена за проход по весам. Вероятная причина — многотокенное предсказание (MTP), для которого у Qwen 3.8 есть встроенные головы, но авторы замера её не называют, и это пока не подтверждено. Поэтому цифру 68 ток/с считаем непроверенной заявкой одного источника. Без таких приёмов планка для плотной 70B на M5 Max — 9–11 ток/с; всё сверх зависит от программы и модели, а не от чипа. Как одна и та же модель ведёт себя в разных программах, мы разбирали в сравнении Ollama, LM Studio и llama.cpp.
Тот же замер показывает, что M5 Max со 128 ГБ на самом деле хорошо тянет:Модель на M5 Max 40 GPU, 128 ГБ Формат Вес Генерация, ток/с (замер) Gemma 4 12B GGUF Q4 7,6 ГБ 58,1 Qwen 3.8 27B GGUF Q4 17 ГБ 36,6 Qwen 3.8 27B MLX 18 ГБ 68,0 (выше потолка полосы, причина не подтверждена — вероятно, MTP) gpt-oss 20B (MoE) MXFP4 13 ГБ 113,4 gpt-oss 120B (MoE) MXFP4 65 ГБ 75,5–79,1 Qwen 3.6 35B-A3B (MoE) MLX 23 ГБ 167,2
Вывод из таблицы: на Max выгоднее всего работают MoE-модели. Модель на 120 миллиардов параметров печатает почти 80 ток/с, потому что на каждый токен читает из памяти только активную часть. Подробный разбор именно этого ноутбука — в материале про MacBook Pro M5 Max для нейросетей.
Чтение промпта у Max: M5 Max втрое быстрее M4 Max
Чтение промпта (prompt processing, prefill) — это время, которое модель тратит на ваш запрос до первого слова ответа. На коротком вопросе его не видно. Но когда вы отдаёте модели договор на 40 страниц, кодовую базу или длинную переписку агента, ожидание считается уже минутами. Здесь работает не полоса памяти, а вычислительная мощность GPU — и именно сюда Apple поставила нейроускорители M5.
Самый показательный benchmark пары M4 Max vs M5 Max — та же таблица llama.cpp: 885,68 ток/с у M4 Max против 3219,99 ток/с у M5 Max. Сырая разница — в 3,6 раза. После поправки на новую сборку программы (на M2 Ultra она дала ×1,20) остаётся примерно в 3,0 раза. Это крупнейший прирост поколения для ИИ.
На графике видно, как ровно росли M1–M4 Max: каждое поколение прибавляло 13–27%. M5 Max выбивается из ряда: к M4 Max — примерно втрое, к M1 Max с 32-ядерным GPU — примерно в 5 раз (оценка после поправки на версию программы).Версия Max Чтение промпта 7B Q4_0, ток/с (замер) С поправкой на сборку, ток/с M1 Max 24 / 32 GPU 400,26 / 530,06 400,26 / 530,06 M2 Max 30 / 38 GPU 537,6 / 671,31 537,6 / 671,31 M3 Max 30 / 40 GPU 567,59 / 759,7 567,59 / 759,7 M4 Max 32 / 40 GPU 713,93 / 885,68 713,93 / 885,68 M5 Max 40 GPU 3219,99 (новая сборка) ≈ 2679 (оценка)
Как это выглядит на большой модели: в замере BestLLMfor gpt-oss 120B на M5 Max прочитала документ на 16 689 токенов (около 45 страниц) со скоростью 1 388 ток/с — 12 секунд до начала ответа. Для сравнения, у M3 Max с 40-ядерным GPU в замере мая 2024 года модель 70B читала промпт со скоростью 62,88 ток/с — тот же объём текста занял бы у неё около 4,4 минуты (оценка; модели разные, поэтому это порядок величин, а не точное сравнение).
В обзорах встречается и цифра «в 4,5 раза быстрее». В первоисточнике это проекция, а не замер. Apple для Mac Studio с M5 Max заявляет «до 3,9 раза» в LM Studio — это заявка производителя на его собственном сценарии; независимый замер даёт около 3,0.
Генерация картинок и транскрипция: что измерено, а что оценка
Для генерации изображений (Flux, Stable Diffusion XL) и распознавания речи (Whisper) независимых замеров по всем версиям Max в одинаковых условиях найти не удалось. Поэтому этот раздел короче, чем про текст: чисел «секунд на картинку» по бинам мы не приводим.Задача Что известно Статус Генерация картинок, M4 Max Nvidia GB10 (DGX Spark) сохраняет большое преимущество над M4 Max (Tom’s Hardware) качественный вывод теста Генерация картинок, M5 Max против M4 Max Apple: до 3,5 раза быстрее (Mac Studio) заявка производителя Рендер на GPU без нейроускорителей Blender: M5 Max быстрее M4 Max в 1,39 раза замер Секунды на изображение по бинам Max — н/д Whisper по бинам Max — н/д
Что из этого следует на практике:
- Генерация картинок нагружает вычисления GPU, а не только память, поэтому разница между поколениями здесь больше, чем в генерации текста. Грубый ориентир снизу — +39% M5 Max к M4 Max на рендере (Blender нейроускорители не использует), ориентир сверху — заявка Apple ×3,5.
- Если картинки и видео-нейросети — основная работа, Mac с Max уступает видеокартам Nvidia: большинство инструментов написано под CUDA. Как выглядит этот разрыв на одной задаче, мы разбирали в сравнении DGX Spark, Mac Studio и Strix Halo.
- Транскрипция речи моделями класса Whisper не требует много памяти, поэтому для неё хватает любого Max, включая M1 Max с 32 ГБ.
CPU и GPU Max в тестах: Blender, Geekbench и Cinebench
Для сквозного сравнения всех поколений нужен тест, в котором есть все пять чипов и одна методика. Лучше всего на эту роль подходит база Blender Open Data: медианный результат пользовательских прогонов в одной версии Blender (5.2) — и для процессора, и для графики Metal. Цифры ниже — в разделе Benchmarks → Query с фильтром Metal (или CPU), версия 5.2.0, группировка по устройству.
Графика: Blender Metal и Geekbench 7
На графике виден ступенчатый рост. С M1 Max на M2 Max графика выросла в 1,6 раза, с M2 Max на M3 Max — в 2,5 раза (аппаратная трассировка лучей), дальше — в 1,33 раза к M4 Max и в 1,39 раза к M5 Max. Младший M5 Max с 32-ядерным GPU в Blender на 10% быстрее старшего M4 Max с 40 ядрами, но в Geekbench 7 Metal — на 6% медленнее.Версия Max Blender 5.2 Metal, баллов (медиана) Число прогонов в базе Geekbench 7 Metal, баллов (Geekbench Browser) M1 Max 24 / 32 GPU 834,6 / 1084,4 50 / 14 н/д (бины не разделены) M2 Max 30 / 38 GPU 1442,8 / 1743,1 4 / 10 н/д / 139 943 M3 Max 30 / 40 GPU 3613,5 / 4431,8 4 / 6 132 358 / 163 661 M4 Max 32 / 40 GPU 4876,1 / 5874,1 39 / 18 170 277 / 207 545 M5 Max 32 / 40 GPU 6461,9 / 8156,3 11 / 88 194 751 / 240 333
У части версий в базе Blender мало прогонов (у 30-ядерных M2 Max и M3 Max — по четыре), поэтому их цифры менее надёжны. Прирост M5 Max к M4 Max по GPU зависит от теста: Apple заявляет до +20%, Geekbench 7 по базе Geekbench Browser даёт +16%, лабораторный замер Notebookcheck в Geekbench 6.7 (другая версия теста и своя шкала баллов) — +24%, Cinebench 2024 GPU в обзоре Macworld — +32%, Blender — +39%.
Процессор: Blender CPU, Cinebench 2026 и Geekbench 7
| Чип (старший CPU-бин) | Blender CPU, баллов (бины M3/M4 Max не разделены) | Cinebench 2026, все ядра | Geekbench 7, все ядра | Geekbench 7, одно ядро |
|---|---|---|---|---|
| M1 Max, 10 ядер | 201,4 | 3300 | 14 226 | 2221 |
| M2 Max, 12 ядер | 244,4 | 4150 | 17 020 | 2491 |
| M3 Max, 16 ядер | 333,9 | 6140 | 24 512 | 2811 |
| M4 Max, 16 ядер | 403,8 | 7920 | 28 741 | 3349 |
| M5 Max, 18 ядер | 584,9 | 9194 | 34 585 | 3693 |
Многоядерная мощность Max за пять поколений выросла в 2,4–2,9 раза, одноядерная — в 1,7 раза. M5 Max к M4 Max прибавляет +10% в одном ядре, +16% в Cinebench 2026, +20% в Geekbench 7 (все ядра) и +45% в длинном рендере Blender. Последняя цифра завышена: база Blender не делит процессоры M3 Max и M4 Max по числу ядер, и в их медиану попадают младшие 14-ядерные версии. Лабораторный замер Notebookcheck осторожнее: +10–14% в Geekbench 6.7, а Apple заявляет «до 15%». Баллы Geekbench 6 и Geekbench 7 в одну шкалу не ставим — это разные версии теста.
Монтаж, 3D и игры: где M5 Max не обгоняет M4 Max
Для видеомонтажа у Max главное — не ядра, а медиадвижки: аппаратные блоки, которые кодируют и декодируют видео без нагрузки на процессор. Два видеокодера и два движка ProRes есть у всех Max, начиная с M1. Поэтому разница между поколениями в экспорте меньше, чем в рендере.
Что показали тесты Macworld на MacBook Pro 16 (обзор от 9 марта 2026 года):
- Экспорт в ProRes — M5 Max и M4 Max одинаковы.
- HandBrake, кодирование в H.265 — без разницы.
- iMovie, экспорт 4K в режиме High — M5 Max быстрее на 14%.
- SSD — у M5 Max примерно вдвое быстрее, до 14,5 ГБ/с по данным Apple. Для монтажа с большими исходниками это самый заметный выигрыш поколения: в обзоре Mac Studio Macworld пишет, что из-за SSD владельцам Mac Studio с M4 Max, которые работают в продакшене, стоит всерьёз подумать об апгрейде.
Для 3D всё наоборот: рендер на GPU в Blender у M5 Max на 39% быстрее, чем у M4 Max, а при трассировке лучей Apple заявляет до +30% к графике. И стоит помнить, что для 3D самый большой шаг сделал M3: старшие M1 Max и M2 Max рендерят в Blender на GPU в 3,4–7,5 раза медленнее старших M4 Max и M5 Max.
Игры. По тестам Notebookcheck в Cyberpunk 2077, Baldur’s Gate 3 и Assassin’s Creed Shadows M5 Max быстрее M4 Max на 8–24% и обычно идёт на уровне или чуть позади ноутбучной GeForce RTX 5070. В синтетике 3DMark Wild Life Extreme у M5 Max 43 222 балла в 16-дюймовом корпусе и 39 389 в 14-дюймовом против 34 613 у M4 Max. Для игр Max — приятный бонус к рабочей машине: переходить с M4 Max на M5 Max ради 8–24% FPS смысла мало.
Macworld в обзоре Mac Studio формулирует итог по рабочим задачам так: прирост M4 Max над M2 Max был «значительно больше», чем M5 Max над M4 Max.
Слабые места Max: корпус 14 дюймов, шина M3 Max и цена памяти
Сравнение Max по таблицам характеристик упускает несколько ловушек. Каждая из них стоит денег.
- M5 Max в 14 дюймах — слабее, чем в 16. По замерам Notebookcheck 14-дюймовый MacBook Pro с трудом держит 50 Вт на процессоре, а 16-дюймовый держит 62 Вт. В многоядерном Cinebench 2024 это 2073 балла против 2437, а в творческих тестах PugetBench, по данным той же лаборатории, 16-дюймовый быстрее примерно на 15%. Плюс базовый 14-дюймовый M5 Max за $3,599 идёт с урезанным 32-ядерным GPU и полосой 460 ГБ/с; полная версия на 614 ГБ/с — в 16-дюймовом от $3,899 или за доплату.
- Младшая версия M3 Max — урезанная шина. У 14-ядерного M3 Max включены 24 из 32 контроллеров памяти, отсюда 300 ГБ/с — меньше, чем у любой версии M1 Max и M2 Max. Для генерации текста б/у M3 Max 14/30 медленнее б/у M1 Max с 32-ядерным GPU.
- Младшие M4 Max и M5 Max — только 36 ГБ. Память в Mac распаяна в одном корпусе с чипом, докупить её потом нельзя. С 36 ГБ модель 70B не запустится никогда.
- Mac Studio с M4 Max: потолок памяти сменился за время продаж. На старте в 2025 году старший M4 Max в Mac Studio предлагался с 48, 64 или 128 ГБ — так до сих пор написано на странице характеристик Apple. По данным Tom’s Hardware на 30 июля 2026 года, новый Mac Studio со старшим M4 Max продавался уже максимум с 64 ГБ за $5,299. У Mac Studio с M5 Max, представленного 25 августа 2026 года (в продаже с 22 сентября), потолок снова 128 ГБ. Перед покупкой проверяйте конфигуратор на дату заказа.
- Цифры производителя и обзоров надо делить на тип теста. «До 4x для ИИ» у Apple — пиковые вычисления GPU, а не скорость генерации. Генерация текста растёт с полосой памяти, то есть на 12%, а не в разы.
Б/у M1 Max и M2 Max против нового M4 и M5 Max для ИИ
Для тех, кто под локальный ИИ сравнивает M1 Max vs M4 Max vs M5 Max, главный вопрос — сколько стоит каждая единица того, что реально влияет на скорость и размер модели: гигабайт памяти и гигабайт в секунду полосы. Посчитаем это по ценам в Украине на 25 октября 2026 года.
Формула простая: цена ÷ полоса (сколько гривен стоит 1 ГБ/с) и цена ÷ объём памяти (сколько стоит 1 ГБ под модель). Это наш расчёт по ценам ниже, а не тест.Конфигурация (25.10.2026) Цена, грн Полоса Память грн за 1 ГБ/с грн за 1 ГБ MacBook Pro 16, M1 Max 32 ГБ, б/у (OLX, медиана) 66 500 400 ГБ/с 32 ГБ 166 2078 MacBook Pro 16, M2 Max 38 GPU 32 ГБ, б/у (OLX, медиана) 65 400 400 ГБ/с 32 ГБ 164 2044 MacBook Pro 16, M1 Max 64 ГБ, б/у (Jabko, гарантия) 95 550 400 ГБ/с 64 ГБ 239 1493 MacBook Pro 16, M3 Max 40 GPU 48 ГБ, б/у (OLX, медиана) 124 800 400 ГБ/с 48 ГБ 312 2600 MacBook Pro 16, M4 Max 48 ГБ, новый (hotline, медиана) 171 403 546 ГБ/с 48 ГБ 314 3571 MacBook Pro 16, M5 Max 48 ГБ, новый (hotline, медиана) 214 794 614 ГБ/с 48 ГБ 350 4475 MacBook Pro 16, M5 Max 128 ГБ, новый (Jabko) 369 199 614 ГБ/с 128 ГБ 601 2884
Что видно из расчёта:
- Самый дешёвый гигабайт памяти — у б/у M1 Max на 64 ГБ: около 1 500 грн за ГБ, вдвое дешевле нового M4 Max и втрое дешевле нового M5 Max на 48 ГБ. Модель 70B в 4 битах на нём работает (замер — 4,09 ток/с), а модели до 27B и MoE вроде gpt-oss 20B — комфортно.
- Самая дешёвая полоса — у б/у M1 Max и M2 Max на 32 ГБ, но 32 ГБ — это потолок для моделей примерно до 27B в 4 битах.
- Б/у M3 Max на 48 ГБ — неудачная середина: та же полоса 400 ГБ/с, что у M1 Max, памяти меньше, чем у M1 Max на 64 ГБ, а цена выше. Для ИИ его стоит брать только со 128 ГБ.
- Новый M5 Max со 128 ГБ дорог в абсолюте, но за гигабайт памяти обходится дешевле, чем M4 Max и M5 Max на 48 ГБ. Это единственный вариант из списка, где помещается 70B в 8 битах.
Что вы теряете, выбирая б/у M1 Max вместо нового M5 Max: чтение промпта примерно в 5 раз медленнее, графику без трассировки лучей, медленный SSD, гарантию производителя и, возможно, изношенную батарею. Если нужен самый дешёвый вход в локальный ИИ без большой модели, посмотрите и на Mac Mini M4 Pro для нейросетей.
Цены в Украине на 25 октября 2026: новые и б/у Mac с Max
Цены на Mac в Украине сильно разнятся между магазинами, поэтому ниже — медиана предложений: половина продавцов дешевле, половина дороже. Новые — по каталогу hotline.ua, б/у — по частным объявлениям OLX и магазину Jabko с гарантией. Все цены — на 25 октября 2026 года; это первое, что в статье устареет.
| Конфигурация | Состояние | Цена на 25.10.2026, грн | Где |
|---|---|---|---|
| MacBook Pro 16, M2 Max 38 GPU, 32 ГБ / 1 ТБ | б/у | 65 400 (медиана; от 56 250) | OLX |
| MacBook Pro 16, M1 Max 32 GPU, 32 ГБ / 1 ТБ | б/у | 66 500 (медиана; от 56 500) | OLX |
| MacBook Pro 16, M1 Max 32 GPU, 32 ГБ / 1 ТБ | б/у с гарантией | 79 625 | Jabko |
| MacBook Pro 16, M1 Max 32 GPU, 64 ГБ / 1 ТБ | б/у с гарантией | 95 550–100 100 | Jabko |
| MacBook Pro 14/16, M3 Max 30 GPU, 36 ГБ / 1 ТБ | б/у | 100 000 (медиана) | OLX |
| MacBook Pro 16, M3 Max 40 GPU, 48 ГБ / 1 ТБ | б/у | 124 800 (медиана) | OLX |
| Mac Studio, M2 Max 30 GPU, 32 ГБ / 512 ГБ | новый, остатки | 80 399 | Jabko |
| Mac Studio, M5 Max 32 GPU, 36 ГБ / 512 ГБ | новый | 159 550 (медиана; от 127 529) | hotline |
| MacBook Pro 14, M5 Max 32 GPU, 36 ГБ / 2 ТБ | новый | 170 516 (медиана; от 156 176) | hotline |
| MacBook Pro 16, M4 Max 40 GPU, 48 ГБ / 1 ТБ | новый | 171 403 (медиана; от 151 135) | hotline |
| MacBook Pro 16, M5 Max 40 GPU, 48 ГБ / 2 ТБ | новый | 214 794 (медиана; от 201 363) | hotline |
| Mac Studio, M4 Max 40 GPU, 64 ГБ / 512 ГБ | новый | 223 997 (медиана) | hotline |
| Mac Studio, M5 Max 40 GPU, 64 ГБ / 1 ТБ | новый | 247 477 (медиана) | hotline |
| MacBook Pro 16, M5 Max 40 GPU, 128 ГБ / 2 ТБ | новый | 369 199 | Jabko |
Несколько оговорок к таблице. MacBook Pro 16 с M4 Max на 48 ГБ на 25 октября 2026 года у Jabko значится «нет в наличии» (последняя цена 195 999 грн), у Foxtrot — тоже нет в наличии по 249 999 грн, хотя в каталоге hotline.ua на ту же дату 18 предложений от 151 135 грн. Новый MacBook Pro 16 с M2 Max на 96 ГБ у Jabko распродан (последняя цена 187 999 грн). По б/у M4 Max и M5 Max сопоставимых предложений на эту дату нет — н/д.
Для сравнения со стартовыми ценами Apple в США: MacBook Pro 14 с M5 Max — от $3,599, 16-дюймовый — от $3,899, Mac Studio с M5 Max — от $2,499. Mac Studio с M5 Max на 36 ГБ у Jabko 25 октября 2026 года стоил 151 599 грн, или 3 332 доллара по курсу магазина, — примерно на треть дороже американской цены без налога.
Какой Max выбрать: M1, M2, M3, M4 или M5 под вашу задачу
Выбор M3 Max vs M4 Max vs M5 Max, а заодно более ранних M1 Max и M2 Max, сводится к четырём вопросам. Идите по шагам — первый ответ «да» и есть ваш выбор.
- Нужны модели 70B и больше или MoE на 120B? Смотрите только версии с 64 ГБ и больше. Лучшее соотношение цены и объёма — б/у M1 Max или M2 Max на 64–96 ГБ; лучшая скорость и запас — M5 Max со 128 ГБ. Если и 128 ГБ мало, это уже уровень Mac Studio M5 Ultra для LLM.
- Работаете с длинными документами, кодом и агентами? Берите M5 Max: чтение промпта у него примерно втрое быстрее, чем у M4 Max, и это экономит минуты на каждом длинном запросе. Младшая версия на 36 ГБ подходит только под модели до ~27B.
- Основная работа — 3D, рендер, игры? Минимум — M3 Max (аппаратная трассировка лучей); M4 Max и M5 Max быстрее его в Blender в 1,3 и 1,8 раза соответственно. M1 Max и M2 Max для 3D сегодня — компромисс.
- Основная работа — монтаж ProRes и H.265? Переплачивать за M5 Max ради экспорта не нужно: в ProRes и HandBrake он не быстрее M4 Max. Решают объём SSD и память под таймлайн; M5 Max выигрывает скоростью диска.
Короткие правила для частых ситуаций:
- Есть M1 Max или M2 Max на 64 ГБ — менять стоит, только если упираетесь в чтение длинных промптов или в 3D. Для генерации текста прирост M5 Max — около полутора раз по полосе (400 → 614 ГБ/с).
- Есть M4 Max — ради генерации текста на M5 Max переходить нет смысла (+9–12%); ради чтения промпта, GPU-рендера и SSD — есть.
- Выбираете ноутбук M5 Max — берите 16 дюймов: он держит мощность дольше и с завода идёт с полной 40-ядерной версией.
- Не берите для ИИ младшие M4 Max и M5 Max на 36 ГБ и б/у M3 Max 14/30 — первые упираются в объём, второй — в урезанную шину.
FAQ
Чем M5 Max отличается от M4 Max для локальных нейросетей?
Генерация текста у M5 Max быстрее примерно на 9–12% — столько же, на сколько выросла полоса памяти (546 → 614 ГБ/с). Главная разница в чтении промпта: в тесте llama.cpp M5 Max обрабатывает запрос примерно втрое быстрее M4 Max даже после поправки на версию программы. Объём памяти у старших версий одинаковый — до 128 ГБ.
Сколько памяти нужно Mac с Max для модели 70B?
Для 70B в кванте Q4_K_M файл весит 42,5 ГБ, а GPU может занять около 75–78% памяти, поэтому минимум — 64 ГБ. Для 70B в 8 битах (около 75 ГБ) нужно 128 ГБ. Версии M4 Max и M5 Max на 36 ГБ модель 70B не запускают вовсе. Добавьте запас под длинный контекст.
Стоит ли покупать б/у MacBook Pro с M1 Max в 2026 году?
Да, если цель — недорогой ноутбук для локальных моделей до 27B и MoE и нужна память на 64 ГБ. У него та же полоса 400 ГБ/с, что у старшего M3 Max, а цена в Украине на 25 октября 2026 года — от 95 550 грн с гарантией магазина. Минусы — медленное чтение промпта, нет трассировки лучей, износ батареи.
Какой Max быстрее для видео — M4 Max или M5 Max?
В экспорте ProRes и кодировании H.265 в HandBrake тесты Macworld разницы между ними не нашли, в экспорте 4K из iMovie M5 Max быстрее на 14%. Заметный выигрыш M5 Max — SSD примерно вдвое быстрее, до 14,5 ГБ/с. Если вы монтируете и не работаете с 3D, хорошо настроенный M4 Max почти не уступает.
Почему у M3 Max две разные пропускные способности памяти?
У младшей версии M3 Max с 14-ядерным CPU и 30-ядерным GPU Apple включила 24 из 32 контроллеров памяти, поэтому полоса — 300 ГБ/с. У старшей 16-ядерной версии работают все контроллеры — 400 ГБ/с. В итоге младший M3 Max генерирует текст медленнее M1 Max с 32-ядерным GPU (56,6 против 61,2 ток/с в llama.cpp), хотя он на два года новее.
Хватит ли M2 Max с 64 ГБ для локального ИИ?
Хватит для большинства домашних задач: модели до 27B, MoE вроде gpt-oss 20B и Qwen 35B-A3B, а также 70B в 4 битах — по оценке, около 5,6–7,5 ток/с. Не поместятся gpt-oss 120B и 70B в 8 битах — для них нужна версия с 96 или 128 ГБ. Полоса у M2 Max — 400 ГБ/с, как у M1 Max.